用Java手写MCP与代理循环,追踪工具调用
作者使用Java和Spring Boot自行实现MCP服务端、客户端及代理循环,不依赖AI框架或MCP SDK。案例通过Ollama运行本地Qwen 2.5 7B,完整追踪自然语言请求如何转为笔记文件操作。
AI 深度解读
让本地模型往笔记里加一句「buy milk」,真正写文件的到底是谁?作者用 Java 和 Spring Boot,从头搭了一个没有 AI 框架、没有 MCP SDK 的 Agent,把模型推理、工具发现、文件写入和结果回传逐步拆开。
这篇最有用的结论是:工具调用不是模型获得了操作系统权限,而是应用接住模型的请求,再执行代码。理解这条边界,能帮助我们排查 AI 编程工具的问题,也能判断自己的应用是否真的需要 MCP。不过,文中的协议版本说法需要单独审视。
一次写文件,为什么要分成三个进程
作者的系统只有三个角色:local_agent 在端口 8081 运行,负责保存对话、调用模型和调度工具;Ollama 在端口 11434 提供模型推理;mcp_server 在端口 8080 提供工具,独占笔记文件 data/db 的读写。
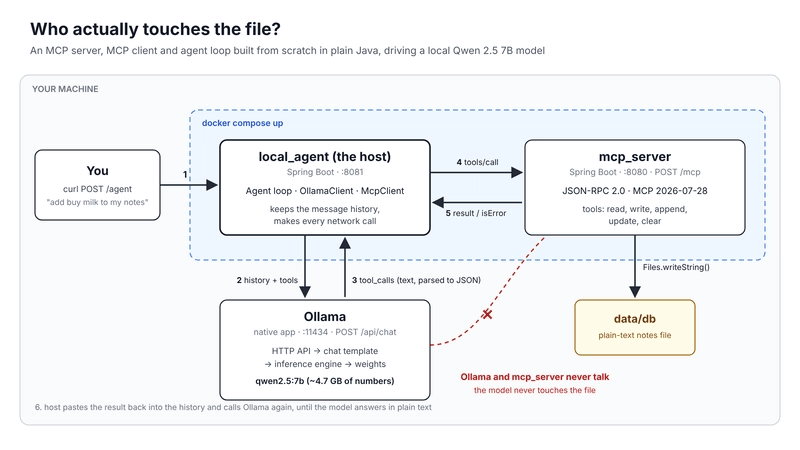
模型使用 Qwen 2.5 7B,通过 ollama pull qwen2.5:7b 下载,权重约 4.7 GB。作者给出的内存要求是至少 8 GB RAM,16 GB 更从容。这是项目运行建议,原文没有提供硬件对照测试。
部署时,Docker Compose 运行 Host 和 MCP Server,Ollama 原生安装以使用本机 GPU。Linux 下还需设置 OLLAMA_HOST=0.0.0.0,让容器能够访问它。两个仓库准备好后,在 local_agent 中执行 docker compose up --build;使用 Docker 时不必另装 Java。
这里要分清模型、推理服务和应用。权重需要推理程序加载,Ollama 把推理能力包装成 API;Host 再在 API 上组织历史消息和工具调用。作者用 ChatGPT 与 OpenAI API 的关系帮助理解:调用 API 后,对话界面、历史和执行循环仍然需要应用实现。
模型提出调用请求,Host 才是执行动作的控制点。
用户要求追加笔记后,Host 先通过 tools/list 获取工具,再向 Ollama 的 POST /api/chat 提交消息及工具定义。模型选择 append,返回 content: "buy milk" 参数。Host 调用 MCP Server,收到结果后,把它作为 role: "tool" 消息重新交给模型,最后才生成完成提示。
作者统计,这次操作涉及三个进程、七次 HTTP 调用,其中两次是模型交互。不过原文的步骤编号和计数边界没有完整解释,七次应当视为这个项目的链路记录,不能当成所有 Agent 的固定开销。
Function calling 和 MCP 各管哪一段
Function calling 解决模型一侧的问题:应用描述有哪些函数,模型返回想调用哪个函数、参数是什么。
MCP 解决工具一侧的问题:Host 如何发现另一个服务提供的工具,再按统一方式调用。两者可以配合,但工具调用并不依赖 MCP。工具只供一个应用使用时,直接在应用内注册函数也能完成闭环。
作者指出,不同模型接口的数据形状仍有差别:文中使用的 OpenAI 接口把工具参数放在 JSON 字符串中,Ollama 返回 JSON 对象,Anthropic 使用 tool_use 内容块,而非 tool_calls。这些差异需要适配,MCP 并没有统一模型 API。
在这个项目里,MCP 工具的 inputSchema 和 Ollama 工具定义的 parameters 都使用 JSON Schema,因此作者用一次 map() 完成转换。
更直观的一层,是模型究竟看到了什么。执行 ollama show qwen2.5:7b --template,可以查看工具定义如何被渲染进提示词;用 OLLAMA_DEBUG=1 启动 Ollama,可以观察完整提示。这个模型生成的调用文本形如:
<tool_call>{"name":"append","arguments":{"content":"buy milk"}}</tool_call>
随后由 Ollama 解析成结构化的 tool_calls。这说明了作者使用的模型和模板如何工作,但不宜据此断言所有模型服务内部都采用相同文本格式。
文中服务提供五个工具:read 返回整个文件,write(content) 覆盖文件,append(content) 追加内容,update(search, replace) 查找替换,clear 清空文件。
作者给出的线上请求如下,用来展示 Host 如何把模型的选择转成协议调用:
POST /mcp
MCP-Protocol-Version: 2026-07-28
Mcp-Method: tools/call
Mcp-Name: append

{"jsonrpc":"2.0","id":2,"method":"tools/call","params":{"name":"append","arguments":{"content":"buy milk"},
 "_meta":{"io.modelcontextprotocol/protocolVersion":"2026-07-28","io.modelcontextprotocol/clientCapabilities":{}}}}
重点看 method、name 和 arguments:操作名、工具名及参数都在请求体里,而非分别对应 REST 路径。
但协议结论要加限定。作者声称 2026-07-28 规范采用无状态请求,取消 initialize 和 session ID,通过 params._meta 携带上下文,并把部分信息镜像到请求头。原文没有附规范依据,这里无法独立确认,不能直接把它当作通用接入规范。
同样,POST /mcp、GET 和 DELETE 返回 405,以及 server/discover、tools/list、tools/call 的组合,应先按作者项目展示的实现理解。实际接入时需要核对目标服务的协议版本和传输方式。
Agent 的可靠性,藏在循环和上下文里
作者的执行循环很短,却把职责交代得很清楚:
for (int step = 1; step <= properties.maxSteps(); step++) {
    Message reply = ollamaClient.chat(messages, tools);
    messages.add(reply); // 工具调用必须保留在历史中

    if (!reply.hasToolCalls()) {
        return new Result(reply.content(), invocations);
    }
    for (ToolCall call : reply.toolCalls()) {
        ToolInvocation invocation = invoke(call.function().name(), call.function().arguments());
        invocations.add(invocation);
        messages.add(Message.toolResult(call.function().name(), invocation.output()));
    }
}
throw new IllegalStateException("Agent did not finish within " + properties.maxSteps() + " steps");
注意 messages.add(reply):历史里要保留模型发出的调用请求,再追加工具结果。只塞回一个 Success,模型就缺少这条结果对应什么动作的上下文。
另一个限制是 agent.max-steps=5,防止模型持续调用工具而无法结束。Ollama 请求里的 stream: false 和 keep_alive: "30m" 则属于推理请求配置,不应与 Agent 的步数限制混为一谈。
工具描述也会影响文件安全。作者最初把 write 描述为写入全部内容,小模型可能把它选作追加工具。后来改成明确说明「替换整个文件;添加笔记请用 append」,以减少误选。这是作者的实践经验,原文没有给出修改前后的成功率。
错误反馈也参与下一轮推理。该实现把未知工具作为 JSON-RPC 协议错误处理,把缺参数、类型错误作为正常结果返回,并设置 isError: true。例如返回 Param (content) is required,让模型有机会修正参数。作者称小模型通常能在下一步修复,但没有提供量化数据。
同一条链路还解释了「让模型知道私有数据」:read 读出的笔记进入工具消息,再进入下一次推理上下文。数据没有因此写进模型权重。
直接粘贴资料、通过工具读取、用 RAG 检索片段,都是给当前推理补充材料;fine-tuning 则改变权重。把搜索能力暴露为 MCP 工具,再由 Agent 决定何时检索,是原文所说的 agentic RAG。
我的判断
这篇最值得借鉴的是拆分责任的方法。模型选错工具,就检查描述和输入;参数转换失败,就检查适配层;文件内容不对,就检查工具实现;执行成功但回答异常,就检查历史消息。比起把整条链路统称为「模型不稳定」,这种拆法更有助于定位问题。
但它首先是教学项目。只有一个文本文件、五个工具,原文没有展示并发写入、权限隔离、重试幂等性或故障恢复。max-steps 能限制循环,不能解决重复写入;更清楚的描述能降低误选概率,也不能替代 Host 的权限校验。
「记忆就是历史列表」也只适合解释这个实现。应用可以另外保存摘要和长期数据,推理服务也可能维护缓存或会话状态。关键是模型回答依赖哪些输入,而不是把所有系统的记忆机制都归结成同一个 Java 列表。
作者表示生产环境会用 Spring AI,以 @McpTool 等能力减少样板代码;计划中的 v2 才会逐行比较框架实现,v3 才涉及多文件和搜索。因此,原文证明了手写链路有学习价值,没有证明它比框架更可靠,也没有证明 MCP 比应用内函数更适合单个项目。
能拿来做什么
- 给 Node 或全栈应用接工具时,先完成「模型请求、参数校验、执行、结果回填、再次推理」的最小闭环,并保留每一步的日志,方便定位失败位置。
- 为 AI 编程场景提供文件操作时,把追加和覆盖拆成不同工具,并在 Host 中限制路径及写入权限;工具描述负责帮助模型选择,执行代码负责守住边界。
- 给助手接入项目文档时,先判断直接提供材料、按需读取还是 RAG 更合适。仅仅为了让它回答文档内容,不必先走 fine-tuning。
- 工具需要被多个应用或团队复用时,再评估 MCP;接入前核对实际协议版本,别把文章中的请求示例直接当成兼容性保证。