
8.0
热点
AI SCORE
编程提效2026-08-07 17:07
Unsloth 本地微调大模型:VRAM 减半、速度翻倍
dev.to · AI#Unsloth#LLM微调#本地部署
Editor brief · 编辑速览
Unsloth 通过 4-bit QLoRA 技术将 8B 模型微调 VRAM 需求降至 6GB,在 RTX 3060 上即可运行,速度提升 2 倍、显存节省 70%,MoE 模型加速达 12 倍。
过去,对 8B 参数的大语言模型(LLM)进行微调,需要使用 NVIDIA A100 等昂贵的企业级硬件。开发者常常焦虑的是,担心云算力额度耗尽之前训练任务能否跑完。Unsloth 彻底改变了这一格局。通过 4-bit QLoRA,8B 模型的微调过程现在仅需约 6 GB VRAM,在 RTX 3060 这类消费级 GPU 上即可实现高性能训练。
Unsloth 由两大核心组成:Unsloth Core(Python 库)和 Unsloth Studio(本地 Web 界面)。两者都使用了手写的 Triton 内核来优化训练循环的热点路径。这些优化带来了显著效果:训练速度提升至 2 倍,VRAM 占用减少 70%,对于混合专家(MoE)模型性能提升高达 12 倍,且不损失精度。截至 2026 年 7 月,当前版本为 v0.1.512-beta。
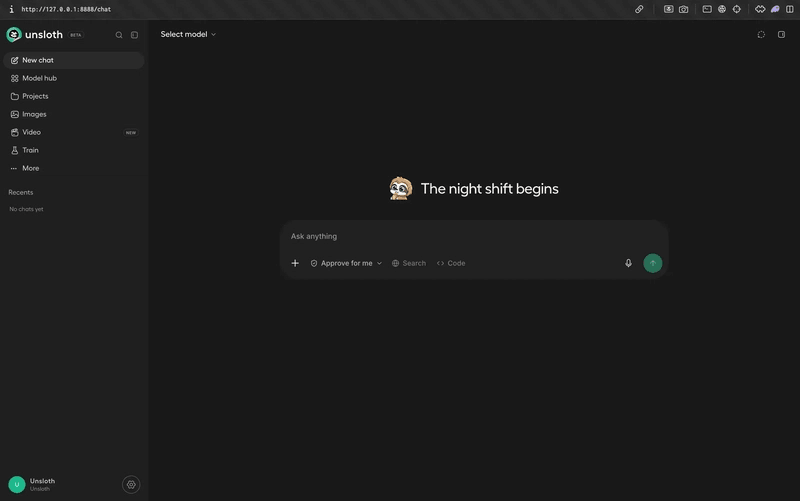
环境配置通过一条 shell 命令即可完成,该命令会创建 Python 环境、拉取 llama.cpp 后端并安装必要的启动二进制文件。
# macOS, Linux, WSL
curl -fsSL https://unsloth.ai/install.sh | sh

# Windows PowerShell
irm https://unsloth.ai/install.ps1 | iex
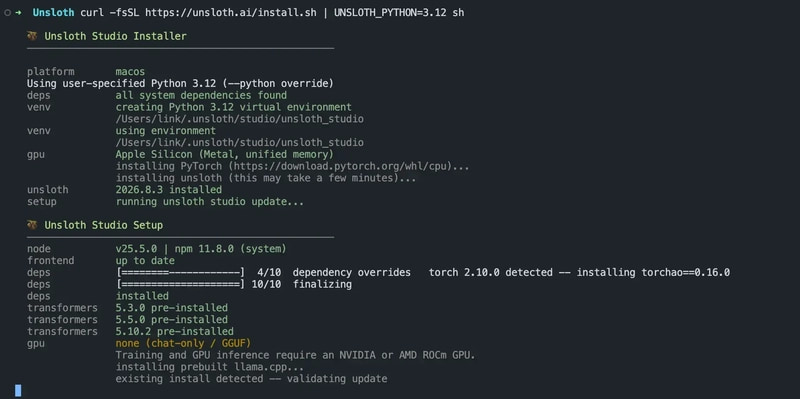
如果你使用的是 Apple Silicon Mac,请确保使用原生的 arm64 Python 解释器。如果安装程序错误地选择了 python.org 的 universal2 构建版本,可能会遇到 pydantic_core 架构错误。解决方法如下:删除现有环境并指向特定二进制文件:
rm -rf ~/.unsloth/studio
curl -fsSL https://unsloth.ai/install.sh | UNSLOTH_PYTHON=3.12 sh
安装完成后,可以启动 Studio 界面:
unsloth studio -p 8888
评估硬件能力时,请记住 macOS 使用统一内存,约 75% 可供 GPU 使用。对于使用 UD-Q4_K_XL GGUF 模型进行推理,权重大小加上 KV cache 需求必须在这个限制内。MoE 模型(如 gpt-oss 20B 或 Qwen3.6 35B-A3B)非常推荐给 Mac 用户,因为它们每个 token 只激活一小部分参数,与 dense 模型相比显著提升了生成速度。
Studio 作为四大主要 LLM 任务的集中中心:
Chat:强大的推理界面,支持沙盒化 Bash/Python 执行和实时网络搜索。
Data Recipes:可视化工作流构建器,使用图形化 UI 将非结构化文件(PDF、DOCX、CSV)转换为训练数据。
Fine-tuning:涵盖 QLoRA、LoRA 和全量微调的引导向导,实时跟踪 loss 和梯度范数。
Export:将模型转换为 16-bit safetensors、LoRA adapters 或 GGUF 格式的工具。
对于高级用例,Python 库提供了完整的程序化控制。虽然 macOS 支持 GGUF 服务,但实际微调训练针对 NVIDIA 硬件进行了优化。使用 unsloth 库来高效管理训练循环:
from unsloth import FastModel
from trl import SFTTrainer

model, tokenizer = FastModel.from_pretrained(
    model_name = "unsloth/gemma-4-E2B-it",
    max_seq_length = 2048,
    load_in_4bit = True
)

# Configure LoRA adapters
model = FastModel.get_peft_model(
    model, r = 16, lora_alpha = 16, bias = "none"
)
关键超参数建议:LoRA rank 保持在 16 或 32 左右,使用 gradient_accumulation_steps 将有效 batch size 维持在 16,训练轮次上限设为 1-3 个 epoch。务必监控 loss 曲线;数值在 0.5 到 1.0 之间通常较为健康,而低于 0.2 则意味着过拟合。
Unsloth 的 UD-quantization 格式(Dynamic 2.0 GGUF)可以说优于标准 importance-matrix GGUFs。它根据架构敏感性动态选择每层的量化类型。对于大多数生产需求,UD-Q4_K_XL 或 UD-Q5_K_XL 变体几乎无损。
导出时,请仔细选择目标格式:
# Save as GGUF for llama.cpp/Ollama
model.save_pretrained_gguf("gemma4-finetune", tokenizer, quantization_method = "Q8_0")
很多时候,本地开发停滞不前是因为模型被锁在 localhost 上。要在不进行复杂网络配置的情况下安全地暴露模型,可以使用 Pinggy 进行基于 SSH 的隧道穿透。
ssh -p 443 -R0:localhost:8888 free.pinggy.io
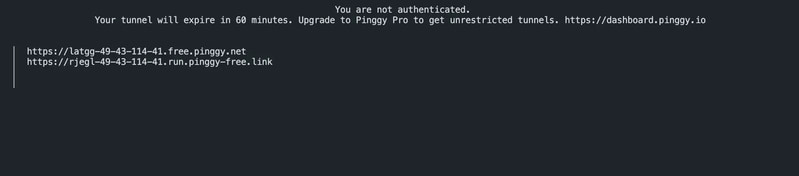
此命令提供一个公开的 HTTPS URL,允许远程访问你的 Studio 实例或 API 端点。对于敏感工作流,务必禁用代码执行工具(--disable-tools)并启用身份验证。由于 Pinggy 使用标准 SSH 隧道,你可以轻松地按 IP 限制访问或使用基于 header 的身份验证来管理访问控制。
虽然 Unsloth 是单 GPU 工作流的强大工具,但与 Axolotl 等框架相比,多 GPU 编排功能尚不成熟。此外,Studio 仍处于 beta 阶段,意味着你可能会偶尔遇到 UI 状态或数据处理的边缘情况。然而,对于希望在本地文档处理和自定义微调 LLM 之间搭建桥梁的个人开发者而言,Unsloth 仍然是通往生产级结果的最快路径。
Self-Host and Fine-Tune LLMs Locally with Unsloth in 2026 | Pinggy Blog
Fine-tune LLMs locally with Unsloth: QLoRA on a single GPU, Unsloth Studio, Dynamic GGUF quants, and sharing your model over a Pinggy tunnel.