算清 LoRA 微调的参数与资源开销
文章以 16GB Apple Silicon 上的 Qwen2.5-1.5B-Instruct、rank 16 配置为例,拆解 LoRA 实际训练的矩阵及参数量。它进一步讨论适配层、权重精度与优化步数如何影响资源和训练时间。
AI 深度解读
「LoRA 只训练模型约 1% 的参数」,这句话没错,却不足以判断你的电脑能不能跑。真正影响资源开销的,是 adapter 插在哪里、rank 多大、底座用什么精度加载,以及数据最终能产生多少次参数更新。
作者以 16GB Apple Silicon Mac 上的 Qwen2.5-1.5B-Instruct 为例,把参数、内存和训练步数逐项算清。最有用的结论是:可训练参数少,不代表整个训练过程只占一点内存;几百条样本能改变回答风格,也不等于能可靠补充知识。
那 1.2% 的参数,究竟加在了哪里
LoRA 冻结原始权重 W,只训练两个较薄的矩阵 A、B。对于形状为 d_out × d_in 的 W,A 的形状是 r × d_in,B 是 d_out × r,输出变成:
W·x + (α/r)·B·A·x
可以把它理解成:保留原来的计算,再加上一条可学习的修正路径。B 从零初始化,因此训练起点与底座模型一致。每层新增参数为 r × (d_in + d_out),随 rank 和矩阵边长线性增长。
作者使用 osFoundry 本地训练器,底层是 transformers + PEFT + TRL,配置为 rank 16、alpha 32。
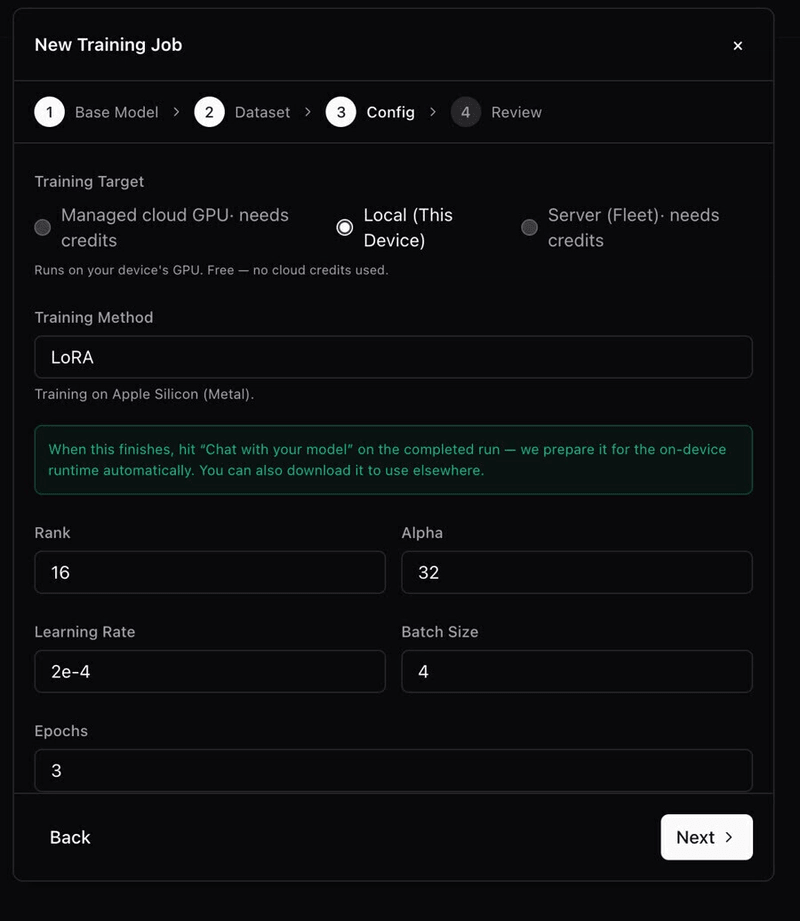
下面这段配置决定了 adapter 的覆盖范围:
target_modules=["q_proj", "k_proj", "v_proj", "o_proj",
                "gate_proj", "up_proj", "down_proj"]
要看第二行:它把 MLP 的三个投影也纳入训练,并非只调整注意力层。
Qwen2.5-1.5B 有 28 个 block,hidden size 为 1536,MLP size 为 8960。它采用分组查询注意力(GQA),有 2 个维度为 128 的 KV heads,因此 k、v 的输出宽度只有 256。
rank 16 时,每个 block 增加 659,456 个参数,28 个合计 18,464,768,约 18.5M,占 1.54B 总参数的 1.2%。其中约四分之三来自 MLP 投影。若只适配 q、v,参数会降到约 2.2M,约为当前配置的八分之一。不过,参数量缩到八分之一,不代表效果也按比例下降。
为什么只训练一点参数,仍然需要不少内存
LoRA 省下的是底座参数的训练状态,底座权重本身仍要驻留内存。
作者训练器的加载精度由这一行决定:
torch_dtype = torch.float16 if device == "cuda" else torch.float32
要注意 else torch.float32:在这套配置里,Apple GPU 使用的 MPS 路径会加载 fp32 底座。作者给出的原因是 MPS 半精度训练经常出现 NaN loss。
于是,冻结的底座就要占 1.54B × 4 字节 ≈ 6.2 GB。相比之下,18.5M 个可训练参数只需约 74 MB,梯度再占 74 MB,AdamW 的两份矩估计占 148 MB,合计约 0.3 GB。
还没算完。中间激活也要内存,并随 batch size 和 sequence length 增长。训练器将序列限制在 2048 tokens,短聊天样本通常远低于上限。
按作者给出的估算,16 GB Mac 约有 12 GB 可供 GPU 使用,能为这个 1.5B 模型留出训练空间;7B 底座若用 fp32,训练开始前就接近 30 GB。
QLoRA 用 4-bit 冻结权重压缩这部分开销。原文提到的 bitsandbytes 4-bit 路径需要 NVIDIA GPU,因此这套 Mac 方案采用普通 LoRA。这里应理解为作者所用工具链的限制,不能扩展成所有 Mac 量化训练方案的结论。
200 条数据,最后其实只更新了约 39 次
作者设置 batch size 4、gradient accumulation steps 4,也就是每次 optimizer 更新累计看 16 个样本。
200 对样本,每个 epoch 有 50 次前向与反向计算,约产生 13 次 optimizer 更新。跑 3 epochs,合计约 39 次,其中前 10 次还是 learning-rate warmup。学习率为 2e-4,之后采用 linear decay。
作者观察到,这个量级足以改变语气和表达方式,却不足以可靠地教会模型新知识。原文没有提供知识测试成绩,也没有对照实验,因此更适合把它当作这次运行的经验边界。
训练完成后,只保存 196 个适配层各自的 A、B,产物为几十 MB 的 adapter。应用再将其转换为 GGUF LoRA 文件,由 llama.cpp 加载到 Q4_K_M 量化的 qwen2.5-1.5b-instruct 底座上。多个任务或语气可以共享底座,各自保留 adapter。
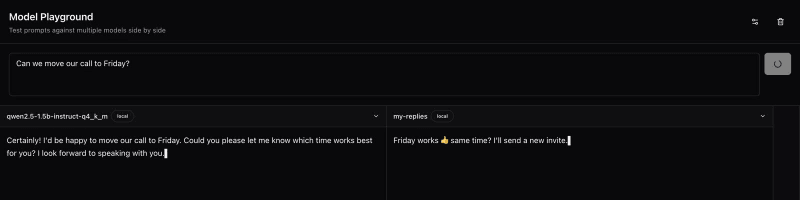
这里还有一个部署变量:训练时面对 fp32 底座,推理时面对 4-bit 底座。作者认为小型风格 adapter 通常不太受影响,但也指出,先合并再量化与运行时加载 adapter,行为可能略有不同。
我的判断
这篇最扎实的部分是资源核算。它把「训练参数少」拆成了覆盖层、精度、梯度、优化器状态和激活,适合拿来检查训练配置。
效果判断则需要收着看。作者没有给出只训练 q、v 与覆盖七种投影的效果对比,也没有量化验证两种部署方式的差异。「200 条样本主要改变风格」有实践参考价值,但不是所有数据集的固定上限。
如果目标只是统一回答格式,提示词和示例通常更容易调整;如果目标是回答持续变化的业务知识,应先考虑检索增强生成(RAG)。这两点属于站内取舍,原文没有提供它们与 LoRA 的对照数据。
能拿来做什么
- 在本地微调前,先按底座参数量与加载精度估算常驻内存,再给激活留空间,不要只看 adapter 文件大小。
- 为 AI 编程助手调整解释语气或输出习惯时,先计算实际 optimizer 更新次数,并用固定样例比较训练前后的表现。
- 将 adapter 接入本地服务时,用最终的量化底座验证回答;若改成合并后再量化,也重新检查同一组提示。