
8.0
热点
AI SCORE
技术实践2026-10-21 03:50
语音 RAG 用检索阈值和证据链约束回答
dev.to · AI#RAG#语音交互#可信回答
Editor brief · 编辑速览
VOICE-RAG 面向四种语言的语音提问,仅基于精选的 4 万段语料回答,检索分数不足时拒答并展示阈值。文章讨论证据不足时幻觉作答与阈值过严导致误拒答的权衡,并在界面呈现证据链。
Pavan Ganesh Indupudi(Infernix)· 最初发布于 the-infernix.github.io
向大多数 RAG 演示系统提问“印度总理是谁?”,它们都会欣然从某段看起来语义接近的文本中,编造出一个答案。为 HH Goa 2026 打造的 VOICE-RAG 则会拒绝回答,并给出一个数字:
Refused: Top retrieval score 0.779 below relevance floor 0.840
这句话概括了整个项目的核心思路。系统支持英语、印地语、古吉拉特语和泰卢固语的语音提问,严格依据经过筛选的 40,000 段语料作答;如果语料中没有答案,就拒绝回答。本文会介绍:为什么这件事最终成了最难的部分,以及围绕它构建的、耗时仅 56 ms 的核心流程是如何实现的。
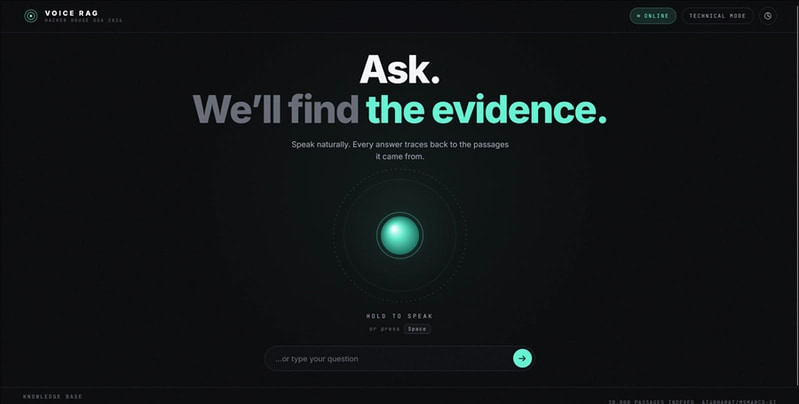
检索增强生成会在两个方向上出错。限制太松,生成器就会用流畅的胡说八道掩盖证据缺失;限制太严,系统又会拒绝本来能够回答的问题。大多数演示系统只针对第一种失败做调优,让答案听起来有据可依。我们则着重让第二种失败清晰可见:每次拒答都说明检索得分和阈值,无论回答还是拒答,UI 都会展示完整的证据链。
语音是主要输入方式。按住说话,采集 16 kHz 单声道 WAV,再通过 Sarvam saaras:v3 完成语音转文字。语音输入会增加大约 1 s 的 STT 耗时,因此后续所有步骤都必须快到让人感觉不到。
四种语言,共用一个索引。基于 MSMARCO-XI 语料,支持英语、印地语、古吉拉特语和泰卢固语,每种语言 10k 段文本,使用 384 维多语言 E5 embedding。
从设计上限定知识范围。对于没有任何支持段落的常识类问题,系统必须拒答,不能依靠模型参数中存储的知识作答。
不使用 bundler。前端是直接由 FastAPI 提供服务的原生 JavaScript SPA。没有 node_modules,也没有构建步骤。
整个 pipeline 严格按顺序执行,每个阶段都会把耗时和决策写入 trace,UI 再将其呈现为一条“为什么给出这个答案”的链路:
证据抽屉和延迟 trace:每一道防护的决策都对用户可见,而不是藏在服务端的秘密逻辑。
输入防护 → embedding → 向量检索 → 相关性防护 → 生成 → 依据校验。实测中位数如下(n = 2,000 条基准测试查询):
**设计决策:**默认采用抽取式回答,从排名第一的段落中选出证据支持最充分的句子;LLM 生成则必须显式启用。抽取式回答耗时仅 0.09 ms,而且天然有原文依据;通过 OpenRouter 生成回答需要数秒,还必须通过引用约定来约束其真实性。先满足延迟预算,再在用户需要时提供生成式表达。
相关性防护只做一次比较:将 top-1 余弦相似度得分与对应语言的最低阈值进行比较。但这些阈值不是拍脑袋定的,而是通过测量得分分布校准出来的:已知相关查询的 P25–P50 大约集中在 0.84–0.86,语料范围之外的无关查询大约在 0.79–0.85,阈值就设在两者的分界处:
选择阈值时,依据的是查询的语言,而不是排名第一的 chunk 的语言,避免跨语言的无关结果借用其他语言的阈值蒙混过关。语言检测基于 Unicode 文字区块:泰卢固文区块 → te,古吉拉特文 → gu,天城文 → hi,其余 → en。自动检测语言后,系统会在扩大到 3 倍的候选池中,对同语言段落施加 +0.03 的软性重排加分。
Q: Who is the Prime Minister of India?   → REFUSED  (0.779 < 0.840)
Q: Who won the FIFA World Cup 2022?      → REFUSED  (0.796 < 0.840)
Q: How much does an Xbox 360 cost?       → answered ($80–$250, conf 0.933)
通过相关性检查还不够。依据校验会验证答案是否确实得到检索文本的支持:token 重合度 ≥ 0.231 时立即通过;低于这个值时,则回退到 embedding 相似度检查,要求相似度 ≥ 0.794。缺乏依据的生成结果会被替换为抽取式答案,或者直接拒答。
启用生成模式后,LLM 必须返回严格的 JSON,格式为 {answer, citations[], confidence},并且只能引用提供给它的段落。输出格式错误时,恰好重试一次。虚构或超出范围的引用会被丢弃;如果没有任何有效引用保留下来,pipeline 就回退到抽取式回答。缺乏依据的生成结果绝不会呈现给用户。
基准测试套件针对预构建索引运行 2,000 条语料查询,每种语言 500 条,分布均衡,并固定随机种子:
本轮测试中的防护结果:1,893 条得到回答,107 条被拒答。匹配较弱的查询被正确拒绝,没有得到无关内容拼凑出的答案。唯一的 P100 异常值为 273 ms,出现在古吉拉特语查询中,原因是一次操作系统调度事件;所有语言中耗时第二高的查询为 178 ms。
我们还构建并测量了一条 BM25 + dense 混合检索分支,使用 bm25s 和倒数排名融合(reciprocal rank fusion),并依据 MSMARCO 自带的标准标签进行评估:
**权衡:**混合检索以约 1 ms 的额外耗时和大量维护工作,换来了 +0.4 个百分点的命中率提升。实测表现基本持平,因此默认仍采用纯 dense 检索;稀疏检索分支随项目提供,由 retrieval.hybrid.enabled 控制,默认关闭。RRF 仅用于扩展候选池,最终排序始终依据余弦相似度,这样才能让检索得分与拒答阈值保持一致。使用混合检索排序,会悄无声息地让我们测出的所有阈值失效。
每次检索还有 200 ms 的时限。被跳过的分支会在阶段 trace 中显示明确的降级字符串(sparse_leg_skipped_deadline),不会静默超时。
知识范围受语料限制。“印度的首都是哪里?”没有任何支持段落,因此会被正确拒答。这是一项功能,但会让期待它像聊天机器人一样回答问题的用户感到意外。
**临界区间确实存在。**在 0.84–0.86 附近,弱相关检索结果与高分无关检索结果存在重叠。按语言设置阈值,是用少量召回率换取大量精确率;因此,一些本来可以回答的问题也会被拒绝。
**语音会增加约 1 s。**Sarvam STT 占据了端到端耗时的大头,相比之下,RAG 核心流程的 56 ms 几乎感觉不到。
生成模式之所以需要显式启用,正是因为它会突破延迟预算。
**经验:**根据实测得分分布校准阈值,不要依靠直觉。我们花了一个下午研究直方图、确定阈值,却因此救了整个产品:没有这些阈值,系统就会在最不能答错的场景中,自信地给出错误答案。与默不作声地放弃回答相比,明确给出得分的拒答也容易调试得多。
预构建索引包含 40k × 384 维向量,随仓库一同提供,因此首次运行不需要建立索引。逐条查询的原始基准测试数据已提交至 bench/results/results.json。
git clone https://github.com/The-Infernix/VOICE-RAG.git
cd VOICE-RAG
python -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
uvicorn api.main:app --port 7860   # SPA at http://localhost:7860

pytest tests/ -q                   # 178 passing
python bench/run_bench.py --limit 2000      # latency
python bench/eval_retrieval.py               # HitRate@10 / MRR@10 vs gold
python bench/run_bench.py --limit 500 --hybrid --soft-lang \
  --out bench/results/ab_hybrid              # the hybrid A/B above
拒答是一项产品功能,不是错误处理路径。让它可以衡量、经过校准,并且对用户可见。
为每个阶段独立设置防护,包括输入、相关性和答案依据,并在 UI trace 中展示每一次决策。
当测得的提升落在噪声范围内时,交付更简单的系统,把复杂方案保留在功能开关之后。
检索排序方式必须与校准阈值时采用的排序方式保持一致。
VOICE-RAG 仓库:基准测试结果、包含 178 项测试的测试套件,以及配置。
bench/results/summary.json:上文引用的延迟数据。
bench/eval_retrieval.py:依据 MSMARCO 的 is_selected 标签进行标准答案评估。
guardrails/relevance_guard.py:经过校准的各语言最低阈值。
为 HH Goa 2026 的 Task 2 构建。
Pavan Ganesh Indupudi(Infernix):Andhra University 的计算机科学学生,致力于构建保护隐私的 AI。完整文章及更多内容见 the-infernix.github.io · GitHub · LinkedIn。
如需采取进一步措施,可以考虑屏蔽此人和/或举报滥用行为。