追踪一次 Agent 请求,定位数秒额外开销
作者在使用合成数据的 CloudOps 实验中,通过追踪发现工具仅耗时约 0.1 秒,主要延迟来自模型及过量上下文;关闭不必要的服务后,请求从 8.5 秒缩短至 1.8 秒。文章还指出 AgentCore 命令对 Harness 与 Runtime 的支持差异,并介绍从 CloudWatch 查看追踪的路径。
AI 深度解读
一句「生产环境健康吗」,CloudOps agent 用了 8.5 秒才回答。作者关掉此前留下的 Code Interpreter 和托管记忆后,同一个问题只花了 1.8 秒。慢的主要不是查状态的 Lambda,而是模型处理了远超问题所需的上下文。
这次排查的价值在于展示了如何用追踪记录(trace)核对性能猜测。但它只测了一个问题、两次运行,还不能据此判断哪个服务拖慢最多。
回答正确,为什么还要看 trace
这是作者 AgentCore 系列 Stage 5 的第一部分。实验使用合成数据,包含一个 Harness、一个 Gateway、一个部署状态 Lambda,以及 Amazon Nova Micro。
作者此前看到终端打印出工具结果,就认为 agent 正常工作。但终端能告诉你回答是什么,不能解释时间花在哪里。因此,运行前他先写下猜测:Lambda 返回的数据很少,模型应该比工具慢。
他先尝试通过 CLI 查看追踪:
agentcore traces list
命令却返回:
Error: No runtimes defined in agentcore.json
关键在报错中的 Runtimes:作者的 agent 声明为 Harness,这组命令只查找 Runtimes。查不到不代表追踪不存在,他随后改到 CloudWatch 控制台的 GenAI Observability 查看。
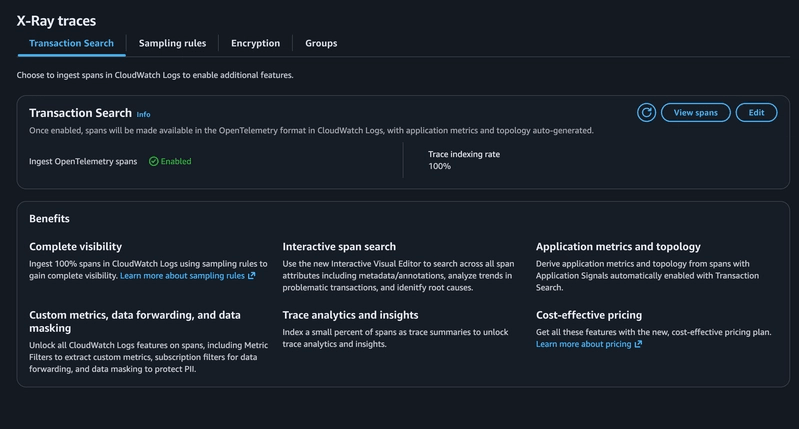
这里还有一个前提:账户必须先开启 CloudWatch Transaction Search。否则,各个执行片段,也就是 span,虽然已经送达,却无法作为完整 trace 搜索。
8.5 秒降到 1.8 秒,究竟删掉了什么
第一轮运行时,Harness 保留了前面实验开启的三项能力:Gateway 工具、Code Interpreter 和托管记忆。一次请求产生了 23 个 spans。
两次模型调用合计约 6.9 秒,占请求耗时约 81%;工具只占约 1%。慢速运行中,回答问题的 Lambda 调用链路约为十分之一秒,作者最初的猜测得到了支持。
更意外的是模型做了额外工作。第二次模型调用输出约 1,500 tokens,还自行加入了对部署历史 CSV 的 Python 分析。用户只是问生产环境是否健康,并没有要求分析历史数据。整次请求共读取 22,368 tokens,输出 1,632 tokens。
额外能力不只增加了可选项,还让这次请求做了不需要的工作。
第二轮,作者同时关闭 Code Interpreter 和托管记忆,只保留 Gateway 工具。请求缩短到 1.8 秒,追踪减少为 11 个 spans,答案直接给出服务、版本、实例数量和无告警状态。
模型耗时仍占约 62%,工具占比则从约 1% 升到约 22%。这不能直接解读成工具变慢:周围环节缩短后,工具在总耗时里的比例自然会上升。两轮工具耗时确实有波动,作者也没有据此作进一步判断。
原文没有提供第二轮的 token 数,因此不能精确计算输入和输出分别减少了多少。
Gateway 耗时,也不等于 Lambda 执行时间
作者还想把同一次请求的 trace 和 Lambda 日志对应起来。Lambda 日志会打印 request ID 和执行时长,但他在 Gateway span 中没有找到这个 request ID。
真正能关联两边的是下一行的 trace ID:去掉开头的 1 和连字符后,它与 CloudWatch 展示的 trace ID 一致。
通过这个关联,作者看到 Lambda 自身执行约 17 毫秒,而整个 Gateway 调用耗时 104 毫秒。剩余时间很可能来自 Gateway 和网络,但 trace 没有把这部分继续拆开。
所以,排查时要分清模型调用、Gateway 调用和函数执行三个范围。看到某一层用了 104 毫秒,不能直接把这笔时间都算到业务代码上。
我的判断
我认同作者先写猜测、再用 trace 验证的做法。它能避免看到某个慢环节后,再倒过来拼一个解释。对于会自行选工具、扩展任务的 agent,追踪也能揭示答案背后的多余动作。
但「关掉两个服务就快了」目前只能算一次有价值的实验观察。作者把 Code Interpreter 和托管记忆一起移除,无法区分两者各自的影响;一个问题只运行两次,也不足以证明稳定收益。原文没有提供重复测试、分组对照或答案质量评估。
与压缩提示词、换更快模型相比,先检查启用了哪些能力,是这次案例支持的一条排查路径。它并没有证明这条路径在所有团队都更有效。实验使用合成数据,真实系统若需要历史分析或跨轮记忆,关闭能力也可能损失必要功能。
作者计划下一步分别关闭两个服务,并在后续部分针对同一问题运行 12 个故障案例。这些都是待做的验证,不能算作已有结论。
能拿来做什么
- 给日常 AI agent 选一个答案明确的常见问题,运行前写下耗时猜测,再从 trace 核对模型与工具各占多少时间。
- 检查 agent 是否保留了旧实验的工具和记忆配置;对简单查询,逐项关闭非必要能力,同时核对答案是否完整。
- 排查 Node 或其他后端工具调用时,分别看调用链总耗时与函数自身执行时间,并用 trace ID 关联日志。
- 复现实验时,一次只调整一项配置,并重复运行同一问题,避免把单次波动当成稳定收益。