AI 只学一次字段映射,后续对账交给 Python
Doze 用本地 Gemma 理解支付与银行导出文件的字段对应关系,经人工批准后保存为可审查的 JSON。后续由 Python 复用映射、核对金额和结算引用,无需持续调用模型,也不让模型判断差额是否可接受。
AI 深度解读
Doze 把 AI 对账拆成了两件事:让本地 Gemma 理解一次导出文件的列名,把结果存下来;之后由 Python 按固定规则反复核对。模型不读交易明细,也不判断差一分钱能不能放过。
它值得看的地方,是把「AI 学会了」变成了一份能检查、能测试、能脱离模型运行的文件。不过,作者展示的是合成数据和有限验证,距离真实业务效果还有一段路。
为什么只让模型认列名,不让它算账
支付平台把一列叫作「Payout group」,银行把对应列叫作「Settlement reference」。客户支付的是 gross,平台扣除 fees,银行收到的是 net。对账既要理解字段含义,也要准确计算。
Doze 把前一部分交给 Gemma,把后一部分留给 Python。模型只看到两组表头、选定的小数分隔符,以及用户明确批准的字段解释;它可以返回映射,也可以拒绝。交易行不进入模型。
下面这段 JSON 解决的是共享结算编号在两份导出中叫什么:
{
  "payments": { "batch": "Payout group" },
  "bank": { "batch": "Settlement reference" }
}
要看的是两个 batch:它们指向各自文件中的真实表头,共同含义来自人工解释。这只是完整契约的一部分,其他角色还包括唯一记录 ID、gross、fees、银行金额和币种。映射里没有生成代码、公式或模糊匹配指令。
本地推理由 Ollama 承载,使用 gemma4:12b-it-qat。表头解释发送到回环地址,没有自动云端回退,也不会暗中下载模型。应用代码采用 MIT 许可,Gemma 权重不随项目分发,另有许可条款。
模型负责提出字段映射,人工批准含义,程序负责执行规则。
手动填下拉框也能完成映射,Doze 同样支持。AI 的价值只是把自然语言解释整理成可复用提案,是否值得接入,要看这一步到底有多麻烦。
JSON 合法,为什么还得让它过测试
作者最初得到过两次拒绝,即使已经解释共享结算编号,Gemma 仍没有产出可用映射。
问题之一在提示词:成功映射的完整 schema 传给了 Ollama 输出格式约束,却没有完整出现在模型可见的提示词中;提示词唯一完整的 JSON 示例反而是拒绝结果。作者随后补入成功 schema,并把每个角色约束到实际表头,同时保留拒绝分支和运行时检查。
修改后做了三个输入、每个不重试的有限检查:已解释的 studio schema 映射正确,另一套表头词汇映射正确,明确未知的字段含义仍被拒绝。studio 调用在作者机器上耗时 4.85 秒,结果通过全部八个固定样例。
这只能支持组合修改在这三个案例中有效。没有拆分对照,无法判断是哪项改动起作用,更不能据此推导普遍准确率。
更关键的是,结构正确不代表含义正确。把 gross 和 fees 对调,JSON 依然合法,但八个固定样例的通过情况会从 8/8 跌到 1/8。这些样例覆盖退款、重复记录、缺失转账、混合币种和一分钱差异。
Doze 因此把映射与可执行验证样例一起保存。预期结果独立于映射编写,模型不能自行宣告正确。导入时也不相信文件里的「通过」标记,而是重新运行已安装的验证套件;篡改映射、结果或随包预期,不能让失败工作流过关。
这里有个适用边界:这套固定样例针对已知 studio schema,并非任意支付渠道。普通人工审核映射走另一条路径,不经过这个样例门槛。
模型睡了之后,靠什么守住结果
执行引擎使用十进制算术和精确结算编号匹配。重复 ID、转账歧义、不支持或冲突的币种、格式错误、schema 变化都会形成明确异常。一分钱差异也算不匹配。
作者的 68 秒演示使用合成导出文件,并回放一次真实本地推理保存的结果,没有现场重新调用模型。关闭推理后,同一映射检查了 52 个生成的周数据:41 周干净,11 周待审核,共 19 个明确异常,回放期间模型调用为零。
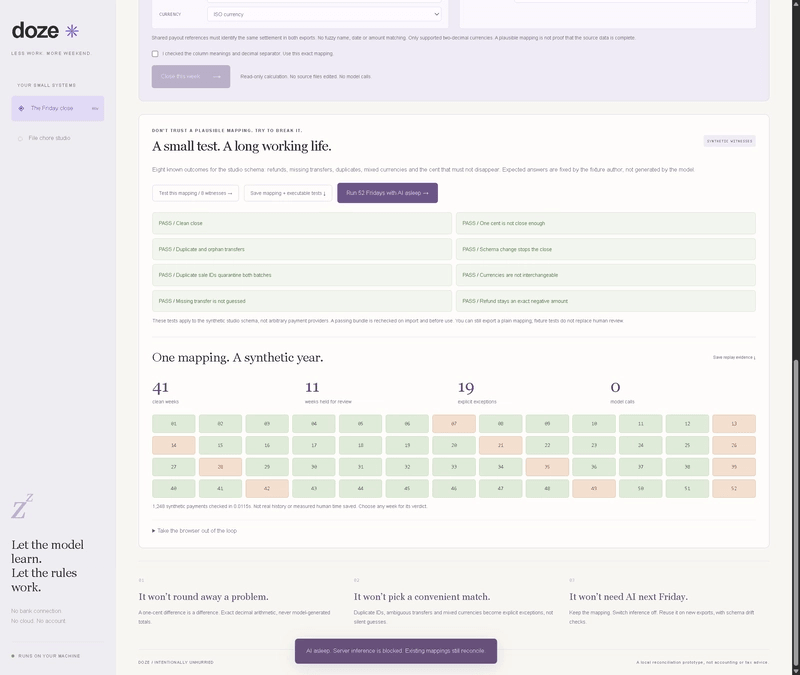
这些是合成结果,不是一年客户记录,也没有证明节省了多少工时。
结果干净也不能直接导出交接包。用户还要审核报告,批准绑定报告哈希以及确切的输入和映射;输入改变,旧批准失效。工作流报告另绑定验证套件身份。
ZIP 包含对账 CSV、审计 JSON、映射、源文件哈希和说明,使用测试工作流时还包含该工作流。原始导出不会被修改,选中的源 CSV 内容也不会装进包里。
运行时可以进一步去掉浏览器和服务端。下面的命令直接用标准库 CLI 对账:
python -m doze.close_cli --profile workflow.json --payments payments.csv --bank bank.csv --mapping-approved
要留意 --mapping-approved:它声明映射已获批准,但创建交接包还需要此前审核的精确报告哈希和新的输出文件名。
作者在全新 Python 进程中禁止创建 socket,十二项检查全部通过,覆盖好周与坏周判断、批准后的 ZIP 创建、拒绝过期批准及保护已有输出文件。这比界面上的休眠图标更能证明离线复用。
项目后端只用 Python 标准库,前端是普通 JavaScript。回放入口是 python -m doze.server,打开本机 127.0.0.1:8741,选择 Replay the verified Gemma lesson / recorded result。这条路径只需 Python 3.11+,无需账号、额外包或模型下载。
作者报告最近一次本地测试共 120 项,119 项通过,跳过一项 Windows 符号链接权限测试;CI 覆盖 Windows、Linux 上的 Python 3.11 和 3.12,也包含离线验证。
我的判断
我认可这套职责划分:把需要理解的部分压缩成一个可检查的输入,再用确定规则处理重复任务。导出的 JSON 不依赖聊天上下文,也能由其他已安装的本地模型提出,执行引擎无需跟着更换。
但 AI 的必要性没有被证明。如果团队只有少数稳定格式,手工配置映射可能更省事。作者没有给出手填、传统字段别名字典与 Gemma 提案的效率对照,也没有测量人工耗时或能耗,收益判断仍是经验之谈。
更值得借鉴的是保存可验证的工作结果,而不只是保存提示词。
它也依赖输入足够规整。Doze 不处理拆分转账,不转换币种,不连接银行账户或移动资金,也不提供税务建议。两份导出一致,只能证明它们互相吻合;同一笔交易若在两边都缺失,系统看不见。未解决异常会阻止干净交接,但程序无法替代业务完整性检查。
因此,52 周零模型调用证明的是已批准映射能够重复执行。没有真实客户试用,也没有跨大量供应商的验证,不能把它理解成成熟财务系统的效果承诺。
能拿来做什么
- 做前端导入向导时,可以让模型根据表头和用户解释提出字段映射,再提供确认、修正和保存入口。下一次格式相同就复用,格式变化则明确报错。
- 在 Node 或 Python 数据处理流程里,把映射与计算分开:模型输出受约束的配置,金额计算和精确编号匹配交给确定程序,并为重复 ID、缺失记录、币种冲突保留异常出口。
- 为固定导出格式建立独立预期的测试样例,至少覆盖退款、重复、缺失和金额差异。不要用 JSON 校验通过代替业务验证,也不要直接相信导入文件自带的成功标记。
- 对需要人工确认后才能导出的流程,把批准绑定到具体报告、输入和映射。复用结果前重新检查身份,避免文件变了,旧批准还继续生效。