让故障响应 Agent 记住失败的修复
RecallOps 用 Postgres 保存运维事实,用 Hindsight 保存处置经验,在有界排查循环中查询部署、日志及相似事故。工程师对建议的接受、拒绝和纠正会进入后续事故的参考信息。
AI 深度解读
凌晨 3 点收到告警,AI 建议「重启 Pod」,听起来合理。但如果上一次同类故障就是被重启拖得更严重,这条建议就很危险。RecallOps 想解决的正是这个问题:让故障处理 Agent 记住团队试过什么,以及操作之后发生了什么。
作者的结论很明确:有用的记忆不能只存成功方案,还要保存带上下文的失败记录。不过,这篇提供的是系统设计和待验证的评估方案,没有最终实验数据。值得借鉴的是它如何组织证据、约束建议,并让人纠正记忆。
为什么故障事实和处理经验要分开存
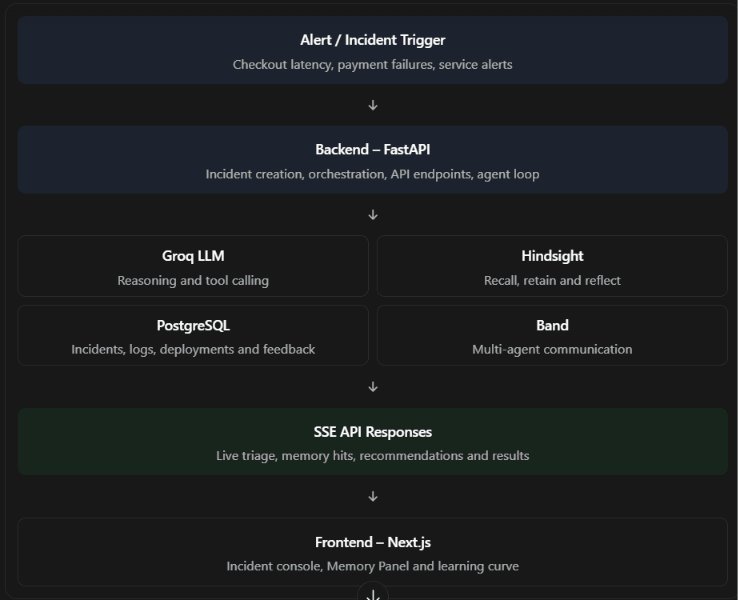
RecallOps 收到告警后,先创建故障记录,再启动一个有边界的初步排查循环。Agent 可以查询最近部署、日志、服务负责人和相似故障,并把工具调用、记忆命中、最终建议实时展示到控制台。工程师负责接受、拒绝或修正建议,最后填写根因和修复方式。
这里有两类信息,作者给它们安排了不同的存放位置。
Postgres 保存运维事实,包括服务、部署、告警、日志行、故障状态和反馈;Hindsight 保存处理经验,也就是经过压缩的故障经过与操作结果。原始日志仍然留在 Postgres,供需要时查询。
这个划分有实际价值。日志回答「当时发生了什么」,经验记录回答「当时怎么处理,结果怎样」。把每一行日志都塞进长期记忆,会增加检索噪声,也让工程师难以检查 Agent 到底凭什么得出结论。
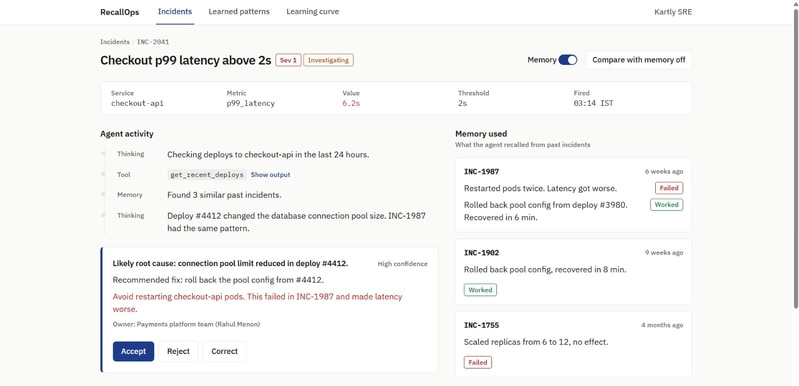
作者设计的 Memory Panel 会展示召回内容、来源故障 ID、日期,以及此前操作是成功、失败还是部分有效。界面由此承担了证据展示的职责:工程师能沿着引用追查,而不必只看一句流畅的建议。
值得记住的不是某条命令被执行过,而是它在什么条件下执行、最后有没有用。
失败记录怎样才能真正影响下一次建议
「重启失败过」还不够。它必须连着服务、症状特征、发生条件,以及失败次数一起保存,否则 Agent 可能把一次特定环境里的失败,误读成「以后都不能重启」。
作者举的例子是 checkout-api 延迟故障:重启没有解决问题,回滚连接池配置后恢复。这样的记忆把症状、操作和结果串在一起,比一份只有排查过程的聊天记录更适合支持决策。
Hindsight 在流程中承担三种操作:retain 写入复盘或操作结果,recall 检索相关经验,reflect 归纳跨故障的重复模式。下面这段代码展示了写入和检索时需要保留哪些信息:
hs.retain(
    bank_id="kartly-sre",
    content="INC-1987 checkout-api latency. Restart failed; pool rollback fixed it.",
    context="incident_postmortem",
    timestamp="2026-09-22T03:14:00Z",
)

hits = hs.recall(
    bank_id="kartly-sre",
    query="checkout-api latency spike after deploy",
    budget="mid",
)
要留意 timestamp 这一行:旧经验是否适用,与它发生的时间有关。这里的 bank_id="kartly-sre"、context="incident_postmortem" 和 budget="mid" 是示例配置,原文没有解释 mid 的具体资源额度,不能据此推算成本或延迟。
检索也不只是拿告警文本搜一次。作者会分别询问相似服务与症状、近期部署模式、同类故障里失败过的修复,再合并、去重结果。reflect 则用于寻找更长的关联,例如多次延迟尖峰是否都出现在连接池配置变更之后。
生成建议时,相似程度、时间远近和历史结果共同影响候选假设。相似条件下失败过的操作,应降低优先级;成功过的方案,则值得优先调查。作者没有给出这些因素的计算公式,因此这里应理解为推荐原则,不能当成已经披露的评分算法。
Agent 的提示词还要求它引用故障 ID、说明置信度、提醒此前失败的修复。引用 ID 会再到 Postgres 校验,避免模型编造一个不存在的来源。不过,ID 存在只证明记录存在,仍需检查该记录是否真的支持当前判断。
对于 checkout API 的 p99 延迟告警,这套流程希望给出的不再只是通用清单,而是「此前相似故障关联连接池配置,重启失败,回滚有效」这样的调查线索。执行决定仍由工程师作出。
怎么证明记忆有用,而不是演示看起来更聪明
RecallOps 允许同一个 Agent 对同一告警开启或跳过 Hindsight 调用。这个开关很关键:只有把有记忆和无记忆的结果放在一起,才能判断改善是否来自记忆。
作者计划做按时间排序的故障回放:早期故障构成历史,较晚故障作为留出案例。评估包括正确根因是否排第一、是否进入前三、是否重复建议此前失败的修复,以及模拟流程到达正确假设所花的时间。
回放的基本顺序如下,它解决的是「先作答,再把这次结果写进历史」的问题:
for incident in replay_cases_in_time_order:
    answer = triage(incident, memory=memory_enabled)
    record_metrics(incident, answer)
    if memory_enabled:
        retain_outcome(incident, answer)
要注意 retain_outcome(incident, answer) 位于指标记录之后。当前案例不能提前出现在可检索的记忆中,否则 Agent 就可能是在查答案。时间顺序也不能打乱,否则早期故障可能用到未来才获得的经验。
原文描述了 40 起故障的回放和独立历史集,但没有最终运行输出。 因此,不能声称 RecallOps 已经提高根因命中率、缩短处理时间,或减少了多少错误操作。作者也明确表示,要等回放运行完、确认记忆库没有混入留出案例后,再发布测量值。
此外,「更快提出正确假设」和「真实线上更快恢复」不是同一个指标。回放可以检查建议质量,却不能单独证明每次操作都安全。原文也没有交代样本如何覆盖不同服务和故障类型,这会影响结果能推广到多大范围。
我的判断
我认可它把失败结果放进记忆的方向。团队的故障知识经常只留下「最后怎么修好」,中间哪些操作无效、哪些加重了问题,容易在交接和复盘压缩时丢失。这些信息恰恰能阻止下一次重复试错。
与直接检索复盘文档相比,RecallOps 更强调操作与结果之间的关联,也把日期、来源和人工反馈带进了推荐流程。但这是否比维护良好的复盘库检索更有效,原文没有对照数据,目前只能视为有理由的设计选择。
它成立还有一个前提:团队愿意准确记录结果。「工程师接受了建议」不等于「修复成功」,「回滚后恢复」也未必证明回滚就是唯一原因。如果写入时把这些关系混淆,记忆可能让错误判断越来越有说服力。
作者允许工程师补充「这次是 Redis eviction,不是连接池问题」这样的纠正,这一步很必要。不过,旧记忆如何更新、相互矛盾的记录如何处理、系统升级后旧经验如何降低影响,原文没有说清。
所以我会把这套方案看成可核查的排查助手。它最有价值的输出,是帮助值班人员提出更具体的问题,并指出哪些操作需要重新审视。
能拿来做什么
- 给 Node 服务的故障复盘补齐「尝试操作、实际结果、适用条件、发生时间、故障 ID」,把重启无效、回滚有效等过程记录下来,避免只留下最终修复步骤。
- 为现有排障 Agent 增加失败经验检索,同时保留当前日志和部署查询。要求建议引用来源,并校验引用是否存在、内容是否支持结论。
- 在故障控制台展示历史操作结果,并让工程师能纠正根因。把「接受建议」和「操作成功」分开记录,减少错误反馈进入长期记忆。
- 用按时间排列的历史故障比较记忆开启与关闭两条路径,先观察根因排序和失败方案重复情况,再决定是否扩大使用范围。