AMD 开源面向 GPU 集群的智能体运行时
据摘录,PrimusClaw 在客户自有 Kubernetes 集群中管理智能体会话、执行框架及独立沙箱,并支持 A2A 与双向 MCP。模型网关兼容 Anthropic 或 OpenAI 风格接口,文章还披露了 AMD 内部运行规模。
AI 深度解读
AMD 把自家 Instinct GPU 集群使用的 Agent 运行时 PrimusClaw 开源了。它要解决的,是 Agent 连续跑几个小时之后,状态存在哪里、工具在哪里执行、进程重启后任务还能不能接上。这些问题,比接通一次模型 API 更接近生产环境的日常。
按原文转述,AMD 已用它承载超过 40,000 个会话。对程序员来说,这套设计值得看的地方,是怎样把 Agent 拆成可持久化的状态、可替换的执行进程和独立沙箱,以及自建这套系统需要承担什么。
Agent 跑几个小时,状态就不能只放在进程里
原文标注日期为 2026 年 11 月 7 日,介绍的是 AMD 于 11 月 6 日在 ROCm 博客发布的 PrimusClaw。代码仓库为 AMD-AGI/PrimusClaw,部署位置是客户自己的 Kubernetes 集群,靠近 AMD Instinct GPU。
这里的「托管运行时」容易让人想到云服务,但原文描述的是一套部署在客户集群内、负责管理 Agent 生命周期的软件。
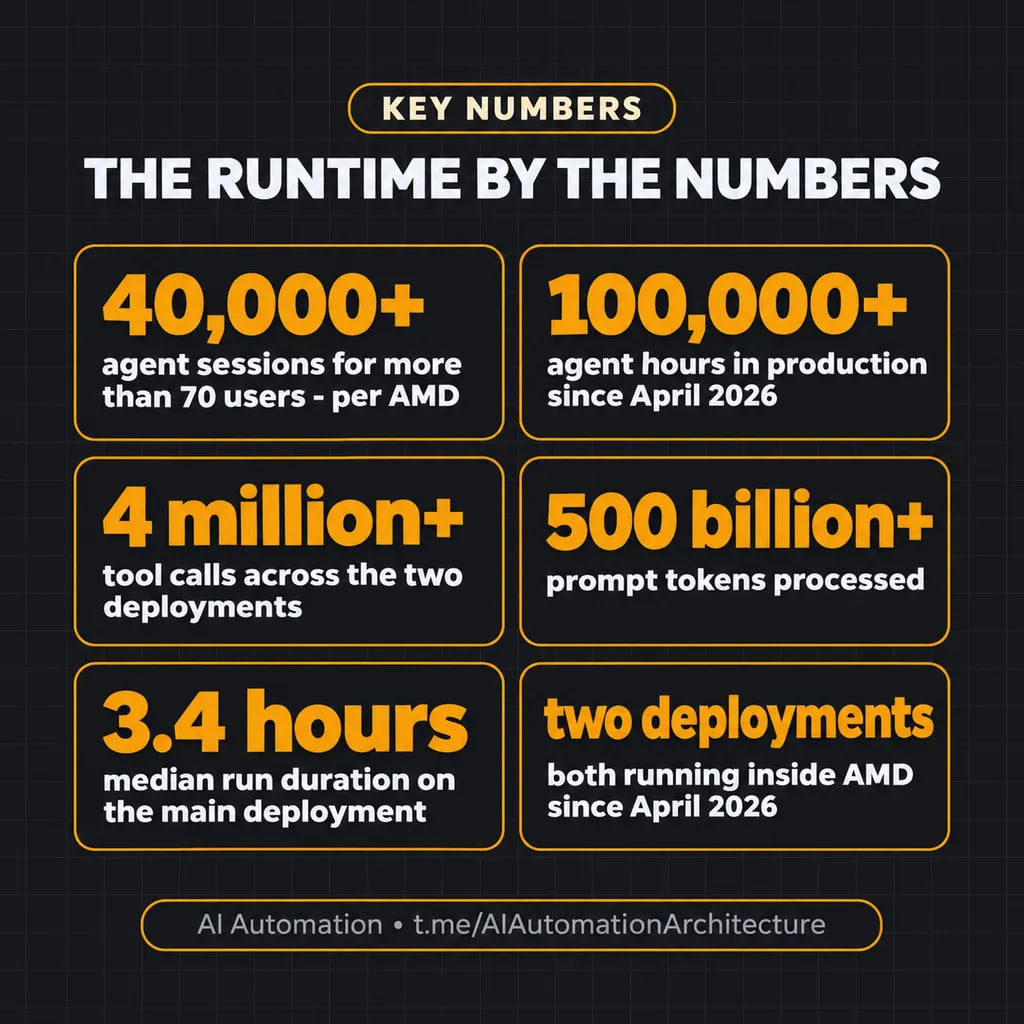
按 AMD 披露,它从 2026 年 4 月开始用于内部生产环境。两个部署累计服务超过 70 名用户,承载超过 40,000 个 Agent 会话、100,000 小时运行时间、400 万次工具调用,以及 5,000 亿个 prompt tokens。主部署的运行时长中位数为 3.4 小时。
这样的任务长度,让进程重启、连接中断和状态恢复成为必须考虑的问题。PrimusClaw 把会话、事件、记忆、skills、plugins 和任务图存进 PostgreSQL;事件通过 SSE 推送,并提供可恢复游标。按原文描述,harness 副本重启后,状态仍然保留。
长任务的关键,是让任务状态比执行它的进程活得更久。
为什么要把会话、Brain 和 Hands 拆开
PrimusClaw 的架构分成三部分:
- 长期存在的会话负责保存状态。
- 无状态的 Brain 充当 Agent harness,运行 Agent 循环并路由工具调用。
- Hands 是运行在每个会话沙箱内的 MCP 工具服务器,承担工具执行。
可以把 harness 理解为组织模型调用、工具调用和循环执行的那层程序。把它做成无状态组件,目的就是避免把任务能否延续,绑在某个常驻进程上。
工具执行还有另一道边界:每个会话拥有独立沙箱。默认隔离方案是 runc,也可以选择带虚拟机的 Kata Containers。沙箱能申请 AMD Instinct GPU,并从基于 ROCm 的镜像启动。
协议方面,PrimusClaw 支持 A2A v1.0,外部 Agent 发来的任务会被转换为实际会话。MCP 则支持两个方向:它既能连接其他 MCP servers,也能把自身操作暴露成 MCP tools。
模型通过兼容 Anthropic 或 OpenAI API 的网关接入,团队可以使用自己托管的模型。认证和多节点 GPU 放置交给 Primus-SaFE,也就是 AMD 面向 Instinct 集群的开放平台。
开源许可也有一个边界:仓库主体采用 MIT,沙箱控制平面则来自 Kubernetes SIG Apps 的 agent-sandbox 分支,采用 Apache-2.0。
我的判断
我认可这套拆分方式。状态落库、执行层无状态、工具进入独立沙箱,分别回应了恢复、进程替换和执行隔离的问题。对于长期运行、需要调用大量工具的 Agent,这些比单次模型调用的封装更值得关注。
但原文给出的生产数字,证明的是它已经承载过一定规模的工作,不能直接证明它比其他方案更快、更便宜或更稳定。超过 5,000 亿个 prompt tokens 也不能直接折算为账单,原文没有交代模型、缓存和计费口径。任务成功率、故障恢复时间、运维投入及对照测试,同样没有给出。
「状态保留」也不等于「所有操作都能安全重试」。例如工具已经修改文件,进程却在记录结果前退出,恢复后如何避免重复执行,原文没有说清。独立沙箱的实际隔离强度,也需要结合具体配置判断。
自建运行时带来数据和模型的控制权,也把集群、数据库和沙箱的维护责任交给了团队。
已有 Kubernetes、Instinct GPU 和私有模型需求的团队,更容易发挥这套方案的价值。对只做短时问答或少量工具调用的应用,直接调用模型 API、按需补充任务队列和持久化,可能更容易维护。原文没有提供两者的成本对比,不能替团队直接做选择。
能拿来做什么
- 如果你的 Node Agent 经常连续执行很久,可以先检查任务状态是否只存在内存里,再借鉴 PrimusClaw 将会话持久化、执行进程无状态化的做法。
- 如果正在开发 Agent 前端控制台,可以参考带恢复游标的 SSE 事件流设计,让断线重连有明确的续接位置,并单独验证事件重复和遗漏的处理。
- 如果工具需要运行命令或修改文件,可以评估按会话分配沙箱,同时检查外部写入操作能否安全重试。
- 如果团队已有 Instinct 集群和自托管模型,再评估 PrimusClaw、Primus-SaFE 与现有认证及运维体系的集成成本;AMD 的内部规模可以作为参考,不能替代自己的验证。