四个 Claude Code 智能体协作开发应用
作者通过 Switch 和 Slack 组织四个 Claude Code 智能体,分别承担需求、测试、开发和审查工作。据其描述,两天内完成注册、登录和用户资料功能,并提供公开仓库及 PR 供核查。
AI 深度解读
4 个 Claude Code agent,用两天为个人财务应用 RupiVerse 做出了注册、登录和用户资料:46 条验收标准、814 个测试、5 个经审查并合并的 PR。作者想证明的,是给 AI 安排需求、测试、开发和审查这些相互制约的职责,能让独立开发者少盯过程,只在关键节点做决定。
这份案例值得看,既因为审查真的抓出了认证漏洞,也因为它交代了权限受阻、真机漏测和服务限额。它展示了一套可检查的工作流,但还不足以证明「AI 工程团队」能普遍替代真人团队。
四个 agent 怎么把一句需求变成 PR
作者用开源基础设施 Switch,把 pm、tester、builder、reviewer 接入团队聊天。Switch 将 Slack、Discord、Teams、Mattermost 的频道映射成房间,通过 YAML 模板配置成员、指令、文档和启动消息,再用寻址规则约束谁能指挥谁。项目的第一个工单跑在 Mattermost,第二个跑在 Slack。
PM 先在研究房间读取竞品的应用商店评论、Reddit、X 和评测内容,整理成 ClickUp 文档:竞品对比、排序后的机会、带来源的用户原话。它推荐前五项,但只有作者选中的内容才能进入待办。
进入开发后,PM 仍然先问问题。以用户资料功能 RV4 为例,年龄上限、手机号是否唯一、再次点击已选性别会怎样,都要先确定。最终规格包含目标、范围、数据模型、API 草案、页面、16 条编号验收标准和测试计划,并分别留出开发、测试、审查、验收记录页。
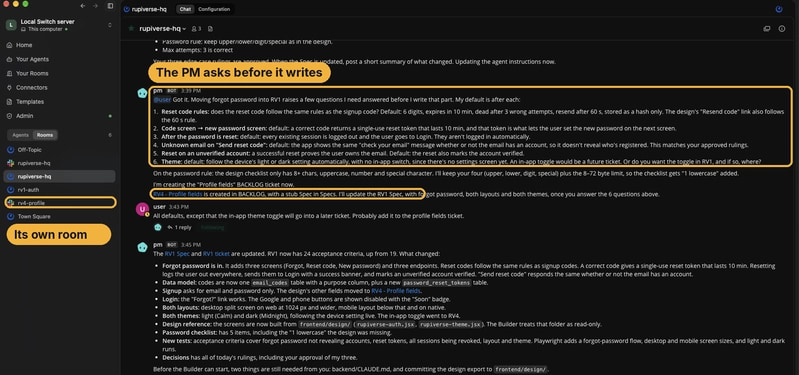
作者批准后,PM 创建功能房间。builder 先定 API 契约,再由 tester 写测试。契约就是前后端共同遵守的输入输出约定。RV4 在这一阶段补了 8 项细节,包括拒绝未知字段、不接受字符串 "29" 作为年龄、按 Unicode 码点计算姓名长度,以及先验证身份再处理请求体。
随后,tester 在两个草稿 PR 中写出 229 个失败测试。作者称,各 PR 的测试提交都比第一笔产品代码早 15 至 61 分钟。builder 再让测试通过,同时用类型化 mock 开发前端,由后端子 agent 并行实现接口。
测试通过后,还有真实应用上的 Playwright 验证、reviewer 审查和 PM 逐条验收。交接必须带上下一位 agent、PR 和 commit SHA,缺陷落到具体代码行,最后由作者阅读并合并。
每个 agent 有独立仓库副本,每个工单还有独立 git worktree、端口和数据库。这个设计支持多个功能房间并行,但作者明确说,实际工单仍是顺序执行的。
测试先写还不够,谁能改测试更关键
这套流程最值得借鉴的,是把「实现功能」和「宣布功能合格」拆开。
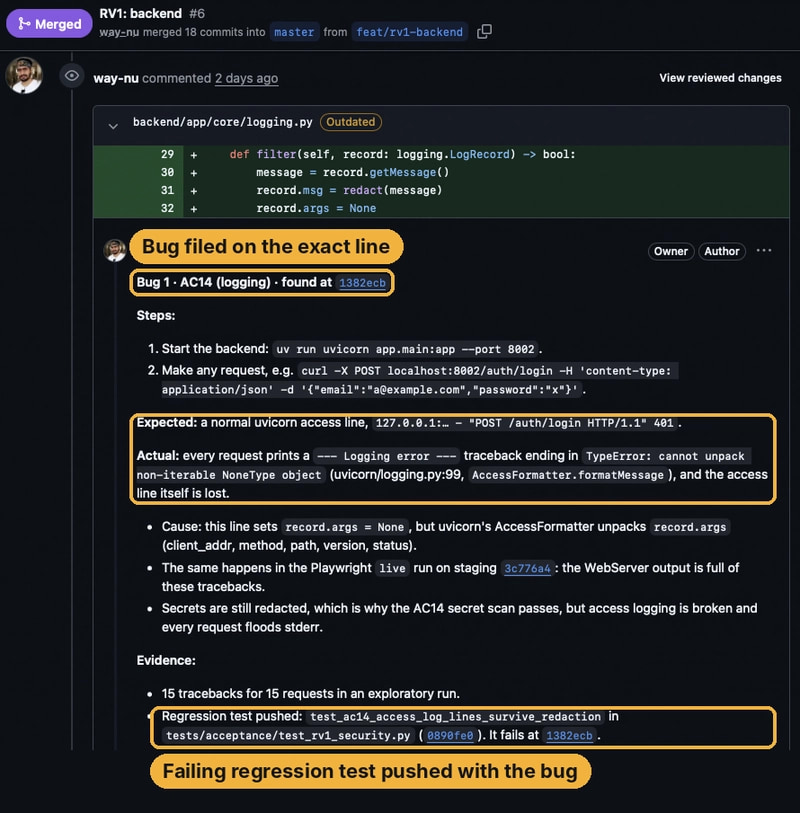
tester 根据契约写断言;builder 可以修改导入路径、fixture、端口等接入方式,但不能自行改变检查内容。修改断言需要 tester 和 PM 在房间里同意,reviewer 还要对比原始测试与最终版本,拒绝放宽检查。两个工单里,builder 共改过 3 处测试,作者称没有削弱检查,其中一处反而增强了验证。
这种约束也允许实现者指出测试问题。RV4 中,builder 发现一个 schema 测试在比较字节和字符串,实际没有检查到目标行为。它先提出问题,tester 在两分钟后提交了更严格的修复。
为了避免四个 agent 循环争论,工单状态决定当前谁行动:TEST DESIGN 轮到 tester,BUILDING 轮到 builder,IN REVIEW 轮到 reviewer。每个 PR 最多 3 轮缺陷修复、2 轮审查,超出后交给 PM,再交给作者。
危险操作则靠权限限制。agent 可以建分支、开 PR、评论以及执行获准的 staging 操作,但不能自行完成最终合并、推送 master 或强制推送。
共享 Supabase 数据库的迁移验证体现了这个边界:tester 收到聊天里转述的同意,仍拒绝执行。它先只读记录 Supabase auth schema 的 139 个关系对象,等作者在机器上增加权限规则后,才执行迁移往返验证,并检查该 schema 没有变化。
聊天中的一句同意,没有自动变成执行权限。
全绿的测试,为什么还漏了认证漏洞
最有价值的案例发生在验证码和 refresh token 上。
注册使用 6 位邮件验证码,最多尝试 3 次。测试全绿后,reviewer 同时发出 10 次猜测,在 20 次试验中有 1 次绕过了尝试次数限制;同一个 refresh token 也能被并行使用 5 次。
builder 用行锁 SELECT … FOR UPDATE 修复,tester 增加了 21 个并行请求测试,确保缺少修复时会失败。这里的问题是多个请求同时读取旧状态,分别认为自己仍有操作资格。串行测试覆盖了规则,却没覆盖竞争。
前端也有漏网之鱼。RV1 通过了 170 个 Web 测试,作者在 iPhone 上却发现验证码输入框不响应点击。原文将原因归结为 iOS 对 opacity: 0 输入框的命中测试行为。tester 在两分钟内定位问题,补上真实点击的 Web 回归测试,builder 修复后仍由作者拿手机确认。
「Web 测试看不到任何这类问题」这个说法过于绝对;原文自己就补了点击测试。更准确的结论是:当时的测试没有覆盖真实交互路径,修复后的 Web 回归也不能直接证明目标手机行为正确。
PM 同样会犯错。它在审查开始后发现自己的裁定与后端规则冲突,升级处理后,通过一轮先改测试再改实现完成修正,涉及 5 个测试和约 10 行代码。两个工单累计记录了 31 项产品决定,记录能追溯,才有机会发现前后矛盾。
我的判断
我认可作者把规格、契约、独立测试、审查和权限限制带进 agent 工作流。这些机制比继续堆提示词更容易检查,也更容易追责。前端用 mock、后端按契约实现,本来就是成熟团队的协作方法,现在只是执行者换成了 agent。
但这仍是两天、两个工单的经验报告,没有单 agent 对照组,也没有真人开发的工时对照。814 个测试说明测试规模,不能单独证明覆盖充分;4 个 Claude Code agent 分工,也不等于它们不会共享盲点。
作者报告,RV4 没有发现缺陷或要求修改的审查意见,agent 实际工作约 85 分钟;两个功能合计约 5.5 小时。RV1 从提出到合并用了 24 小时,其中约 12 小时在夜间等待作者合并,其余大量时间也在等产品决定。这些数字应区分「执行耗时」和「交付历时」,不能直接拿来估算团队产能。
人类介入从第一单的 12 次降到第二单的 1 次,方向很有吸引力,但第一单大多涉及初始化,第二单又受益于已有规则,样本不足以证明后续都能维持。
成本也没交代完整。原文没有提供模型版本、token 消耗、订阅费用或长期维护成本。ClickUp 免费 MCP 服务约每天 100 次调用,由全部 agent 共享,开发中途就触顶了;他们把报告暂存到 PR 评论,切换普通 REST API 后再回填。错误的脚本路径也曾让全部 agent 停下约 8 分钟。
作者实际运行在 Mac 上。通过 SSH 部署到 Linux、让服务器运行 agent 和数据库是给出的方案,尚未实测。「约 30 分钟搭起来」同样应看作作者的上手预期,不能当成通用交付承诺。
能拿来做什么
-
可以先给一个边界清楚的功能建立规格,例如原文准备的 RV5 主题切换,明确 light、dark、system 的行为,再让 agent 开发。先验证规格是否足够回答问题,比一次接入整套工具更容易判断收益。
-
在前后端协作中,先确认字段类型、未知字段、鉴权顺序和错误行为,再让前端使用类型化 mock。独立测试除了成功路径,还应检查并发请求和真实点击路径。
-
把 agent 指令和权限配置放进仓库,经 PR 修改;让测试断言的变更也有明确审核人。最终合并与共享数据库操作,应使用实际权限规则控制。
-
若准备复现原方案,原文使用
squad/templates/squad.template.yaml,运行./squad/setup.sh --root <folder with the four agent clones>,再在主房间发送@pm hello。同时记录调用成本、等待时间和人工介入次数,才能判断这套流程是否适合自己的项目。