给运维智能体标注每次修复的成败
该方案将历史事故拆为具体操作,为每项操作记录成功、失败或部分有效的结果,再通过 Hindsight 检索相似事故与失败经验。前端以记忆徽标、建议和避坑提示展示依据,后端结合 FastAPI、Postgres 与 SSE。
AI 深度解读
凌晨收到告警,最容易想到的操作往往是重启。但如果问题出在数据库连接池,重启又让缓存失效,原本局部的延迟问题就可能扩散。作者团队六周前踩过这个坑,复盘也写了,下一次值班却差点重来。
他们做了一个叫 RecallOps 的故障分诊系统,用 Hindsight 召回历史处理记录。真正值得借鉴的不是「给 AI 加记忆」,而是把失败操作拆出来、标清结果,再把警告放到工程师准备行动的位置。
为什么「故障已解决」反而可能误导 AI
一篇故障复盘通常包含多次尝试:先重启,没用;再扩容,效果有限;最后回滚配置,服务恢复。如果检索系统把整篇文档当成一个文本块,只知道这次故障「已解决」,就可能把前面的失败操作也召回为候选方案。
语义相似只能说明「这段话和当前故障有关」,不能证明「这个操作有效」。
作者因此把记忆拆到动作级别。每条操作分别记录 worked、failed 或 partial,不再给整个事件贴一个成功标签。下面这段类型定义解决的是结果归属问题:
export type Outcome = "worked" | "failed" | "partial";

export interface MemoryAction {
  text: string;
  outcome: Outcome;
}

export interface MemoryHit {
  id: string;              // e.g. "INC-1987"
  occurred_at: string;      // ISO timestamp
  summary?: string;
  actions: MemoryAction[];  // one outcome per action, never per incident
}
关键是 actions: MemoryAction[]:一个事件下面可以同时存在失败和成功的动作。occurred_at 则保留历史发生时间,供界面展示。
后端的 remember_fix_outcome() 把动作存入 Hindsight Cloud,默认 outcome="failed",并区分 failed_fix 与 successful_fix。失败动作如果没有传入 warning_directive,会自动生成包含操作、服务和故障特征的禁止建议。
写入通过 client.retain() 完成,参数包括 bank_id、content、context、metadata 和 tags;共享组织记忆库为 kartly-sre。随后,retrieve_unified_memory() 同时查询解决方案与失败记录,作者称其会阻止负面记忆被推荐为修复操作。
历史失败需要作为独立数据进入系统,不能只留在复盘叙述里。
不过,原文没有展示这道推荐约束的实现。标签便于区分记忆类型,单凭标签本身,还无法证明生成结果一定遵守禁令。
记忆要出现在操作旁边,不能藏在聊天长文里
RecallOps 的链路并不复杂:FastAPI 拉取告警、近期 Git 部署、容器日志和 PostgreSQL 遥测数据;LLM 结合 Hindsight 返回的历史记录,调用诊断工具;最后通过服务器发送事件(SSE)把过程推送到 Next.js 控制台。
前端接收的不只是一段最终回答,还包括 thought、tool_call、memory_hit、suggestion 和 error 等事件。界面据此更新实时轨迹、记忆面板与建议卡片。
作者最初也做过满屏 Markdown 的版本,但夜间 Sev-1 故障里,工程师很难逐段读完分析。后来他们把信息压到具体操作附近:Worked 用绿色,Failed 用红色,Partly worked 用琥珀色;明确的 Avoid 警告直接放进建议卡片,旁边提供 Accept、Reject、Correct。
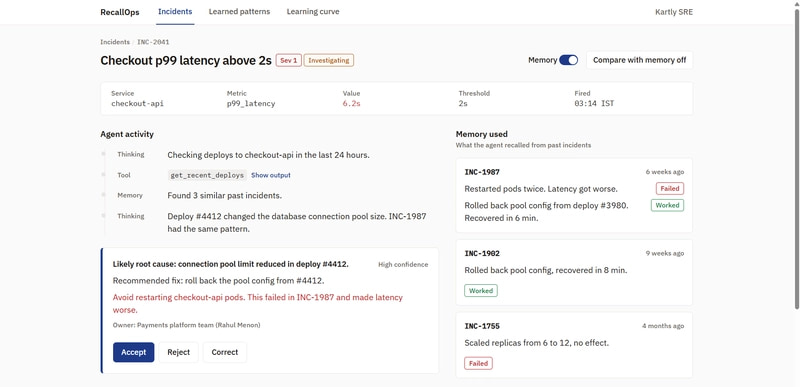
这类设计的价值,是让工程师在打开终端之前,看见「这个动作以前让情况更糟」。颜色用于快速识别,文字标签负责把含义讲完整。
另一个实用选择是记忆服务故障时继续分诊。原文的 reducer 展示了事件如何进入状态:
function reduce(s: TriageState, ev: TriageEvent): TriageState {
  switch (ev.type) {
    case "thought":
      return { ...s, steps: [...s.steps, { kind: "thought", id: ev.data.id, text: ev.data.text }] };
    case "tool_call":
      return { ...s, steps: [...s.steps, { kind: "tool", id: ev.data.id, tool: ev.data.tool, output: ev.data.output }] };
    case "memory_hit": {
      if (s.memories.some((m) => m.id === ev.data.id)) return s;
      return {
        ...s,
        memories: [...s.memories, ev.data],
        steps: [...s.steps, { kind: "memory", id: `mem-${ev.data.id}`, incident_id: ev.data.incident_id, occurred_at: ev.data.occurred_at }],
      };
    }
    case "suggestion":
      return { ...s, suggestion: ev.data };
    case "error":
      if (ev.data.stage === "memory") return { ...s, memoryError: ev.data.message };
      return { ...s, status: "failed", fatalError: ev.data.message };
    default:
      return s;
  }
}
重点看 ev.data.stage === "memory":它只设置 memoryError,不会把整个流程置为 failed。工程师会看到记忆不可用的提示,同时继续查看实时诊断。
some(...) 则按 ID 去重,避免断线重连后重复展示记忆卡片。它解决的是这类事件的重复插入,原文没有展示完整的 SSE 重连、补发和事件排序协议。
一次连接池故障,记忆改变了哪条建议
作者用 INC-2041 展示了差异。告警发生在 03:14 IST,服务是 checkout-api,指标 p99_latency 达到 6.2s,阈值为 2.0s。
近期部署记录中,commit #4412 把 db.pool.max 从 40 改成了 10。
关闭记忆时,系统虽然看到了部署信息,仍给出偏通用的判断:可能是 CPU、流量或数据库问题。建议依次检查 CPU、重启 checkout-api pods、增加副本。
开启记忆后,Agent 调用 get_recent_deploys,并召回了 43 天前的 INC-1987:
- 重启 pods 两次,延迟加重,标记为 Failed。
- 回滚部署
#3980的连接池配置,6 分钟恢复,标记为 Worked。
另一条 INC-1902 记录也显示,回滚连接池配置后 8 分钟恢复。
系统据此把根因指向 #4412 降低连接池上限,建议回滚该配置,同时明确警告不要重启 pods,因为这个动作曾在 INC-1987 中加剧延迟。
作者称,本次回滚后延迟在几分钟内恢复,但没有给出精确耗时。处理结束后,工程师再把恢复时长(MTTR)和备注写回 Hindsight,补上下一次检索需要的记录。
他们还在 /incidents/[id]/compare 同时运行有记忆和无记忆两条分诊流,让工程师直接比较建议。这个入口既是展示方式,也让团队能检查记忆究竟改变了什么。
我的判断
我认同作者对数据粒度和界面位置的判断。复盘中的失败尝试如果没有单独标记,检索系统确实容易丢掉「做过」与「有效」之间的区别。相比把整篇复盘塞给聊天助手,动作、结果、适用条件更适合支持现场决策。
但文章展示的是一组具体案例,没有提供多次运行、统一模型配置或误推荐率等对照数据。作者称比较视图促进了团队采用,也没有给出采用率。因此,「团队认为有帮助」可以成立,「稳定降低 MTTR」还缺少证据。
还有一个容易被标题带过去的区别:案例里,有记忆分支得到的是明确的失败记录和有效回滚方案,无记忆分支拿到的上下文更少。差异可能来自结构化记录、额外上下文、提示约束和界面共同作用,不能全算在 Hindsight 或徽章上。
一次操作失败,不足以推出所有同类故障都禁止这个操作。
连接池配置变更、缓存状态和服务依赖关系,都是判断能否沿用旧经验的条件。原文虽把 service_name、signature 放进警告,却没有交代条件匹配、过期记录和矛盾经验如何处理。
对于规模较小的团队,先用结构化复盘表或现有工单系统记录动作结果,也能落实这篇文章最有价值的部分。是否引入专门记忆服务,应看检索需求和维护成本;原文没有提供这方面的比较。
能拿来做什么
- 给现有复盘模板增加操作明细,逐条记录执行内容、
worked / failed / partial、观察结果和适用条件,让后续 AI 检索能分清尝试与有效方案。 - 做 Next.js 或 React 运维助手时,把历史失败放在建议操作附近,用文字标签和明确警告表达,减少值班人员从长回答中寻找风险信息的负担。
- 给 SSE 消费层区分记忆检索错误与致命错误,并按事件身份处理重复消息,让历史服务暂时不可用时,实时诊断仍能继续。
- 用同一条故障输入比较有记忆和无记忆的建议,记录它们是否识别配置变更、是否重复失败操作,再判断记忆功能是否值得继续投入。