四进程部署缓解LLM服务并发首字延迟
作者将Uvicorn从单进程调整为四进程,并用646次线上请求验证并发排队问题:5用户并发时首字延迟由13.64秒降至5.87秒。摘录显示单用户速度起初改善有限,说明并发排队与单请求耗时需要分别定位。
AI 深度解读
把 LLM 服务从 1 个 worker 加到 4 个,5 人并发时的首字延迟从 13.64 秒降到 5.87 秒,单人请求却几乎没变。作者在 Vicquant 生产系统里的排查表明:增加进程能缓解排队,但一个请求内部的同步数据库访问、跨地域网络往返,仍会照常耗时。
这篇最值得读的是排查路径:先测并发退化,再拆服务端耗时,最后区分数据库执行、网络传输和模型生成。不过,文中的部分数字存在口径或算术问题,结论可以借鉴,精确归因需要保留判断。
为什么加了 4 个 worker,单人请求还是慢
作者最初发现,首 token 延迟(TTFT)从单用户的 3.16 秒,恶化到 5 人并发时的 13.64 秒,退化 4.31 倍。当时 Uvicorn 配置为 WEB_CONCURRENCY=1,请求在进入模型之前,还要完成鉴权、限流、RAG 和流连接初始化。
问题是,这些准备工作里混着同步操作,会占住处理其他请求的机会。FastAPI 支持异步,不代表写进处理函数的每一步都会自动异步执行。
作者将配置改为 WEB_CONCURRENCY=4,并在包含远程数据库、语义缓存、RAG 和流式输出的 Condition D 下,对 c=1、3、5 进行对照测试,跨高峰与非高峰安排了 646 次线上请求。
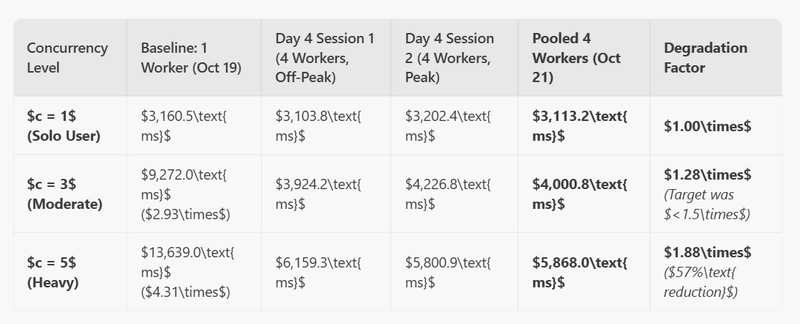
c=3 时,延迟退化倍数从 2.93 降至 1.28;c=5 时,TTFT 从 13.64 秒降至 5.87 秒,减少 7.77 秒。但 c=1 只从 3,160 ms 变成 3,113 ms。
worker 数量增加的是同时处理请求的容量,不会自动缩短单个请求的执行路径。
还要区分「排队明显缓解」和「排队完全消失」。1.28 倍仍然存在退化,仅凭这个结果,不能认定所有等待都被消除了。
模型调用前的近 1 秒,花在了哪里
作者用 time.perf_counter() 记录各阶段耗时,通过 TIMELINE_TRACE 写日志,并在 SSE 的 done 事件里返回计时信息。合并后的服务端瀑布图包含 n=408 个样本。
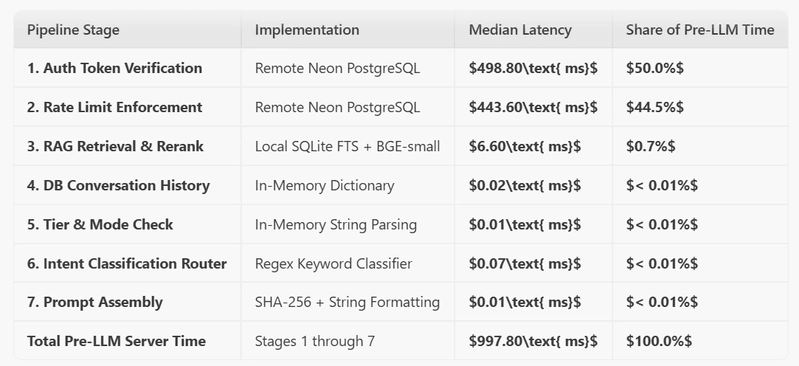
内存里的历史加载只需 0.02 ms,套餐校验只需 0.01 ms;本地 SQLite RAG 检索加 cross-encoder 重排约为 6.6 ms。真正的大头是鉴权与限流,两者合计 942 ms,占模型调用前耗时的 94% 以上。
数据库本身却不慢。作者通过 Neon 的 EXPLAIN ANALYZE 检查,发现 SQL 执行不足 2 ms。慢在应用与数据库之间:Render 位于 Oregon 的 us-west-2,Neon 位于 Ohio 的 us-east-2,跨地域一次往返约 65–75 ms。
鉴权和限流分别使用一个 with connect_database() as conn: 块,SQLAlchemy 开启了 pool_pre_ping=True。按照作者的连接生命周期分析,每个块要经历:
SELECT 1探活,约 70 ms。BEGIN开启事务,约 70 ms。- SQL 查询,约 70 ms 网络耗时加 2 ms 执行。
COMMIT / ROLLBACK,约 70 ms。
两个块合计 8 次顺序往返。一次看似便宜的连接检查,放到跨地域链路上,就会反复支付网络成本。不过,8 × 70 ms 约为 560 ms,还不能单独解释全部 942 ms;原文没有完整列出剩余差额。
更关键的是,这些同步 SQLAlchemy 调用位于 async def 声明的 chat_stream 中,会在等待数据库时阻塞 asyncio 事件循环。原文称阻塞约 950 ms。
负载增加后,pre_llm_total_ms 也在增长:c=1 为 945.0 ms,c=3 为 1,103.9 ms,c=5 达到 1,359.8 ms,增幅约 44%。4 个 worker 缓解了进程间排队,但多个请求落到同一进程时,仍可能互相阻塞。原文没有提供逐进程请求轨迹,因此不能把「第 5 个请求」理解为固定的分配顺序。
把阻塞移出事件循环后,还剩什么成本
作者随后同时做了两项修改:用 asyncio.to_thread(...) 包装同步数据库操作,将阻塞 I/O 交给工作线程;增加线程安全的内存 token 缓存 _AUTH_USER_CACHE,TTL 为 5 分钟。
两者解决的问题不同。线程转移让事件循环在数据库等待期间继续处理其他请求;缓存命中则直接省掉一次鉴权数据库访问。
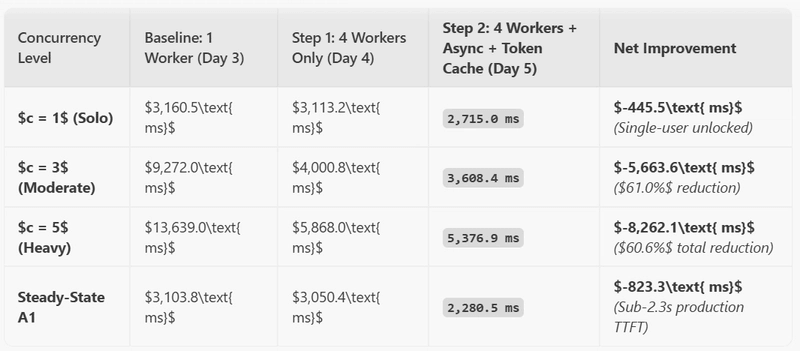
Day 5 的高峰、非高峰测试中,鉴权从 498.80 ms 降至 0.22 ms,模型调用前总耗时从 997.80 ms 降至 474.06 ms。作者报告 c=5 的 TTFT 进一步降至 5,376.9 ms,相比最初 13.64 秒降低约 60.6%;单用户结果则写为 3,103 ms,仍与前面的 3,113 ms 接近。
后文又给出一次客户端 TTFT 为 2,280.5 ms 的分解:
| 环节 | 原文报告耗时 |
|---|---|
| 客户端到 Render 的往返基线 | 814 ms,入站、出站各估 407 ms |
| 模型调用前的服务端处理 | 474 ms |
| Render 到 OpenRouter 的出口握手 | 140 ms |
| 推理引擎内部 TTFT | 618 ms,在 Condition B 中测得 |
| SSE 封装与缓冲释放 | 正文 227 ms,求和式 234 ms |
采用 234 ms,合计为 2,280 ms;采用 227 ms,则是 2,273 ms。474 ms 的内部拆分也有疑点:限流 421 ms、RAG 7 ms、提示词组装 0.02 s,加起来只有 448 ms。
这些数字适合帮助定位量级,还不足以支持「每一毫秒都已解释」。尤其原文没有交代清楚,2,280.5 ms 与单用户 3,103 ms 分别对应哪个统计口径。
我的判断
最有价值的结论是:先分清等待发生在哪一层。增加 worker、移走同步 I/O、缓存鉴权结果,分别影响容量、事件循环响应和实际访问次数,不能混成一个优化动作看待。
但这次同时引入线程转移和缓存,没有独立对照,无法确认各自贡献了多少。鉴权降到 0.22 ms,也不能当成缓存未命中时的性能保证。它有生产测量支撑,因果拆分仍不充分。
asyncio.to_thread 适合继续使用同步数据库代码的改造路径,异步驱动也是可比较的方案;原文没有两者对照数据。多进程下,线程安全也不等于缓存跨进程共享,token 撤销如何与 5 分钟 TTL 配合,作者同样没说清。
实验记录值得肯定。10 月 21 日 Day 4 Session 1 中,客户端 ISP 在 batch #176 发生中断,42 次请求记录为 HTTP status 0,作者称它们未到达 Render;Session 2 完成 323/323,Day 5 完成 646/646。
与此同时,WAN 基线从 10 月 19 日的 541 ms,变到 10 月 21 日 Session 2 的 1,166 ms,再到 10 月 23 日两场的 899 ms、814 ms。网络波动足以盖过部分应用收益,跨场次结果需要结合会话中位数看。把往返时间平均分成两个 407 ms,也是估算,不能当作单向实测。
能拿来做什么
- 给流式 AI 接口同时记录客户端 TTFT、服务端模型调用前耗时和上游首 token 等待时间,再按鉴权、限流、检索拆分,先找到最大的耗时段。
- 检查 Python
async def中是否直接调用同步数据库或其他阻塞 I/O。前端经 Node 中转请求时,也应检查中转层的同步操作,不能只盯着模型响应。 - 排查远程数据库时,同时看 SQL 执行时间、部署地域和顺序往返次数。查询不足 2 ms,并不代表一次数据库访问也只花 2 ms。
- 分开验证线程转移和 token 缓存,并记录缓存命中、未命中及不同并发下的结果,避免把组合收益误判为单项优化效果。