TRELLIS.2 实测:16GB 显存之外的代价
作者在 RTX 5070 Ti 上完成 24 次生成,原生 GLB 导出成功 23 次;一次失败报告设备未就绪,不能直接判定为显存不足。一次成功的高分辨率导出出现 10.30 GiB 共享 GPU 内存占用,文章还分别检查资产内容、Blender 导入和 Three.js 加载。
AI 深度解读
TRELLIS.2 能在 16GB RTX 5070 Ti 上跑出真正的 1536 分辨率结果,但不能据此认定整条流程只用了 16GB 本地显存。作者完成了 24 次生成,原生 GLB 导出成功 23 次;后来一次成功运行中,Windows 还记录到 10.30 GiB 共享 GPU 内存。
这组实验值得读,是因为作者继续追到了文件校验、Blender 重开和 Three.js 加载。对准备把 AI 生成模型放进网页的程序员来说,「生成成功」离「可以交付」还有几道关。
16GB 能跑通,为什么还不能说够用
微软固定版本的 TRELLIS.2 README 要求 Linux 和至少 24GB GPU 内存。这次 Windows/WSL2 实验没有改写这个要求。
作者使用 RTX 5070 Ti 16GB、617.42 驱动和 Ryzen 9 9950X。Windows 11 Pro 可见约 61.65 GiB 系统内存,WSL2 中的 Ubuntu 24.04.2 限制为 30.18 GiB RAM、8 GiB swap。软件环境是 Python 3.12.3、PyTorch 2.8.0+cu128、CUDA 编译器 12.8.93、FlashAttention 2.8.3.post2 和 Transformers 4.57.1。
输入是水壶、盆栽、长椅三张透明背景的 768×768 Blender 渲染图。两条路径固定相同权重、seed 42、默认 12 步采样、低显存卸载和 49,152 token 上限,分别请求 512、1024、1536 档位。返回网格都匹配请求,没有靠降档完成。
主实验是三种输入×三个档位×两条源码路径,共 18 个独立 Python 进程,启用 expandable_segments:True;另有 6 次水壶实验复查默认分配器。社区路径取自 Espalier 的旧 MIT 许可修订,采用核心大小 256 体素、边缘余量 8 的分块解码,并非测试当前分支或完整封装。
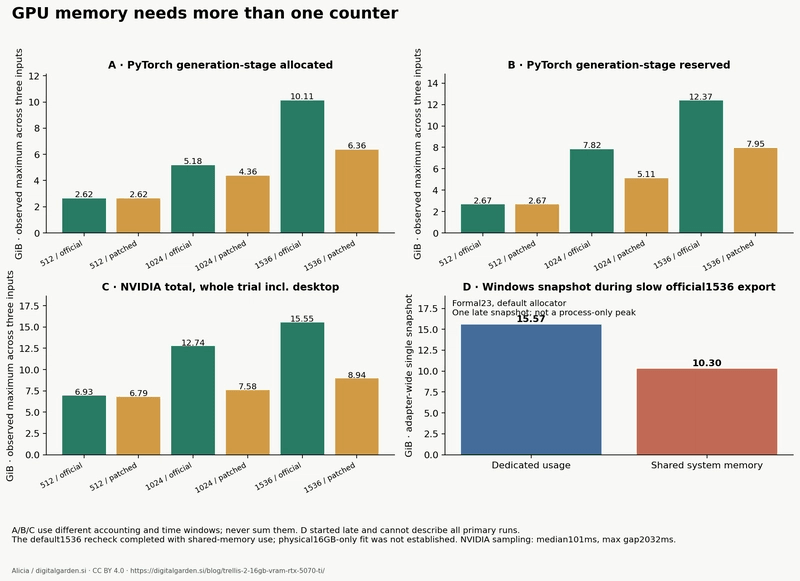
关键证据出现在内存统计里。正式实验 23 的一次 Windows 快照显示,专用 GPU 内存用了 15.57 GiB,共享 GPU 内存用了 10.30 GiB。共享部分涉及系统内存,不能算作显卡自带显存。
跑完任务,只证明这套机器完成了任务,不能证明全程装得进 16GB 本地显存。
PyTorch 的 allocated 是张量占用,reserved 是分配器保留块,二者也不能直接替代整卡统计。默认分配器的 1536 生成曾报告 18.78 GiB reserved,这个数字同样不能直接当成物理显存占用。
NVIDIA 采样记录了 56,381 行有效数据,目标间隔 100 ms,实际中位数 101 ms,最大间隔 2,032 ms,可能漏掉短峰值。Windows 计数器又是后期才加入的。作者没有检查或修改驱动的系统内存回退设置,因此具体回退机制仍未确认。
生成完了,为什么 GLB 仍然可能交不了
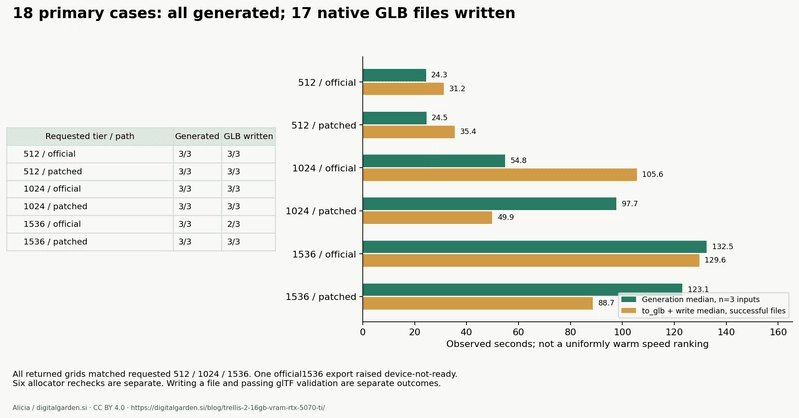
24 次生成全部完成,原生导出写出 23 个 GLB。失败的一次报 CUDA driver error: device not ready,没有出现字面意义上的 OOM 异常,不能直接把它归为显存不足。
导出设置保留官方示例:目标 1,000,000 三角形、4096 纹理、重网格化、band 1、projection 0 和 WebP 输出。计时前还应用了 16,777,216 面的安全上限。
交付目标小,不代表中间过程也小。一次默认分配器的官方 1536 复查中,安全截断后的网格仍有 15,538,939 个面,重网格化时临时膨胀到 36,114,868 个面。生成耗时 121.20 秒,导出及写盘耗时 475.52 秒,试验运行器内总耗时 697.85 秒,算上外层调度约 700 秒。
导出才是这次运行的大头。
失败任务已保存真实的 1536 原始结果,包含 9,103,700 个顶点和 18,252,884 个面。作者用三个独立的纯导出控制实验复用它,无须重新加载生成模型;这些控制实验不计入 24 次完整流程。
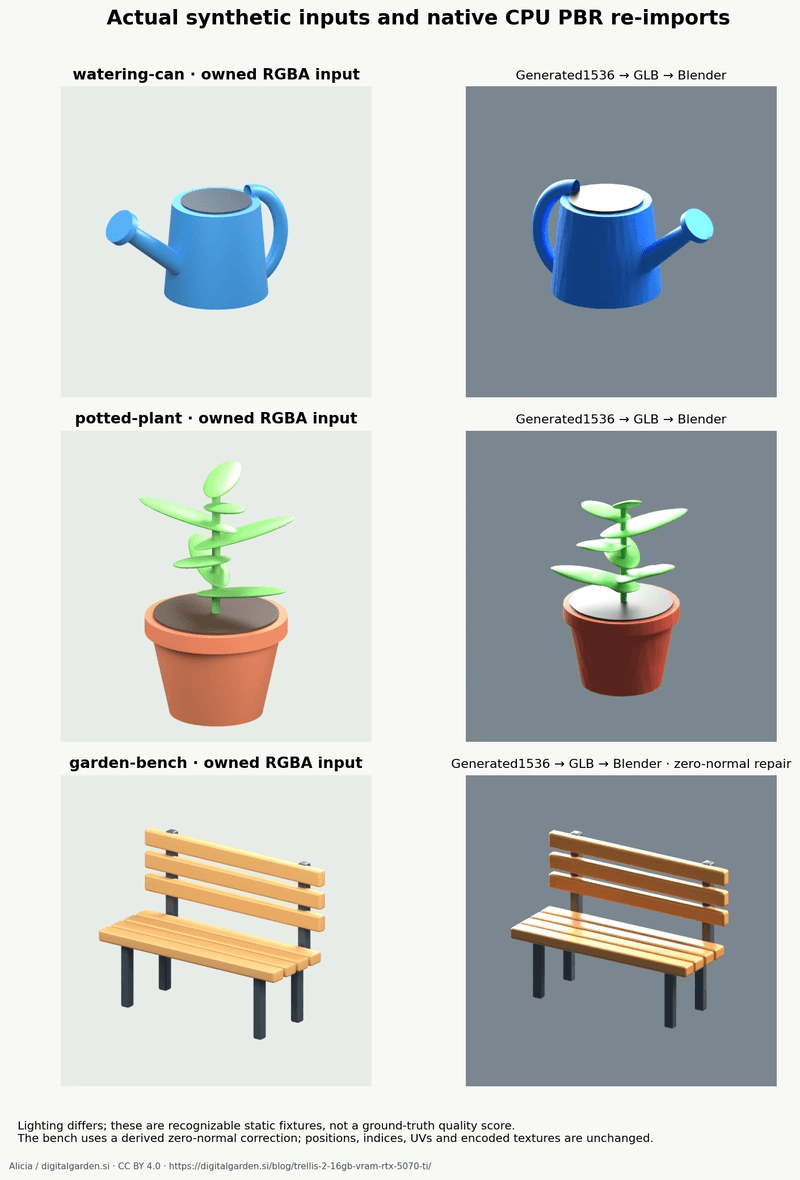
文件写出来之后还有问题:23 个原生文件中,17 个校验无错误,6 个含零长度法线;两个恢复文件也有同类问题。作者保留原件,另建 8 个修正版,仅替换 21 个完全为零的法线向量,位置、索引、UV、非零法线和编码纹理字节保持一致。修正版全部通过 glTF 校验。
这项修复没有处理拓扑或退化三角形,也不构成生产质量认证。六个 Blender 场景虽已保存、重开并重新渲染,但 Blender 导入会丢弃部分退化三角形:代表性水壶从 989,733 个三角形变成 989,723 个,不能据此宣称无损往返。
放进 Three.js,真正要控制的是交付预算
浏览器实验只选了一个高分辨率水壶。原生 GLB 为 35,546,480 字节,989,733 个三角形,带两张 4096 WebP 贴图。
网页基线先焊接顶点,再以简化比例 0.1、误差上限 0.001 减面,纹理改成两张 2048、质量 95 的 WebP。最终保留 154,568 个三角形,并不是按比例想象出来的约 100,000 个。
Meshopt 和 Draco 都从这个网页基线出发,声明位置 14 bit、法线 10 bit、UV 12 bit。原生版到网页版本已经改变几何和纹理,因此四个文件不能当作同一资产的四种无损编码来比较。
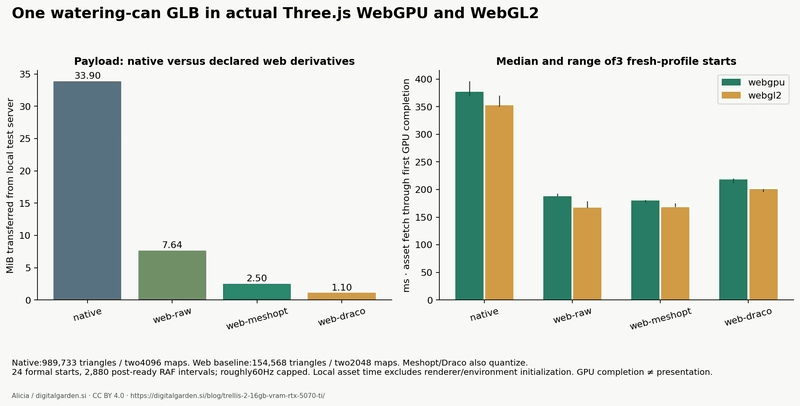
测试使用 Chrome 156 headless、Three.js 0.186.1,视口 1280×720、DPR 1。四个文件分别在 WebGPU、WebGL2 下启动,每种组合用三个全新浏览器配置,共 24 次。
全部启动通过,2,880 个就绪后的 RAF 间隔也通过检查,没有空白捕获或 JavaScript 页面错误。但计时范围是本地资产获取到首次 GPU 工作完成,渲染器和程序化环境初始化发生在计时之前,也没有测量画面真正显示到屏幕的时刻。约 60 Hz 限制下,帧间隔集中在 16.7 ms 附近,不能用于排列无帧率上限时的 GPU 性能。
纹理还藏着另一笔账。两张 RGBA8 贴图加理想 mip 链,4096 尺寸约需 170.67 MiB,2048 约需 42.67 MiB。这是逻辑估算,不是驱动显存实测,却足以提醒前端开发者:WebP 下载小,不代表解码后驻留也小。
我的判断
这篇最有用的地方,是把生成、导出、格式校验和浏览器加载分别验收。每一步回答的问题不同,前一步成功不能代替后一步。
分块解码降低了高档位生成的观测分配量,补丁导出也恢复了失败的原始结果,这些有实验支持。但它还不足以证明社区路径普遍更快、更省内存。只有官方 512 预实验提前预热,其他路径可能继续编译内核,磁盘缓存持续保留;补丁版 1024 的生成中位数甚至更慢。后续默认分配器复查的 1024 耗时分别为 43.96 秒和 45.10 秒,也不能把差异单独归给分配器。
质量结论同样有限。九组原始结果配对中,三个 512 案例对齐后的属性完全相同,其余部分存在差异,最大属性差为 0.0016203。双向各取 20,000 个顶点探测,最大采样距离为 5.54×10⁻⁶ 归一化场景单位;它不是完整表面的 Hausdorff 距离,也缺少同一路径随机重复实验来分离误差来源。
样本只有三个自有合成输入、一个固定种子、一台桌面机,浏览器对比更只有一个资产。作者也没有迁移生产站点。它适合指导本地验证,不能直接外推成硬件采购结论或生产方案。
能拿来做什么
- 给生成流程保留原始结果,并把生成与导出拆成可独立重试的阶段。导出报错时,先复用已有结果,避免重新承担模型加载和生成成本。
- 在资产进入前端仓库前运行 glTF 校验,并保留原件与修正版的映射。能在 Blender 打开,只是验收的一部分。
- 为 Three.js 页面单独制作交付版本,明确三角形数、纹理尺寸和压缩参数,同时检查实际输出;不要把简化比例直接当成最终面数。
- 测试加载速度时写清计时起止点,分别记录下载体积、纹理驻留估算和首批 GPU 工作完成时间,让不同版本的比较有共同口径。