多机并行 AI 编程的仓库隔离方案
文章建议每台服务器保留独立 clone,每个任务使用独立 worktree 和分支,避免多个 AI 会话共享目录造成覆盖与状态混乱。结合 TaskHandoff,介绍节点管理、反向 WSS 连接及首次配对凭据的使用边界。
AI 深度解读
多台服务器一起跑 Codex,先要解决的是任务放在哪个目录,以及出了问题该查谁的改动。原文围绕 TaskHandoff 给出的方案很明确:每台节点保留自己的 clone,每个并行任务使用独立 worktree 和分支,最后分别验收。
这套做法值得参考的地方,是把文件隔离、会话位置、远端同步和目录清理串成了流程。但它没有给出并行效率或冲突率的对照数据,更适合作为操作方案来读。
多节点并行,为什么不能共用一个 worktree
两个 AI 会话共用工作目录,问题不止是同时改文件。依赖变化、未跟踪文件和测试失败都会混在一起;编辑器还可能因为文件已被其他进程修改,阻止保存。即使最终代码没丢,也很难判断一次失败属于哪个任务。
Git worktree 为同一个仓库提供独立工作目录,让任务各自编辑、测试和提交。但它仍依附于某台机器上的仓库 clone,不负责跨机器同步文件。
原文用下面的结构说明多节点该怎么分:
同一远端仓库
   ├── 节点 A 的 clone → worktree A-1(分支 feature/a)
   └── 节点 B 的 clone → worktree B-1(分支 feature/b)
要注意两行里各自独立的 clone。节点之间通过远端仓库交换提交,各自维护本地目录。
一个任务一个 worktree,解决的是并行执行时的目录隔离。
TaskHandoff 的 Control Plane 把多个节点、实例和会话集中展示,方便按节点、项目和状态查看;它不会因此把不同服务器的文件系统变成同一份。直接复制 worktree 目录,还会带来身份、缓存和未跟踪文件的不一致。
会话建在哪里,比选哪个 Agent 更早决定边界
原文的执行层级是:节点运行 Node Agent,每台参与并行的服务器创建自己的 Docker 实例,再 clone 同一个远端仓库。一个节点可以承载多个任务,关键是让各任务拥有自己的 worktree。
远程节点通常通过反向 WSS 连接,由 Node Agent 主动连接 Control Plane,无须给节点开放公网入站端口。一次性加入 Token 只用于首次建立信任,不应进入脚本仓库、工单或日志。
Git 凭据也有单独边界:按 remote scope 匹配权限;HTTPS token 仅在 credential-helper 请求期间短暂提供,不写入 remote URL、命令行或环境变量;SSH 私钥留在 Node Agent,实例只获得签名能力。这些属于原文描述的产品机制,文中没有提供独立验证过程。
创建任务时,从已有 Git 会话进入「环境 → 工作树」,选择「新建托管工作树 AI 会话」,填写新分支名称和起始引用,再选择 Codex 或 OpenCode。
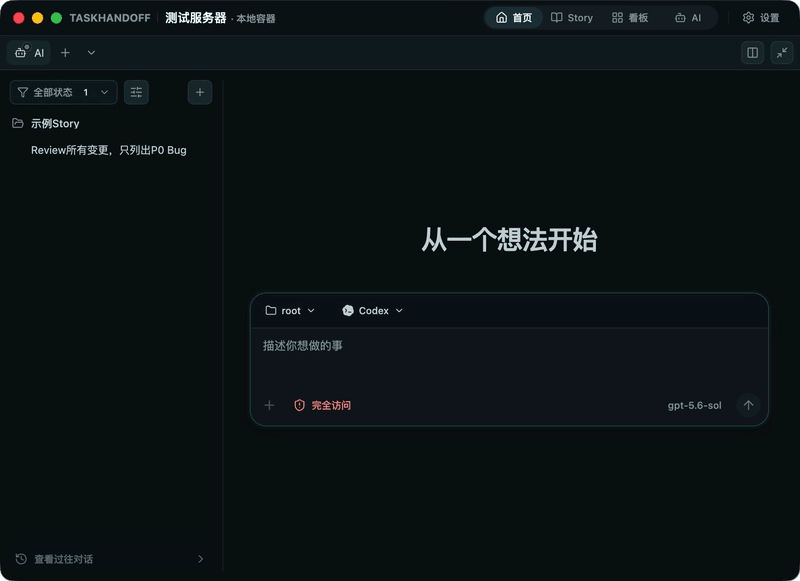
这里最容易误判的是会话位置:新建 worktree 会生成新会话,原会话仍留在原目录。会话创建后,工作目录不会自动改变。要切换任务目录,就在目标 worktree 上新开会话。
分支名可以直接对应目标,例如 feat/api-timeout、fix/windows-paths。任务分配到哪台服务器,则取决于 Docker 镜像、系统工具、GPU、网络可达性、权限边界和机器能否持续在线。
隔离之后,还要分别验收和清理
worktree 分开了,验收也要分开。每个目录都应独立检查测试和 diff,确认后再提交、推送,才能保留清晰的归因路径。
TaskHandoff 对远端操作采取保守策略:Pull 仅允许 fast-forward,不自动 merge、rebase 或 stash;分支分叉时阻止自动同步,永远不 force push。复杂冲突、已分叉分支、大型或二进制 diff,需要回到对应会话的终端处理,再刷新仓库页面。
清理也有条件。托管 worktree 必须是非主工作树、无修改、未锁定,而且没有活跃的 AI 或应用会话,才能删除。删除使用非 force 方式,移除目录后保留关联分支。
外部 worktree 只有位于实例授权目录且仍可访问时才能使用,系统不会接管或删除它。主工作树、有未提交修改或仍被会话占用的目录,也不能从界面删除。这些限制把「结束任务」变成了明确步骤:关会话、检查改动、再清理目录。
我的判断
我赞成先隔离目录,再讨论并行度。它把改动来源固定到任务上,比要求多个会话自行协调文件更容易检查。
但worktree 能隔离编辑过程,不能保证合并时没有冲突。 两个任务即使位于不同服务器,也可能修改同一接口或同一段逻辑,最后仍需处理集成问题。原文没有给出吞吐量、冲突率或成本对照,因此不能据此断言多服务器一定更快。
普通团队也未必需要立刻引入多节点。同一台机器上的多个 worktree,就能处理原文列出的多数目录冲突。多节点更适合确实存在运行环境、网络位置、权限或持续运行需求的任务。TaskHandoff 的主要价值,是把这些位置和状态集中管理;具体收益还要看团队规模与运维成本。
能拿来做什么
- 同时让 Codex 或 OpenCode 处理多个任务时,为每个任务创建独立 worktree 和目标明确的分支,并确认会话启动目录正确。
- 两个任务需要修改同一批文件时,先调整任务边界,必要时串行执行;不要把目录隔离当成集成冲突已经解决。
- 分配远程任务前,检查对应节点能否访问仓库和依赖,以及是否具备所需 Docker 镜像、工具或 GPU。
- 把测试、diff 审阅、提交和清理放进每个任务的收尾流程,确认无修改、无活跃会话后再移除托管目录。