让编码智能体先查文档,再规划实现
作者用 Context.dev、TypeScript、OpenCode 和 OpenRouter 搭建先研究后编码的智能体。流程先检索技术资料、提取文档并形成研究简报,再交给模型生成实现计划与代码。
完整中文译文
AI 写代码时,最麻烦的错误往往不是语法错误,而是拿旧知识调用新 API,或者把不同版本的用法混在一起。作者在 Mac mini 上搭了一个 TypeScript 编程代理,尝试把顺序改成:先查资料,再做计划,最后生成代码。
这次实验跑通了联网检索和代码生成,但还没有验证生成的 HTTP 客户端是否可靠。值得看的,是它怎样把文档接进编程流程,以及哪些测试通过了、哪些能力仍停留在设想。
先查文档,究竟给代码生成补了什么
作者的核心主张是:让模型先获得与任务相关的技术资料,再决定如何实现,减少完全依赖训练知识带来的偏差。
这对有版本差异的开发任务尤其有用。模型可能知道某个库,却不知道当前项目使用哪个版本,也未必记得这个版本的参数和错误处理约定。生成结果看着合理,接进去才发现接口对不上。
作者选的任务很具体:实现一个支持重试和超时的 TypeScript HTTP 客户端。代理需要先研究 HTTP 客户端实现、重试策略和超时处理,再给出计划与代码。
整套流程有四个角色:
- Context.dev 负责搜索网页、获取文档内容。
- TypeScript 承载代理的实现。
- OpenCode 帮作者把检索流程接入项目。
- OpenRouter 提供兼容 OpenAI API 的模型入口。
这里要分清,OpenCode 是作者搭建项目时使用的编程工具,运行时的文档研究由 Context.dev 完成,后续规划和生成由接入的模型完成。
项目通过 npm init -y 初始化,安装 context.dev、dotenv,开发依赖是 typescript、tsx、@types/node,再运行 npx tsc --init。作者用 npm pkg set type="module" 启用 ESM,开发命令为 tsx src/index.ts,类型检查为 tsc --noEmit。
这些初始化步骤很常规。真正影响生成质量的,是模型拿到的资料如何筛选和组织。
搜到十个来源,不等于读懂十份文档
作者把 Context.dev 请求集中放在 src/context/client.ts,处理认证、重试和额度跟踪;src/research/researcher.ts 则负责搜索、URL 排序、抓取正文,以及整理研究简报。
研究简报就是把检索结果加工成模型能直接使用的任务材料。原文没有展示它的完整格式,也没有解释 URL 排序算法,所以目前只能确认存在这条处理链,不能判断筛选质量。
作者先执行了 npm run check、npm test 和 npm run dry-run。类型检查通过,34 个自动化测试通过。dry-run 使用预置数据演练查询生成、来源排序、内容收集和计划输出,不调用真实 Context.dev API。
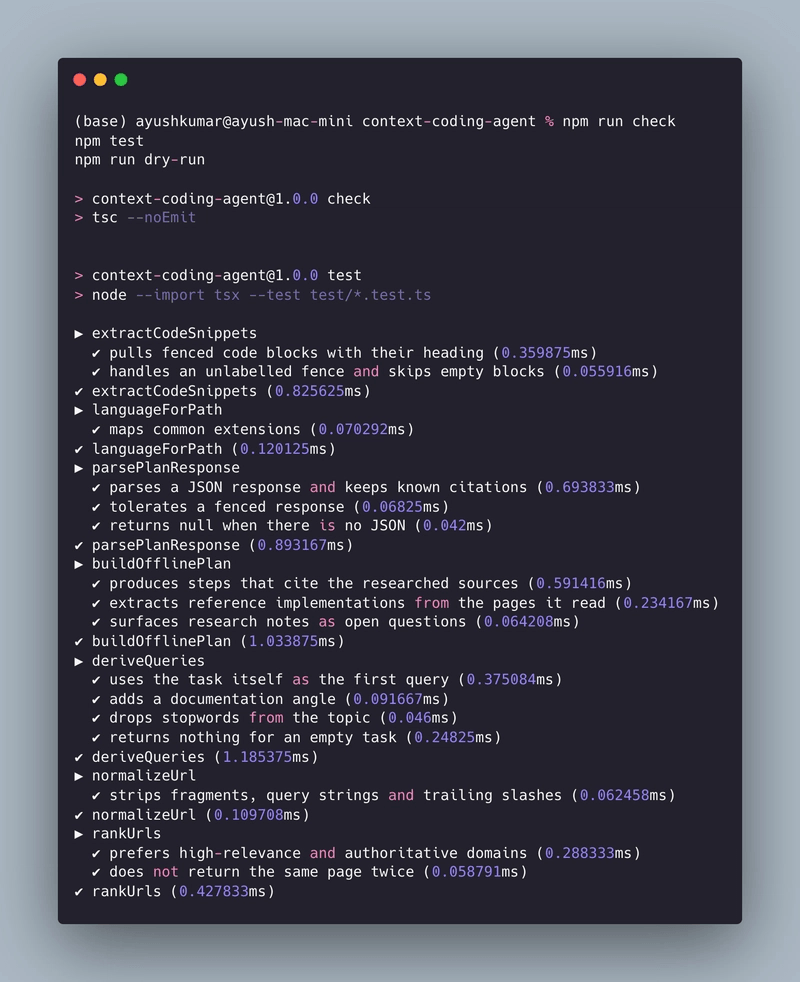
这里的边界很重要:dry-run 展示的来源和额度都是模拟数据,不能用来证明真实检索效果。
随后,作者通过 npm run dev -- "Build a TypeScript HTTP client with retry handling and timeouts" 发起真实任务。Context.dev 返回 8 个来源,包括 Ky 仓库和重试、超时相关文档,代理完整读取其中 2 页,生成了 5 步计划。
这次消耗 8 个 credits,剩余 966。原文没有交代之前的请求明细,不能据此推算整个实验的总成本。文中提到注册免费档宣传包含每月 1,000 credits,也明确要求以账户实际套餐为准。
由于当时没有配置 LLM API key,这次运行使用离线规划器,只输出带参考实现的计划,没有生成完成的源文件。
联网检索跑通,只能证明资料能进入流程,还不能证明模型已经用这些资料写对了代码。
接上模型之后,作者实际交付到了哪一步
作者通过 OpenRouter 接入模型。项目已经支持兼容 OpenAI 的 chat completions,因此无需再引入一个 SDK。
下面的配置把模型入口切到 OpenRouter,密钥仍由本地 .env 提供:
OPENAI_API_KEY=your_openrouter_api_key
OPENAI_BASE_URL=https://openrouter.ai/api/v1
OPENAI_MODEL=minimax/minimax-m3.1-flash:free
要看的是 OPENAI_BASE_URL 这一行:使用 OPENAI_API_KEY 这个变量名,并不代表请求发往 OpenAI;目标地址由这里决定。
作者测试连接时遇到过空响应,将原因归于模型推理与输出限制,随后改用低推理强度和固定的 temperature 设置。原文没有给出具体参数值、请求体和响应处理代码,这部分无法直接复现,也不能照着补出一套参数。
接入后,npm run check 再次通过,自动化测试从 34 个增加到 45 个。然后作者显式指定 LLM 模式,重新运行同一任务:
npm run dev -- --mode llm "Build a TypeScript HTTP client with retry handling and timeouts"
这里要看 --mode llm:作者检查了最终运行模式,确认此次没有回退到离线规划器。
这次检索返回 10 个来源,仍然只完整读取 2 页。模型输出了 4 步计划:定义客户端和请求类型,实现超时与取消,加入指数退避重试,导出客户端及类型。
它还生成了拟交付文件 src/http-client.ts 和 src/index.ts。按作者描述,代码包含可配置超时、重试上限、指数退避,以及调用方传入取消信号的支持。
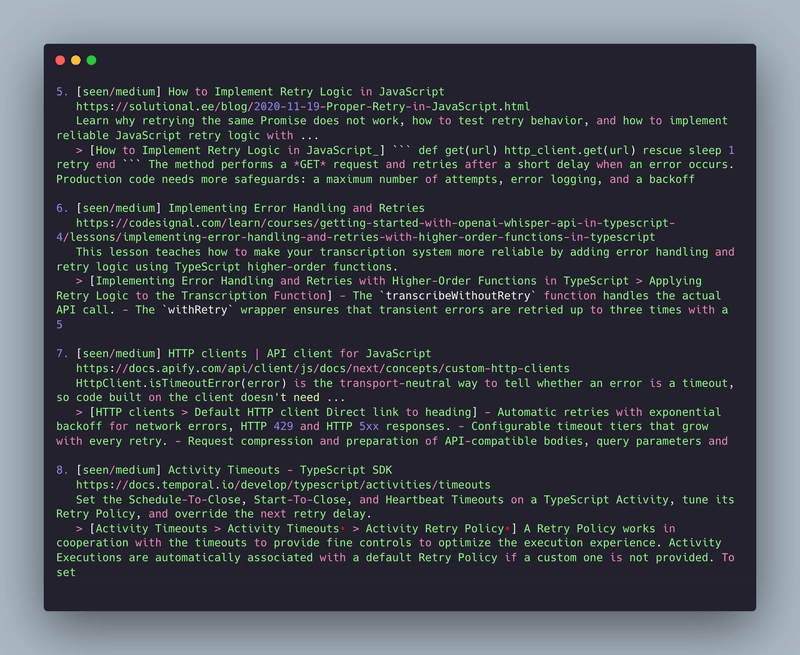
但原文没有贴出生成的 HTTP 客户端源码,因此无法检查这些行为的具体实现。作者也明确说,尚未把生成代码集成进项目,更没有为这个客户端运行专门的实现测试。
45 个测试通过,验证的是代理项目已有检查,不能当成生成的 HTTP 客户端已经通过验收。
我的判断
我赞成把文档研究放到生成之前,尤其是升级依赖、使用不熟悉的 API、处理超时和取消这类任务。先拿到约束,再让模型实现,比只给一句需求更容易审查:至少能追问某个实现决定依据哪份资料。
不过,作者没有提供「直接生成」与「先检索再生成」的对照结果,也没有统计缺陷率、完成时间或模型调用费用。所以「研究优先能改善多少代码质量」,目前仍是经验判断。
检索本身也有前提。找到了相关页面,不代表找到了目标版本的官方文档。作者把优先选择官方资料、匹配版本列为后续改进,恰好说明当前流程尚未充分解决这个问题。对一般团队而言,仓库锁定的依赖版本、现有封装和测试约定,也需要进入上下文;网页资料不能替代项目事实。
相比另建一个代理,给现有编程工具补充准确的文档片段和项目约束,成本可能更低。这篇实验更适合借鉴流程拆分方式,暂时不足以证明必须采用 Context.dev、OpenRouter 这套组合。
作者接下来计划加入受控文件写入、生成代码的自动检查、测试失败反馈和隔离执行。这些方向都合理,但尚未完成。当前成果应当定位为「研究后提出代码」,距离能够独立完成并验收任务的代理还有一段距离。
能拿来做什么
- 在前端或 Node 项目接入陌生依赖前,先让 AI 列出当前依赖版本、相关官方资料和实现约束,再生成计划。审查时检查资料是否对应项目版本,而不是只看搜索结果数量。
- 如果要搭建类似代理,可以把检索客户端和研究模块分开,并提供基于预置数据的 dry-run。这样能先检查流程衔接,再用真实请求确认认证、额度和正文获取是否正常。
- 对这类 HTTP 客户端,应该单独验证重试、非 JSON 响应、超时和调用方取消。把这些测试作为生成代码的验收条件,不能用代理自身的测试结果替代。
- 让代理先输出候选文件供审查,再推进文件写入、自动检查和失败修复。作者尚未验证自动落地能力,照着实践时也应保留这一阶段边界。