小模型词表裁剪如何降低推理成本
文章讨论通过定制小语言模型词表降低推理成本,并称实际应用中的降幅可达77%。输入未提供具体实现、成本口径及效果损失数据。
完整中文译文
把一个 4B 模型微调成专用评分器后,还能从哪里省推理成本?Dharma-AI 团队把目光放到了分词器(tokenizer):针对固定语言和 JSON 输出重建词表,保留同一个基座模型,在他们的生产评分任务测试中,推理成本下降了 77.0%。
这篇文章最有用的地方,是解释了为什么「少几个 token」不能直接等同于「省多少钱」,以及为什么压缩过头反而会伤害模型判断。对自部署小模型、处理固定格式输出的团队,这是一条值得评估的优化路线,但目前还不能把这个降幅当成通用承诺。
为什么输出少一个 token,可能比输入少一个更值钱
作者的应用是葡萄牙语作文自动评分器,基于 Qwen3-4B,接收作文、题目和参考材料,返回包含各项能力评分与评语的 JSON。
模型已经针对任务训练过,词表却仍沿用通用版本,包含 151,669 个条目。它要兼顾多种语言和文本,放到这个单语言、单一输出格式的应用里,会产生两种浪费。
一种是反复拆分。固定 JSON 外壳、能力名称、评价用语,每次都要拆成多个 token,再逐个生成。原文展示的一段重复文本,原来需要 12 个 token,经过 VocabX 处理后只需要 1 个。
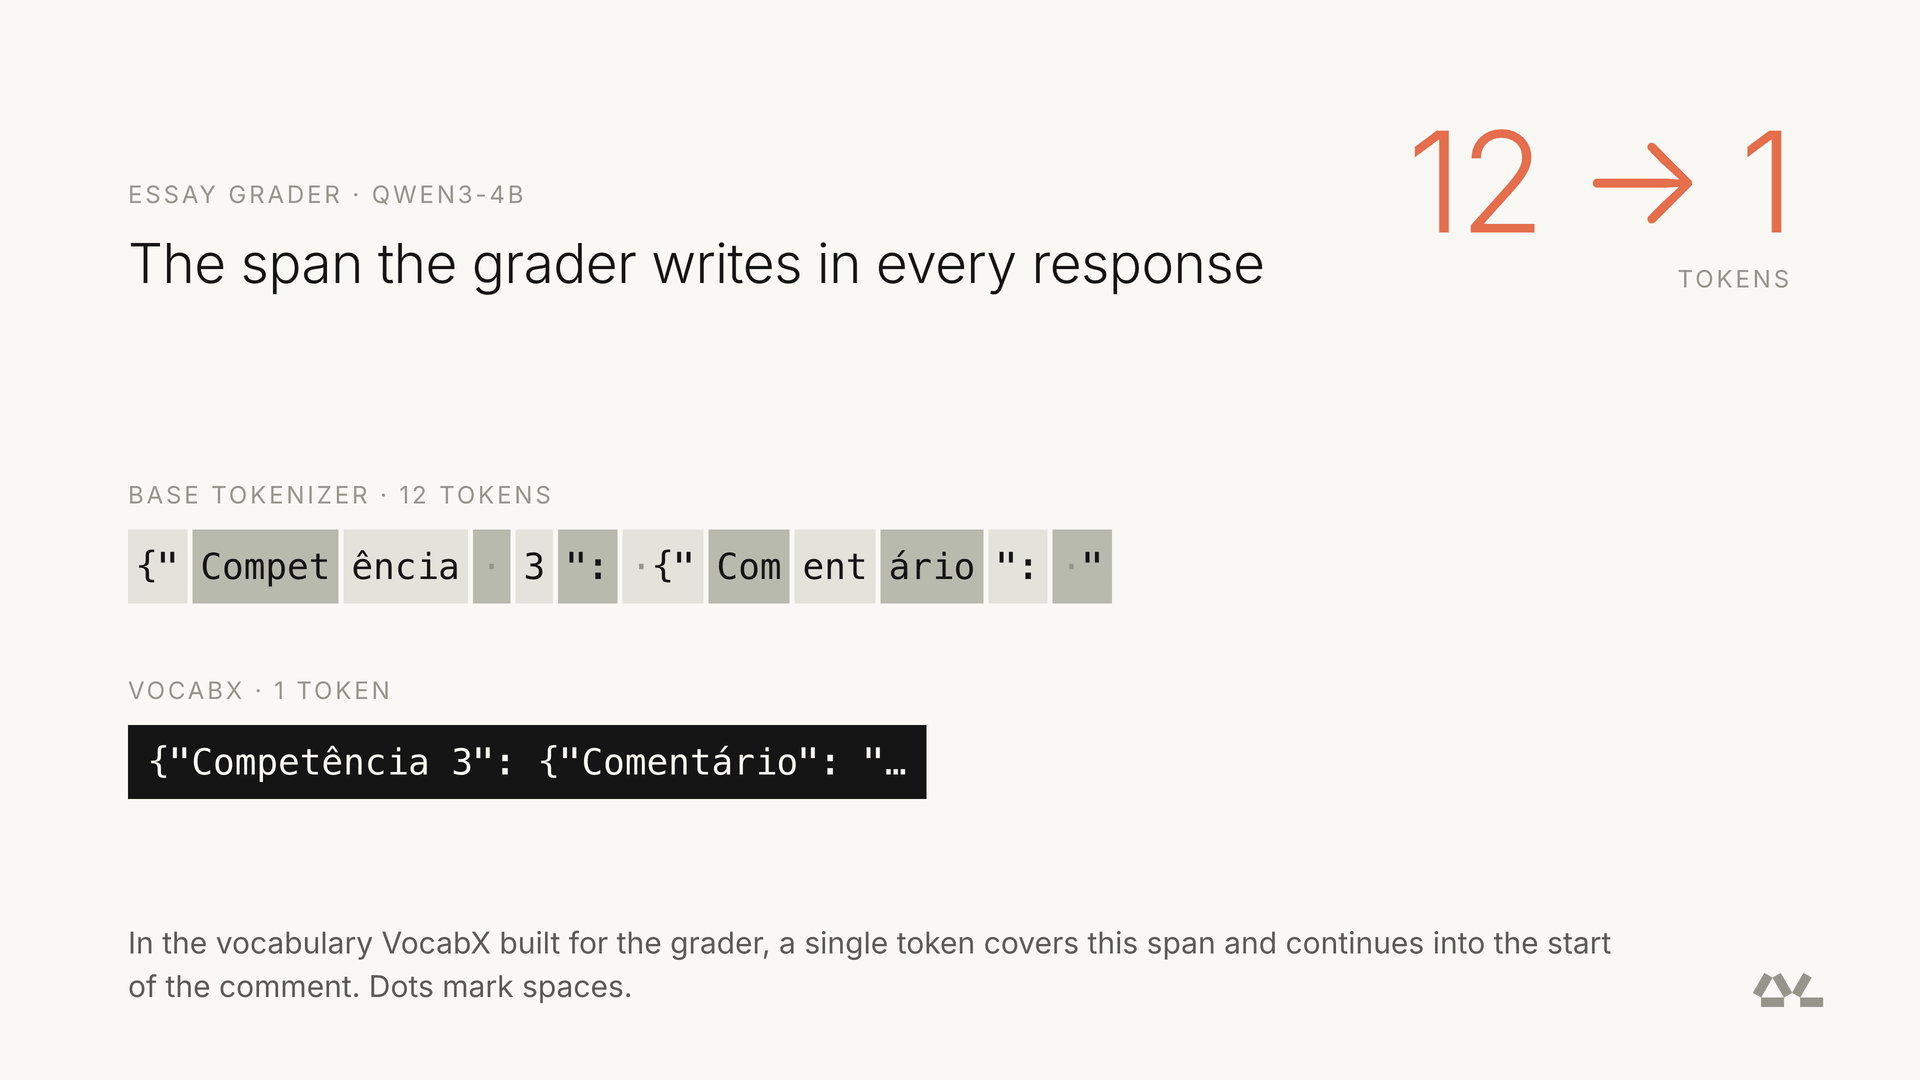
另一种是词表过大。生成每个 token 时,模型的输出层 LM head 都要给词表中的候选项计算分数,几乎不用的条目也参与计算。在 Qwen3-4B 这个规模上,作者称这块矩阵占了接近 10% 的参数。
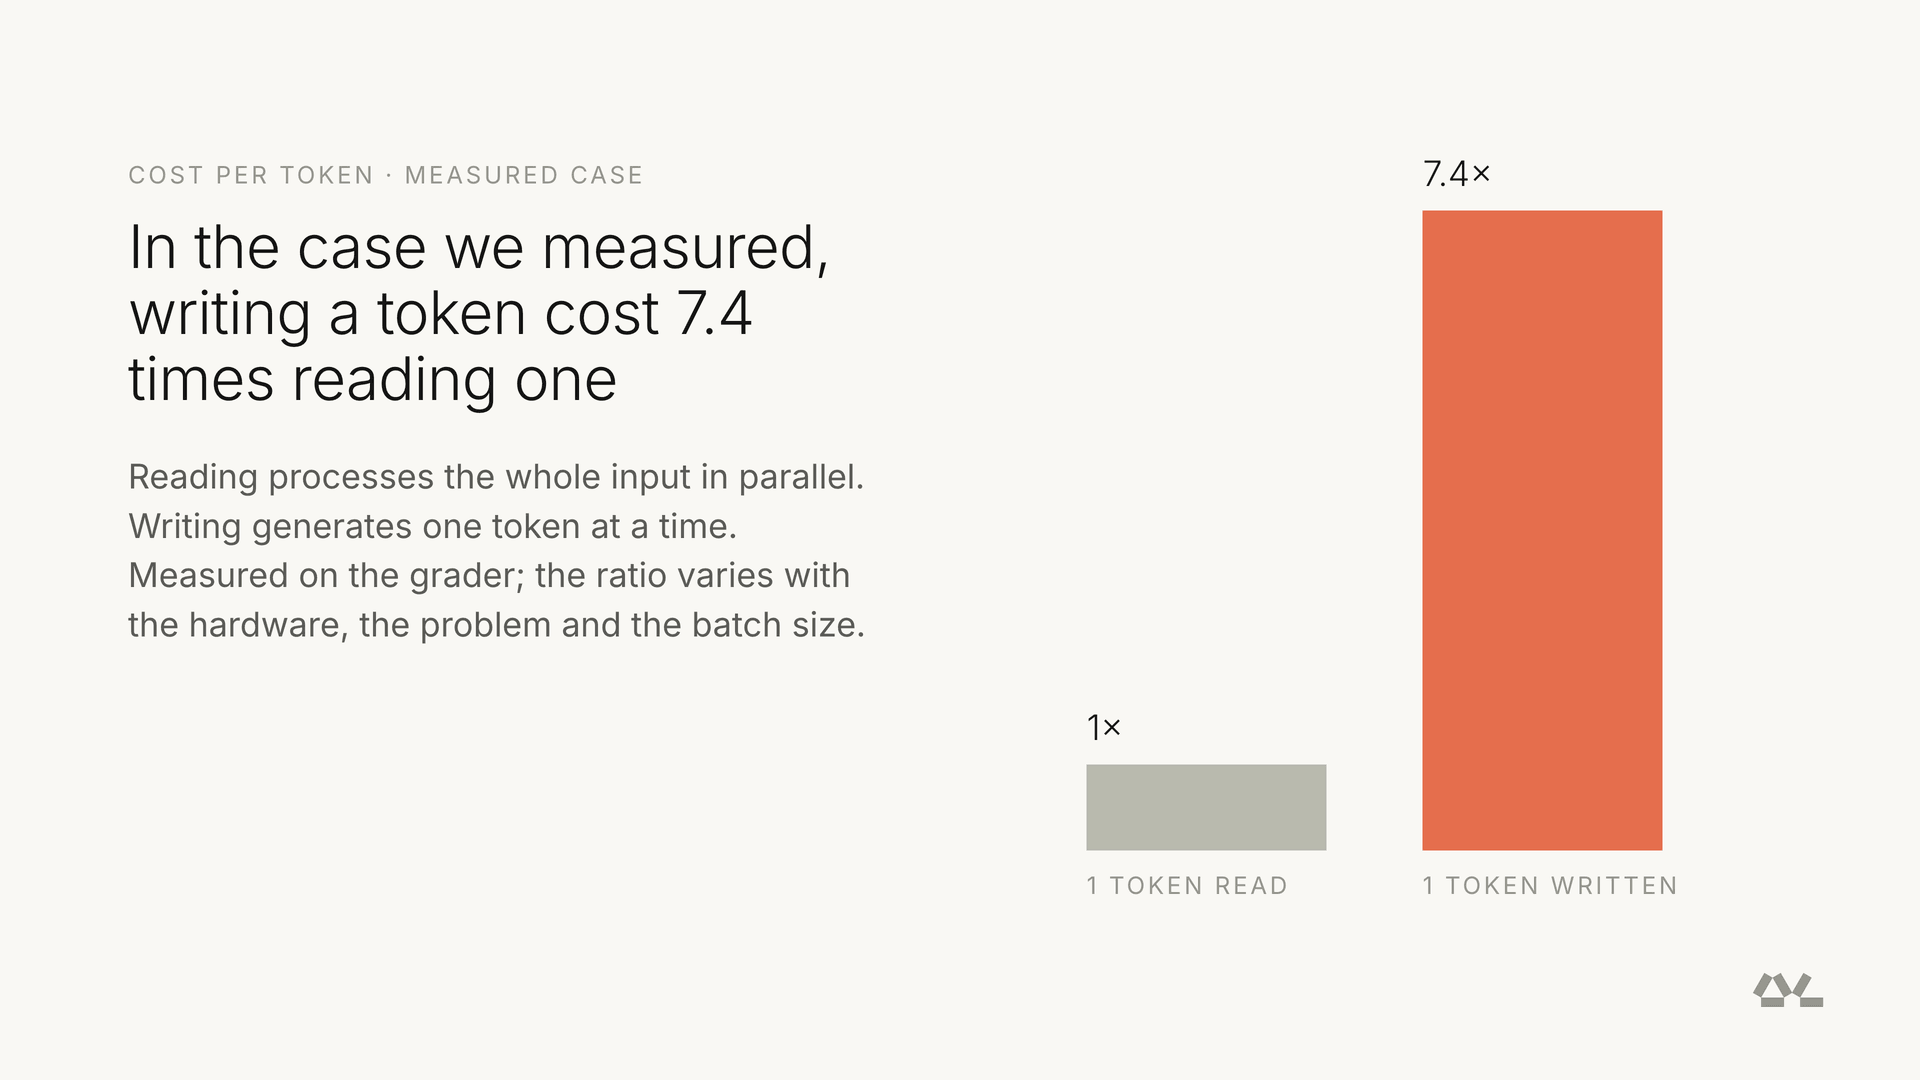
这里还要区分推理的两个阶段。预填充(prefill)处理整段输入,读取一次权重可以用于多个输入 token;解码(decode)则逐个生成输出,每一步都要经过模型,还要读取随上下文增长的 KV cache。
在作者关注的小模型、适中批量请求下,decode 更容易受显存带宽限制。增加 batch 能分摊权重读取成本,但不能消除它。
他们测得,生成一个 token 的成本是读取一个输入 token 的 7.4 倍。这个比例受硬件、批量大小、上下文长度等因素影响,不能直接套到别的服务。
优化目标应该是减少实际推理开销,而不是只追求 token 总数更少。
VocabX 怎样决定哪些文本值得合成一个 token
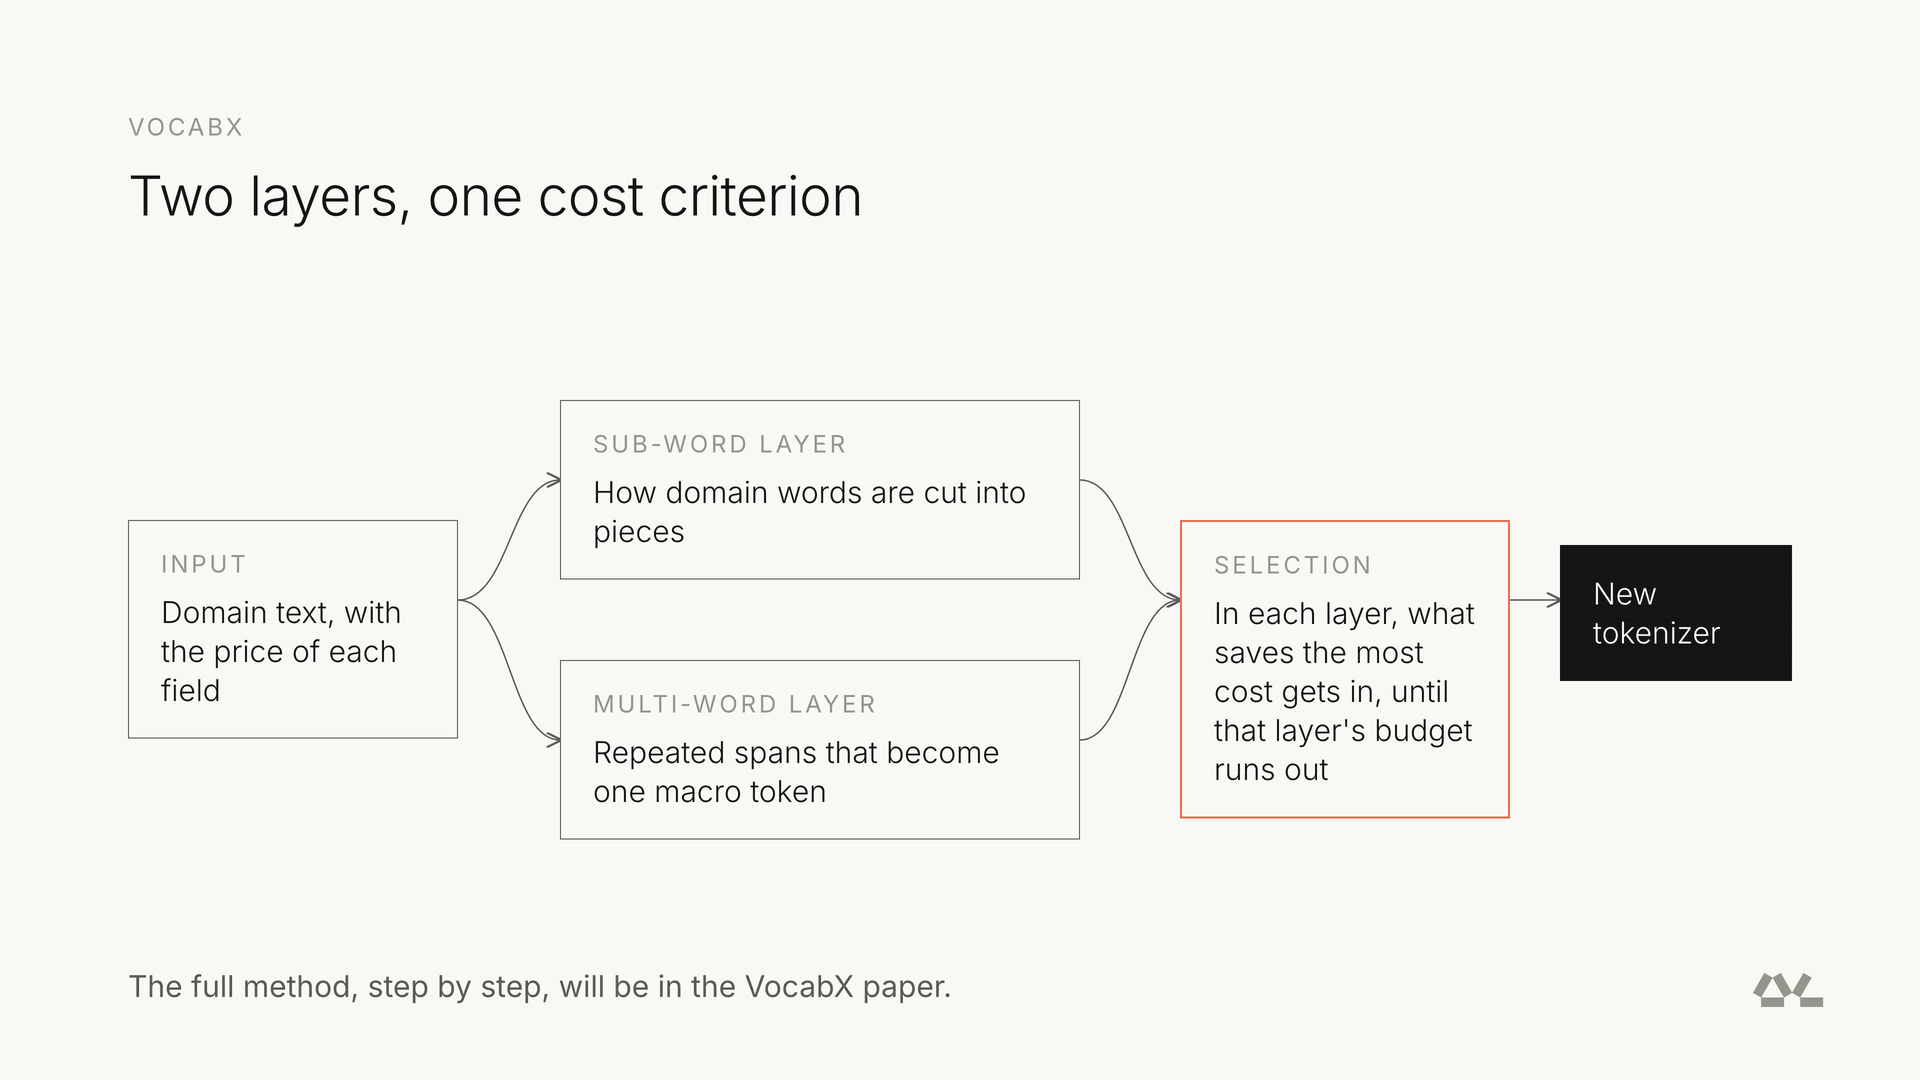
VocabX 的第一步,是按文本所在位置给节省量加权:system prompt、user message、模型回复,节省同样数量的 token,价值可以不同。在这个评分器里,输出侧的权重就是输入侧的 7.4 倍。
这与按出现频率选择词条有区别。一个输入里很常见的表达,未必比一个输出里稍少见的表达更值得压缩。
第二步,是同时处理两个层次。子词层重新组织领域词汇的切分方式;多词层把重复短语、整行文本乃至 JSON 外壳合成一个宏 token(macro token)。可以把它理解为给固定文本片段分配一个编号,生成这个编号就能还原整段文本。
作者用五类挖掘器寻找候选:长词、整行、表达式、完整句子,以及带标点的 JSON、标签等结构。在八个语料库的平均结果中,结构类贡献最大;在代码语料上,它单独贡献了 17.5 个百分点。不使用这五类挖掘器时,评分器的 token 缩减率会下降 55.6 个百分点。
第三步,是修正抽样造成的漏选。选择新 token 时,要判断它还能额外省多少,避免与已选条目的收益重复。每选一次都扫描全部语料太贵,因此需要抽样估计。
问题是,样本里没出现,不代表全量语料里没价值。一个在 50,000 篇文档中出现 37 次的表达,进入 400 篇文档样本的概率只有约 26%。合同语料中,也只有 16.6% 的候选能在这样的样本里出现。
VocabX 把收益拆开:全量出现带来的潜在节省可以精确统计,尚未被已选 token 覆盖的部分才需要估计。对样本没覆盖的候选,使用统计估计,而非直接记零。保持样本和预算不变,这项调整把合同语料的 token 缩减率从 44.7% 提高到 52.8%。
词表规模也要控制。VocabX 的选择标准没有直接纳入 LM head 的矩阵成本,而是通过更小的领域子词表和固定宏 token 预算约束规模。评分器最终从 151,669 个词条缩到 64,767 个,输出层行数也从约 152,000 降到约 65,000。
77%的降幅测过,但最紧凑的版本并不好
作者训练了七个评分器版本,保持基座模型、数据、训练配方和随机种子一致,只改变 tokenizer。所有版本在同一台配备 RTX 5090 的机器上,通过 vLLM 跑同样的 500 个请求,并按实测运行时间计算成本。
最终版本的平均输出从 350 个 token 降到 101 个,成本下降 77.0%。综合评分准确性,以及偏题、违规作文识别准确性的 bench score,从 0.703 升到 0.810。
但最初的版本不是这个结果。
他们曾把每项能力的分数连同周围 JSON 一起合成宏 token。这样最紧凑,却让分数与格式的每种组合都变成独立候选,模型必须一步选定两者。这个版本的 bench score 只有 0.689,低于原生产模型的 0.703。
把分数拆出来单独生成,每次回复多花 2 个 token,bench score 升到 0.810;实测成本降幅也从 73.3% 扩大到 77.0%。原文没有进一步解释,为什么多两个 token 的版本反而更便宜,不能只凭 token 数补出原因。
固定格式可以积极压缩,承载任务判断的内容需要单独验证。
作者还在合同、医学论文、科学论文、新闻、Python 代码五类公开领域,以及 Qwen3、Llama-3.1、Gemma-3 三个模型家族上,对比了 FVT、MWT 和 in-place BPE。
十五种组合中,VocabX 的压缩率均领先最强对照,幅度为 1.2 至 9.3 个百分点。剪枝版在估算推理成本上也全部领先,三个模型家族的平均优势分别为 10.2、7.5、13.6 个百分点。
合同语料的对比尤其直观:剪枝版用 113,426 个词条实现 62.6% 的 token 缩减,最佳 in-place BPE 配置用了 207,803 个词条,缩减率为 61.8%。压得更短,同时还保留更小的输出矩阵,才有机会同时减少两处开销。
我的判断
我认可作者把 tokenizer 纳入专用模型优化范围。固定语言、固定 JSON、固定业务词汇,确实容易让通用词表留下重复开销。评分与格式分离的失败案例也很有价值:压缩对象如果包含模型需要判断的答案,训练任务本身就变了。
不过,77.0% 是一个特定评分器在特定硬件和服务配置上的实测结果。其他十五组对比提供了更广的压缩证据,但其中推理成本是估算值,不能和生产评分器的运行时间实测混为一谈。
文章也没有充分展开测试的 batch、上下文分布、并发与延迟配置,完整方法和表格仍待论文发布,当前数据来自尚在审稿的版本。bench score 上升支持这个评分任务的结果,不能证明通用能力一起提高。
对普通团队,还要算改造成本。作者重新训练了不同 tokenizer 的模型,不能理解成给现有服务换个分词文件就能直接省钱。文章没有给出接入代码,也没有交代训练投入和回本周期。
若重复内容只是固定 JSON 外壳,常见替代方案是让模型输出必要字段,再由程序组装结构。它减少生成内容的方式更直接。VocabX 还覆盖领域词汇和长片段,并缩小词表,适用范围不同;原文没有给出两条路线的对照数据,不能认定它一定更划算。
能拿来做什么
- 如果你在 Node 服务后自部署专用小模型,先分别统计输入、输出 token 数和实际耗时,再检查输出中反复出现的字段名、模板句与领域术语,判断成本集中在哪里。
- 对固定 JSON 输出,先评估能否由程序补齐外壳,让模型只生成需要判断的值。若固定文本仍占据大量输出,再评估词表适配和重新训练的投入。
- 做宏 token 实验时,把分数、分类标签等决策内容与周围格式分开验证,同时观察质量、token 数和实测运行时间,别只按压缩率选版本。
- 如果团队提供的是 Python 代码生成等专用服务,可以把结构片段挖掘纳入实验;日常调用第三方模型 API 的应用,则应先确认是否有修改 tokenizer 和训练模型的控制权。