RAG 上下文预算应从完整请求倒推
RAG 应先为指令、问题、历史、元数据和输出预留容量,再确定检索内容的可用预算,且不必填满。文章建议按实际模型的计数方式测量完整请求,并依据文档结构、相关性、延迟和成本调整分块与检索数量。
AI 深度解读
RAG 的上下文预算,不能只算检索回来的几段文字。系统指令、问题、聊天历史、来源信息和回答空间,都在争夺模型的容量。原文的核心建议是:先算完整请求还能装多少证据,再决定放哪些片段,而且不必把剩余空间填满。
这篇没有给出让效果暴涨的参数,也没有实测对照数据。它更像一份工程检查指南:帮助你排查为什么固定取 top-k 仍然超限,以及为什么省了 token,回答反而变差。
检索预算,要从完整请求里扣出来
RAG,即检索增强生成,是先找资料,再让模型根据资料回答。资料只是请求的一部分。如果直接把模型的上下文容量当作检索容量,实际发送时就可能超限。
作者给出的规划公式是:
retrieval_budget = context_limit
                 - instructions_and_query
                 - conversation_history
                 - formatting_and_metadata
                 - reserved_output
                 - safety_margin
这里解决的是容量预分配问题:从总额度中扣掉指令与问题、历史、格式与元数据、预留输出和安全余量,剩下的才供检索内容使用。要留意 reserved_output 这一行,不能先把输入塞满,再期待模型还有足够空间回答。
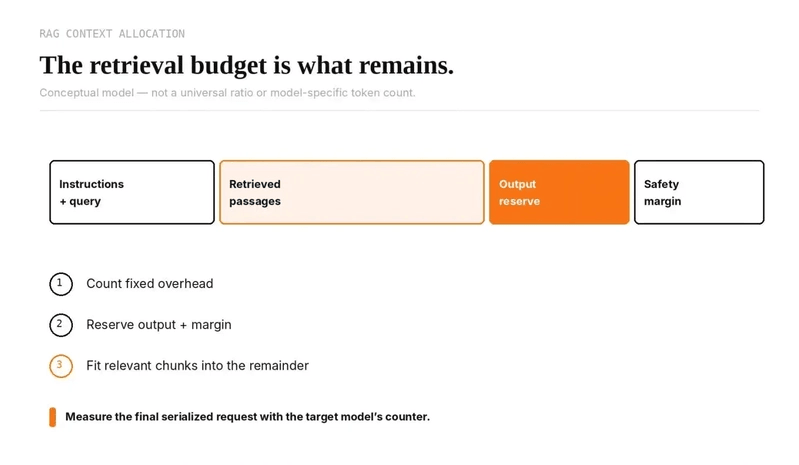
但这个公式只是规划模型。不同模型和 API 对限制的定义不同:有的共享总上下文预算,有的分别规定输入与输出上限。工程实现必须按目标 API 的规则分别校验,不能把这张示意图当成所有模型通用的计费和限额规则。
检索预算是上限,不是每次请求必须完成的填充指标。
更容易漏算的是资料的包装。数据库里的一段文本,进入提示词时可能已经加上标题、URL、文档 ID、排名、访问控制元数据、分隔符和引用格式。单独统计每个 chunk,只适合初步筛选;最终还要统计应用组装后真正发送的完整请求。工具、图片和消息结构若产生额外 token,也应纳入支持这些输入的请求级计数方式。
原文提到 Letinix Token Calculator:它能对 o200k_base、cl100k_base 编码精确计数,对其他所选模型提供基于字符的估算。这个精度不能混为一谈。生产环境应优先采用目标提供商支持的 request-counting API,并与完成请求后报告的实际 usage 对比。
chunk 大小和 top-k,为什么要分开调
chunk 大小决定一个检索单元装多少原文;检索数量决定选多少个单元。两者都会影响 token,但影响回答质量的路径不同。
小块容易定位具体信息,却可能把结论与适用条件切开。大块能保留上下文,也可能夹带无关段落。overlap,也就是相邻块之间的重叠内容,可以保护边界信息,但同时召回相邻块时,又会重复占用预算。
因此,作者没有推荐通用的 chunk 大小或 top-k。政策手册、API 文档、代码仓库和对话知识库,适合的切分边界并不一样。代码里的函数与注释、文档里的参数与例外条件,都需要一起考虑。
作者建议先保留当前配置作为基线,固定检索数量与提示词,再调整 chunk 大小或 overlap;用有代表性的问题评估相关性和回答质量,然后再改变检索数量。每次同时观察 token、延迟、失败方式和答案表现,才有机会判断变化来自哪里。
原文以 Gemini File Search 为例:它提供每块最大 token 数、最大重叠 token 数等切分配置。参数可配置,只能说明系统允许调整,不能证明某个取值适合你的资料。 原文也没有给出这些参数的最优值或对照结果。
固定取 top-k 之后,还需要一道预算检查
top-k 限制的是片段个数,不是最终请求的大小。同样数量的片段,正文长度、引用包装和元数据体积都可能不同。
作者用下面的贪心策略演示如何按预算选择:按照候选排序,尝试加入一个片段,重新组装请求,只有满足容量限制才保留。
// Pseudocode: countWithTargetModel must use the target model's tokenizer.
const selected = [];
let used = countWithTargetModel(renderPrompt({ query, chunks: [] }));

for (const chunk of rankedChunks) {
  const candidate = renderPrompt({ query, chunks: [...selected, chunk] });
  const candidateTokens = countWithTargetModel(candidate);

  if (candidateTokens + reservedOutput + safetyMargin <= contextLimit) {
    selected.push(chunk);
    used = candidateTokens;
  }
}
重点是 candidateTokens + reservedOutput + safetyMargin <= contextLimit:检查对象是组装后的候选请求,还要加上输出预留和安全余量。这段代码是示意,作者明确说它没有经过生产验证;如果 API 分别限制输入与输出,判断逻辑也必须对应修改。
它还有两个局限。第一,每尝试一个候选都重新统计完整提示词,规模上来后可能增加开销。第二,能装进去不代表组合最好:多个高度相似的片段,可能挤掉另一个来源里的关键证据。相关性、多样性、来源覆盖、新旧程度和重复度,都可能影响选择。
如果后续重排或截断片段,还要保留来源边界、引用依据与必要的权限元数据。不能为了卡住 token,把数字的适用范围、规则的例外条件,或者代码块的后半段直接剪掉。
我的判断
我认同它把容量约束与质量目标放在一起讨论。token 更少可以降低部分开销,却不能单独证明 RAG 更好;输入更多,也可能只是增加重复信息和干扰项。真正需要检查的是,决定答案的证据有没有进入候选、有没有被选中,以及模型有没有正确使用它。
但这篇提供的是工程原则与实现建议,没有报告具体语料、模型配置、延迟变化或答案准确率。贪心装配可以作为起点,不能据此认定它优于固定 top-k,也不能推断某种切分策略一定更省钱。
与固定 top-k 相比,预算检查更直接地处理容量问题,但需要可靠计数,也增加了装配逻辑。与简单截断相比,它给保留完整证据留下了空间;至于如何识别最有价值的证据,原文没有提供完整算法,仍要靠自己的检索评估来解决。
原文提到的 LLM API Cost Calculator 适合在拿到代表性的输入、输出用量之后估算支出。它不能替代模型计数,更不能判断检索质量。
能拿来做什么
- 给 Node 中的 RAG 请求增加统一装配与计数步骤,把指令、历史、引用包装和片段一起统计,并分别检查目标 API 的输入、输出限制。
- 调整知识库切分时,先固定提示词和检索数量,只改变 chunk 大小或 overlap,再用同一组代表性问题比较证据覆盖、回答质量、延迟与 token 用量。
- 在检索后增加预算检查,保留来源与必要限定条件;排查回答错误时,同时检查关键证据是否被预算筛选淘汰。
- 更换模型、提示词模板、语料、切分器或元数据格式后,重新运行评估,因为这些变化都可能改变最终请求大小和答案表现。