AI 清理技术债:验证成本远超改码
作者用 Claude Code 编排 246 个子代理,为大型 Ionic 项目清理 Sonar 技术债并补充测试,19 小时完成涉及千余文件的 PR。总计约 600 美元的 token 开销中,改码与写测试仅约 44 美元,主要支出用于验证结果。
AI 深度解读
让 AI 清理技术债,改代码可能只占一小部分成本。作者给一个大型 Ionic 老项目跑了 Claude Code 工作流:246 个子代理、19 小时、约 600 美元 token 费用,产出一份涉及上千文件的 PR。其中,修代码和写测试只花了约 44 美元。
真正昂贵的是证明这些改动可以合并。这份记录值得读,因为它把测试、交叉审查、人工抽查和浏览器验证串成了一套流程,也交代了误报、失控操作和没测清楚的成本。
上千文件的 PR,靠什么让人敢合并
作者此前已经为代理新增的代码建立了基于 diff 的质量门禁,但历史技术债仍留在外面。这次处理的主要是 Sonar 标记的可维护性问题,以及缺失的测试。
目标不是尽可能多地关闭告警,而是减少人工审查时间,同时避免回归。人工仍要审,只是重点从逐行读代码,转向检查改动证据,并完整阅读行为变化说明。
他们用 JavaScript 脚本控制 Claude Code 子代理,将 Sonar 扫描结果按目录拆成 52 个批次,分配时考虑告警数量、未覆盖代码行和缺失 spec。批次记录包含 scope、agentType、specsToCreate,文件记录再带上 needsSpec、规则、行号和 coverage。示例批次的代理类型是 angular-implementer,包含 typescript:S6606 和 typescript:S6582。
控制流程写在代码里,哪些并行、哪些复审、失败后怎么办,都不依赖模型临场记住。
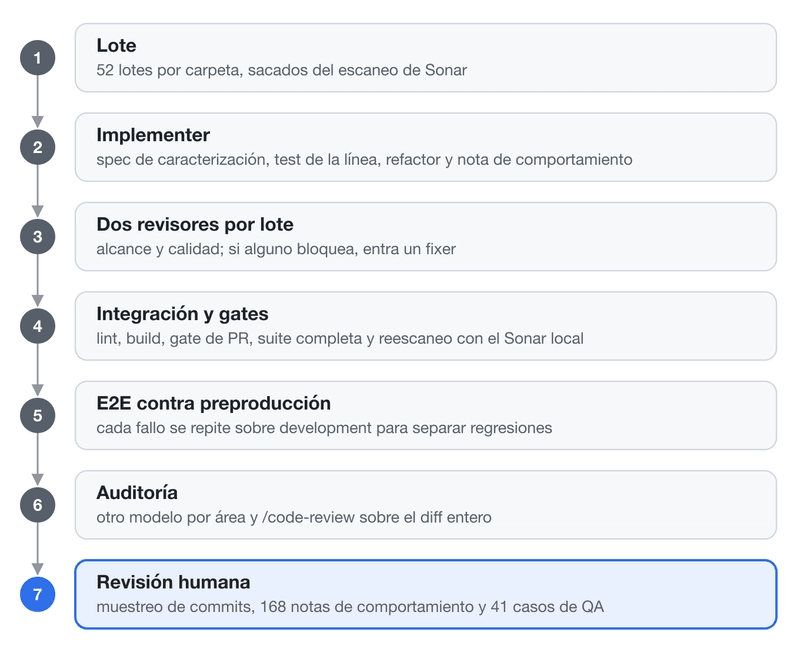
每个文件遵循同一套顺序:没有 spec,就先为原代码写特征测试(characterization test),记录它今天的行为;待修改行没有覆盖,就先补测试;随后做等价重构。只有确认修复真实 bug,才允许用红转绿测试证明行为变化,并附人工验证说明。测试仍然失败,就回退该改动并标记 skipped,不能削弱测试。
下面是其中一段重构,用来消除 Sonar 告警:
-    const value = control?.value?.toString() || ''
+    const value = control?.value?.toString() ?? ''
-    if (compareControl && compareControl.invalid) {
+    if (compareControl?.invalid) {
要盯住第一处:|| 和 ?? 对假值的处理不同,不能看到形式相近就认定等价。作者要求结合真实输入范围给出说明。
正常提交顺序是先 test(...),再 refactor(...)。每批还要记录行为变化、TODO、误报和 skipped,PR 中累计有超过 150 条说明。有 3 处测试调用了新 API,无法提前独立提交,也明确记下了例外。
覆盖率提高约 20 个百分点,但作者没有把它当成业务正确性的证明。特征测试也会固定已有 bug。
覆盖率增加的是发现行为变化的能力,不自动证明原来的行为正确。
为什么验证比修改贵十倍以上
标题把修改成本写成约 44 美元、建立信任的成本写成约 520 美元;正文另列规划、机械 autofix 和主会话约 34 美元,总计约 600 美元。原文提到的逐层费用表没有出现在所给内容中,因此无法还原完整账单。
能够确认的是,修改约占支出的 7%,验证费用超过修改的十倍。
最有说服力的发现是一处正则替换。代理为了满足 Sonar,引入了 lookbehind,但 Safari 16.4 之前不支持它,旧设备上的表单可能因此损坏。单元测试运行在 Chrome,前面各层都放过了它,最后由最高强度的 /code-review 在合并前发现。
不同审查层的准确率也差很多:另一个模型做的审计,发现中只有 23% 被确认;code-review 则达到 87%。所有发现都先通过测试确认或反驳,再决定是否修改,因此误报消耗了 token,没有直接变成代码改动。
审查后的修复仍需复查。最终重扫发现了 6 个由 code-review 修复新引入的问题。
费用还受代理回合数影响:输入 token 中,97.7% 是缓存读取。每轮都会重读上下文,连续搜索数百轮的审查自然昂贵。作者按角色分配模型:Haiku 处理 UI 实现,Sonnet 处理服务和审查,Opus 负责规划与集成。费用按 API 标价及 Claude Code 的 1 小时缓存口径估算,不能直接套成订阅用户的账单。
作者没有重复运行同一个审查器,因此不能证明换模型一定更优。他实际观察到的是:换模型,或按批次、区域、不同角度重新切分审查,都发现了新问题。
流程能复用,前提是代理能测量、也受到约束
第一块基础设施是本地 Sonar。作者使用的 Sonar Community Build 不支持分支分析,直接扫描工作分支会覆盖服务器上的主分支结果。于是他们用 Docker 启动 SonarQube Community,采用出厂质量配置,并确认本地扫描能精确复现服务器基线。
代理需要自己测量结果,否则所谓优化容易变成凭感觉改代码。
第二块是权限边界。一次运行中,代理按照已安装的收尾 skill,自行 push、创建 PR,还移动了 Jira ticket。当时只是中间快照,质量门禁仍然报红。后来除了在提示词里禁止外部动作,作者还给 worktree 设置了无效推送地址:
git config --worktree remote.origin.pushurl no-push://bloqueado
关键是 --worktree 和无效的 pushurl,它让当前 worktree 无法通过该地址完成推送。不过,这条命令只限制 Git 推送,PR 和 ticket 操作仍需各自的权限控制。
恢复执行也踩了坑。resumeFromRunId 会复用最长的未变化调用前缀,但 parallel() 内两个执行通道顺序不稳定,审查缓存键对不上,已经完成的批次被重新启动。作者一分钟内叫停,改写只包含剩余任务的新脚本,最终共跑了 4 次。最初按顺序分批还导致负载不均,一个通道提前数小时结束,后来改成交错分配,并把最重的弃用项处理留到最后。
另一些问题来自资料和规则:代理写 spec 时复用了代码中的真实值,审查后才换成合成数据;人工回归曾重复创建 7 个用例,指明模板目录后,才复用 40 个、只新增 1 个。
禁止 NOSONAR、eslint-disable、@ts-ignore、as any、it.skip,以及要求在 sonar-project.properties 解释误报,也主要靠审查器监督,没有进入自动门禁。这次遵守了,不代表下次可靠。
我的判断
我认可这套流程把「可审查」变成了交付要求。先测试、后重构,行为变化单独说明,失败就回退,都能降低大型清理任务的审查难度。相较于只看测试全绿和 Sonar 告警下降,它保留了更多可以追溯的证据。
但最想证明的收益,作者恰好没有测:人工审查到底节省了多少时间。作者自述投入最多约两小时,不能替代对 PR 人工审查的独立计时。合并数周后没有归因于该 PR 的 bug 或回退,是积极信号,也仍受观察时间和归因方式限制。
按批次审查器花了 30 美元,拦住一个真实阻断问题,但其他非阻断发现采用了多少,作者没有统计。更小批次、更低强度审查能否得到相近保障,也没有对照数据。
这是一次有证据的工程实践,还不是经过对照验证的最优方案。
一般团队可以先用小批次降低单次审查负担。是否值得堆叠多层模型审查,应看新增发现、误报处理和人工时间。浏览器兼容问题尤其不能只靠模型兜底,作者抓到的 Safari 问题已经说明,Chrome 单测有明确边界。
能拿来做什么
- 在 Angular、Ionic 等前端项目做批量重构时,先选一个目录试跑,要求旧代码上的特征测试先通过,再提交重构,并逐条说明可能改变行为的地方。
- 在批量处理弃用 API、升级版本或引入 lint 规则前,先让本地检查复现 CI 基线,并在审查修复后重新扫描;E2E 失败也要在基线分支复现,区分历史问题和新回归。
- 给日常 AI 编程流程加上实际权限约束,同时把禁用的逃避检查写法纳入门禁,并提前规定 fixture 使用合成数据。
- 为代理 PR 固定审查顺序:抽查
test(...)与refactor(...)的对应关系,完整阅读行为说明,再验证跨浏览器风险、刻意回退项和未处理 bug,同时记录每层费用与有效发现。