编程智能体的代码该放在哪种沙箱中
文章比较 Docker Sandbox 的共享挂载、独立 Git 工作树,以及克隆或无挂载模式,说明代码位置如何影响协作、依赖共享和成果回收。它特别指出,单独挂载工作树可能因 Git 元数据位于挂载范围外而限制沙箱内的 Git 操作。
AI 深度解读
给 AI 编程 Agent 配好 Docker Sandbox,接下来还有一个会影响协作的问题:代码到底放哪儿?直接挂载本地项目、每个任务分一个 Git worktree,还是让 Agent 在沙箱里持有独立仓库,看起来只是目录安排,实际决定了谁操作分支、在哪里看改动,以及成果怎么取回来。
Docker 于 2026 年 11 月 2 日发布了 David Karlsson 的工作流介绍。它给出的选择标准很实用:先确定你希望实时参与修改,还是等 Agent 完成后审查分支,再决定代码位置。对前端和全栈团队,依赖安装、热更新与开发服务访问也得一起考虑。
共用本地目录,为什么最顺手也最容易互相影响
Docker Sandbox 是 Agent 运行工具、修改文件的隔离环境,有自己的文件系统和 Git 访问视角。但运行环境隔离,不代表工作文件也各自独立。
在项目目录执行 sbx run claude,该目录会以相同的绝对路径出现在沙箱中。Agent 修改文件,本地编辑器立即看到变化;宿主机启动的开发服务,也能通过热更新接收这些修改。Git 可以从两边操作,提交由谁完成可以自行约定。
这适合围绕一个任务紧密协作:你看着 diff,随时介入,Agent 继续修改,反馈链路很短。
代价是双方踩在同一块地上。你切换分支,Agent 看到的文件也跟着切换;你手动修改文件,这些改动也进入它正在处理的上下文。再开一个无关任务,就需要另一个 checkout,也就是另一份实际工作目录。
前端项目尤其要处理依赖目录。原文以 esbuild 为例:带原生二进制的包,在 Linux 沙箱里安装后,可能无法供 macOS 或 Windows 宿主机使用;回到宿主机重新安装,又可能破坏沙箱里的运行条件。
共享源码,不等于可以跨操作系统共用同一份依赖安装结果。
原文建议保持独立的依赖安装,或者始终在同一个环境运行应用。落到日常操作,就是先确定开发服务、安装命令到底在哪边执行,避免宿主机和沙箱轮流重建同一份依赖。
每个任务一个 worktree,为什么 Agent 反而用不了 Git
Git worktree 能让一个仓库拥有多个工作目录,每个任务使用自己的目录和分支,不必为每个任务重新 clone。将不同 worktree 分别挂进沙箱后,原始 checkout 还能继续处理其他工作。
它解决的是文件互相干扰的问题,但原文指出一个具体限制:只挂载 linked worktree 时,Agent 通常拿不到完整的 Git 元数据。
原因在 .git。linked worktree 里的 .git 是一个指向外部元数据的文件,目标位置在挂载范围之外。Agent 能读写源码,却无法访问 Git 所需的完整信息。按照原文描述,此时查看状态、切换或创建分支、提交,都需要在宿主机完成。
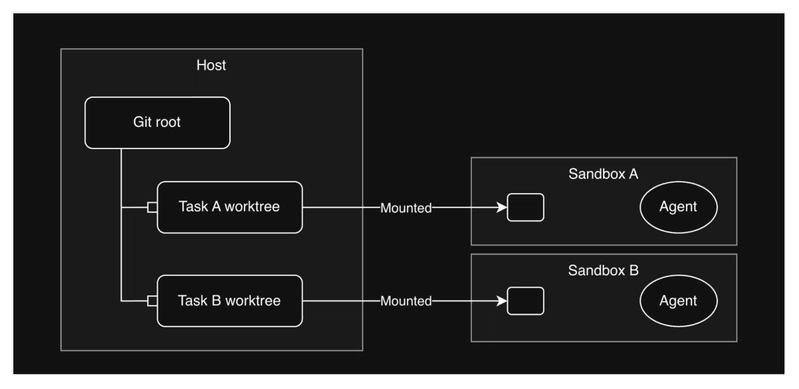
这不是 Git worktree 天生不能让 Agent 使用 Git,而是「只挂载这个目录」产生的可见性限制。判断能否自主完成任务,要看沙箱实际能访问什么,不能只看里面有没有源码。
如果你的习惯是让 Agent 改文件,自己检查并提交,这种安排很合适。如果希望它独立检查状态、提交代码,再交付分支,这个限制就会打断流程。
维护成本也随任务增加:每个 worktree 都要准备运行环境,结束后还要清理目录。任务隔离得更清楚,不代表环境准备工作自动消失。
独立仓库让 Agent 自主管理,交付就变成分支交接
原文把第三类安排理解为「Agent 持有自己的 checkout」,其中有 clone mode 和 mountless 两种形式。
clone mode 仍然利用本地项目:sbx 将宿主机源码以只读方式挂载,同时为 Agent 创建独立 clone。Agent 在自己的目录里切分支、装依赖,不会直接改动你当前打开的工作树。
成果返回也有明确步骤。在沙箱运行期间,可以通过 sbx 在宿主机添加的 Git remote,fetch Agent 已提交的分支;也可以让 Agent 推送到仓库远端,再通过常规流程拉取。
这里要区分「文件改完」和「分支可以取回」。通过 Git 交接的是已提交的内容,不能把沙箱里尚未提交的修改当成已经交付。原文也提醒,忘记 fetch,容易让人误以为完成的工作消失了。
mountless 更接近远程开发机:不挂载任何宿主机目录,仓库在沙箱里 clone,工具和运行环境也留在里面。人通过 sbx exec 进入 shell,或者用编辑器通过 SSH 连接,成果通过推送分支带出来。
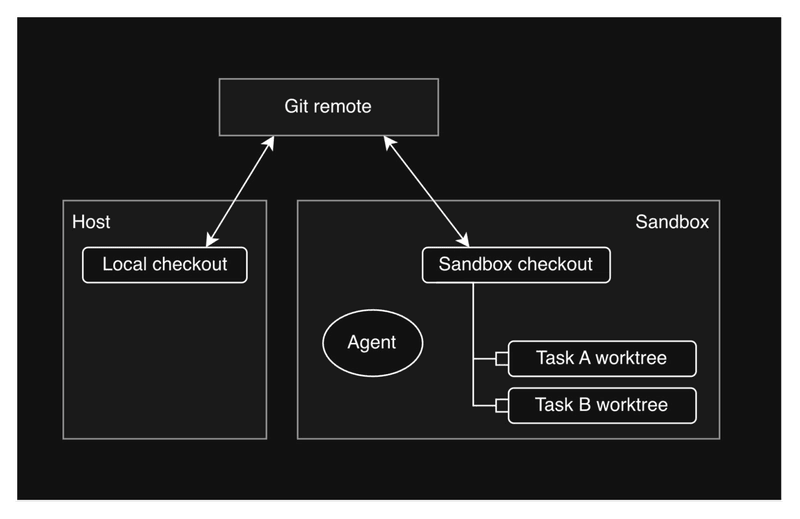
作者介绍的组织方式是一个项目对应一个沙箱,在内部按功能创建 worktree。项目和工具可以跨 Agent 会话、沙箱重启继续保留;环境文件用于重复配置,社区 kit 还可以在创建时完成 clone。不过,输入材料没有提供这些配置的完整示例。
距离增加后,本地预览也多一步。沙箱里的开发服务需要发布端口,例如:
sbx ports my-sandbox --publish 8080:8080
这里要看清 8080:8080:需要建立宿主机与沙箱服务之间的端口映射,浏览器才能访问内部服务。
项目长期留在一个沙箱,也不代表所有任务天然隔离。工具、服务仍可能共享,需要协调;同一个工作目录里即使有多个分支,也不能安全承接同时发生的独立编辑。并行任务仍需要各自的工作目录。
我的判断
这篇最有用的地方,是把选择依据从「哪种隔离听起来更强」转向「人在哪里审查,谁负责 Git」。共享目录让人实时参与,独立 clone 让分支成为交接边界,worktree 则适合拆开任务目录。三者对应不同的协作习惯。
但它是一篇工作流说明。输入材料没有给出可复现的性能测试、并行任务成功率,或者团队采用前后的效率对照。「共享挂载启动最快」「clone mode 适合重审查团队」应当理解为流程判断,不能扩展成效率保证。esbuild 的问题是具体的兼容性风险,原文也没有提供完整的复现记录。
另一个要保留的前提是:文件隔离与环境隔离不是同一件事。不同 worktree 可以隔开源码修改,但开发服务、工具配置仍可能互相影响。团队需要根据任务实际共享的资源安排环境。
原文还提到 jganoff/wsp 这类 workspace manager:它生成带有自身 Git 元数据的标准 clone,因此可以保留 Agent 的 Git 能力。这是 linked worktree 挂载受限时的一种替代思路,但材料没有比较它们的准备成本和维护成本。
最后,持久化不能靠记忆。沙箱重启后文件还在,与删除沙箱后成果仍可恢复,是两回事。只存在沙箱内的文件会随删除一起消失,要保留的工作必须先推送出去。
能拿来做什么
- 与 Agent 共同修改一个前端任务时,可以先采用共享挂载,并明确由谁切分支、谁提交;同时固定依赖安装和开发服务的执行环境,避免两边反复覆盖依赖。
- 同时处理多个任务时,为任务分配独立工作目录。使用 linked worktree 后,先确认 Agent 能否执行 Git 状态检查和提交;若 Git 由人接管,就把这一步明确纳入交接流程。
- 希望 Agent 独立完成修改并交付分支时,可以采用 clone mode 或 mountless,并事先确定通过宿主机 fetch 还是远端 push 取回成果。预览服务先发布端口,删除沙箱前确认需要保留的工作已推送。