文本分类决策能否绕过逐字生成?
文章介绍通过 API 使用4.5B参数的 basal 决策模型,单次前向计算返回文本分类结果及各选项概率。在作者的同卡测试中,邮件路由等任务约耗时20毫秒,27B生成模型约需150毫秒。
AI 深度解读
客服邮件分错组,客户就多等一轮;Agent 每选一次工具都调用大模型,也会不断累积延迟。basal 想解决的是这类高频的小决策:给定文本和有限选项,直接返回选择及概率,不再逐个 token 生成答案。
作者团队的测试显示,4.5B 的 basal 在同卡比较中明显快于 27B 生成模型,但准确率也有损失。值得看的不只是速度,而是它怎样划分模型、业务代码与人工审核的职责,以及这些收益在什么条件下才成立。
只做选择,为什么能省下计算
basal 是 Remigiusz Kinas 开发的波兰语、英语决策模型系列。2.0 模型基于 Bielik v3 继续训练,采用 Apache 2.0 许可证;配套服务软件于 2026 年 11 月 15 日发布到 2.8.1。
作者使用两个型号:4.5B 参数的 basal-2.0-4.5b,以及 1.5B 参数的 basal-2.0-mini。
它接收待判断文本 state 和一组问题,一次前向计算就返回各选项的概率与最终选择。作者托管的 API 支持三类问题:是否、2 到 255 个选项的单选,以及等级评分。同一文本上的多个问题可以合并处理,只读一次文本。
生成模型即使只回答一个 JSON,也需要读取指令,再逐个 token 输出结果。basal 没有这段输出过程,答案也不会跑出预设选项。
如果任务只需要一个选择,生成答案的过程就可能是额外开销。
不过,它不能写摘要,也不给推理解释。文本不足以回答时,它仍会选一个答案,除非显式提供「无法判断」选项。低置信度可以触发复核,但不能替代缺失选项。
下面这段原始调用同时解决邮件分流和客户是否断服两个问题:
import requests

teams = {
    "billing": "Payments, top-ups and invoices",
    "technical": "Technical problems with the API: errors, outages",
    "account": "Account and API keys: sign-in, a leaked key",
    "sales": "Offer, prices, contracts and larger orders",
    "other": "Spam and matters unrelated to the service",
}
email = ("Hi, since this morning every request returns 'budget exceeded' "
         "and our chatbot is offline. We topped up $40 yesterday but the "
         "balance still shows $0.")
reply = requests.post(
    "https://api.blixild.com/v1/systemone",
    headers={"Authorization": "Bearer YOUR_API_KEY"},
    json={
        "model": "basal-2.0-4.5b",
        "state": email,
        "questions": {
            "team": {"type": "choice", "criteria": teams,
                     "instructions": "Which team should handle it?",
                     "option_keys": "hide"},
            "down": {"type": "noul",
                     "instructions": "Is the service down for this customer?"},
        },
    },
).json()
print(reply["answers"])
print(reply["usage"]["input_tokens"])
重点看 "option_keys": "hide":模型看到的是部门职责描述,而不是 billing 等键名。结果中,账务组概率为 0.61,技术组为 0.26;客户断服概率为 0.88。邮件包含技术报错,但余额问题更像分流依据。
该请求读取 367 tokens,输出为零。按作者平台每百万输入 tokens 0.10 美元计算,处理一千封类似邮件约需 3.7 美分。
快了多少,要和准确率一起看
作者准备了 24 个请求、38 个已知答案的决策:14 封客服邮件,每封两个问题,其中 11 封波兰语、3 封英语;另外 10 条波兰语商店消息,用来选择助手下一步,选项包括六个工具、直接回答和追问。
对照模型是 Bielik 11B v3.1、Qwen3.8-27B 和 Arete 27B。它们使用相同的选项描述,通过 JSON 格式限制答案,并关闭 thinking。
硬件并不统一:basal 与 Qwen 使用 H200,Bielik 使用 RTX 5090,Arete 使用 RTX 3090。因此,作者只比较同卡耗时;计算量则按「每个输入或输出 token,约需模型参数量两倍的运算」估算。
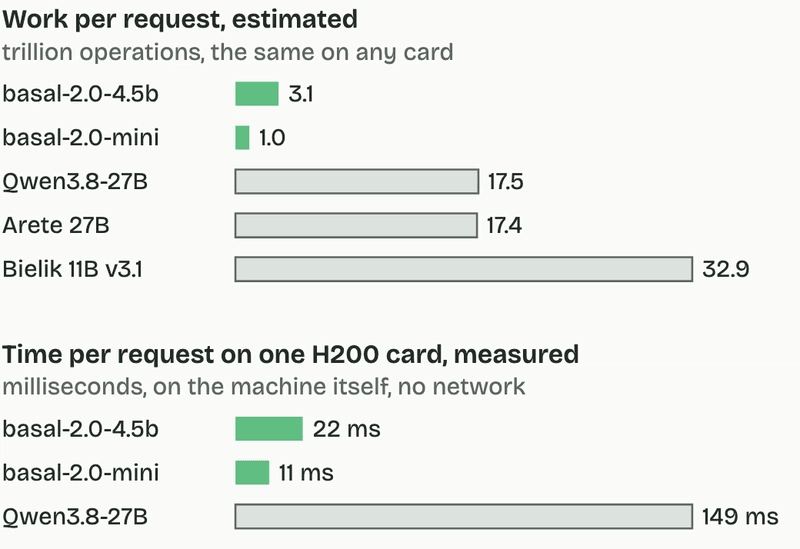
在 H200 上,basal 处理邮件两个问题约需 20 毫秒,选择商店助手下一步约需 10 毫秒;Qwen 分别约需 150、120 毫秒。作者概括为耗时降至约七分之一到十分之一,估算计算量降至六分之一到九分之一。
Qwen 的邮件请求中,约 90 毫秒用于读取,另外 60 毫秒用于生成仅 13 tokens 的答案。短输出也有时间成本。
代价同样明确:两个 27B 模型答对全部 38 个决策,Bielik 答对 36 个,basal 4.5B 答对 35 个,mini 答对 34 个。basal 的三个错误中,两个来自措辞较长的断服问题;此前改用短问题时,它在这 14 封邮件上全部答对。
费用差距没有速度差距那么大。该测试每千次邮件请求的费用,basal 为 3.4 美分,Arete 为 5.1,Qwen 为 8.2,Bielik 为 30。这里的 3.4 美分是测试集口径,与前面单封示例的 3.7 美分不同。
作者也说明,这是自家平台定价。Bielik 的内置指令每次增加约一千 tokens,输入单价又是 basal 的两倍,不能把账单差异全部归因于模型结构。
真正影响落地的是选项、阈值和接入边界
提示设计的影响很大。仅用部门名称、用英语提问时,14 封邮件只分对 6 封;补充职责描述,并改用多数邮件所用的波兰语后,14 封全部正确。不过,这同时改变了描述和语言,不能把全部提升只算到选项描述上。
是否类问题要短,一次只问一个条件;业务规则和事实要放进输入;可能没有答案时,要提供「无法判断」。
日期和金额最好交给代码。作者测试了 12 个波兰语期限、金额规则,4.5B 原样答对 8 个,预先算好日期或总额后答对 9 个。即使提供计算结果,模型判断也没有完全可靠。
置信度则用于决定是否自动放行。设置 "max_error": 0.05 后,低于相应阈值会返回 "abstain": true。前面示例的两个正确答案都触发了弃权,说明默认阈值偏谨慎。对未针对训练的问题类型,4.5B 默认只自动处理约三分之一。
作者建议用自己的标注数据校准;文档称,针对 5% 错误率目标,通常需要几百个标注决策。这个目标仍需在业务数据上验证。
模型和接口也有边界:
- mini 耗时、单价约为 4.5B 的一半,上下文上限分别为 8,192 和 32,768 tokens,超长文本会从中间截断。
- Jev 的 System One 请求可迁移到
/v1/systemone;仅发送文本的 OpenAI Decisions 请求可使用/v1/decisions,调整地址、密钥和模型名。 - 托管接口只支持是否、单选、评分。多标签、文档字段提取、直接根据工具定义选择工具,以及请求级语言设置等能力,需要区分原生服务与网关支持范围。
自建时,作者通过 LiteLLM 统一密钥、预算和限流。决策模型不能走 chat 路由,也不支持流式输出;还要正确标记模型类型,避免健康检查发送 chat 请求。
另一个具体问题是 provider 的默认地址:TypeSafe provider 未设置地址时会回退到第三方服务,Strands Decider provider 则会失败。部署前应核对这一行为。
fast mode 会在启动时编译模型,需要 C 编译器和 Python 开发头文件,耗时数分钟。作者实测提速 1.5 到 2 倍,编译前后概率差异不超过 0.04。
我的判断
我认可把高频分类从生成模型中拆出来。固定选项、合并问题和概率输出,都更容易接入业务程序。但这份测试只能说明方案值得试,不能证明普遍优于生成模型。
样本只有 38 个决策,以波兰语为主,没有中文测试;请求逐个执行,测的是本机时间,没有网络延迟、并发负载或吞吐量数据。国内团队通过远程 API 调用时,端到端收益需要重新测。
概率校准也缺少测试集上的完整结果,不能直接把 0.9 置信度当作本业务必有九成正确率。选项描述、短问题等结论有小样本支持,效果能否稳定复现仍需验证。
相比关键词和确定性规则,basal 适合处理语义模糊的文本;相比生成模型,它适合只需选择的环节。日期、金额、权限等明确规则继续留在代码里,需要解释和内容生成时再使用生成模型,这个分工更有说服力。
能拿来做什么
- 在 Node 客服分流服务中,先整理每个部门的职责与「无法判断」选项,用 20 到 50 条已知答案的真实消息比较两个型号;中文业务必须使用中文样本。
- 给 Agent 单独评估「下一步做什么」,工具参数仍交给代码或生成模型,并分别检查选错工具与参数错误。
- 将期限、余额和退款金额计算留在业务代码中,把计算结果作为事实输入,避免模型承担精确算术。
- 积累几百条标注决策,验证置信度阈值对应的错误率与人工复核比例,同时测量包含网络的完整耗时,再决定是否上线。