Codex 接入 DeepSeek 的四天账单复盘
作者在 VS Code 的 Codex 扩展中接入 DeepSeek,四天产生 962 次请求、约 4.17 亿计费 Token,费用约 5.01 美元。文章明确指出,低账单与高 Token 用量不能证明交付效率或代码质量,需要补充任务成果等指标。
AI 深度解读
4 天、962 次 API 请求、417,153,568 个计费 token,最后只花了 5.014844192 美元。这是作者把 DeepSeek 接入 VS Code 的 Codex 扩展后,从账单里核对出的结果。但这篇最有用的地方,是作者没有把低账单直接解释成高效率。
数据揭示了一个容易被忽略的问题:缓存命中率达到 99.4122%,仍然不能证明上下文用得合理。要判断 AI 编程是否省钱,还得知道花出去的钱,最终换来了多少通过验收的工作。
4.17 亿 token,为什么只花了 5 美元?
作者的开发环境是 VS Code、Codex IDE extension 和 DeepSeek。编辑器、仓库及本地工具运行在工作站上,模型推理由 DeepSeek 远程 API 完成,因此这不是本地部署或离线模型实验。
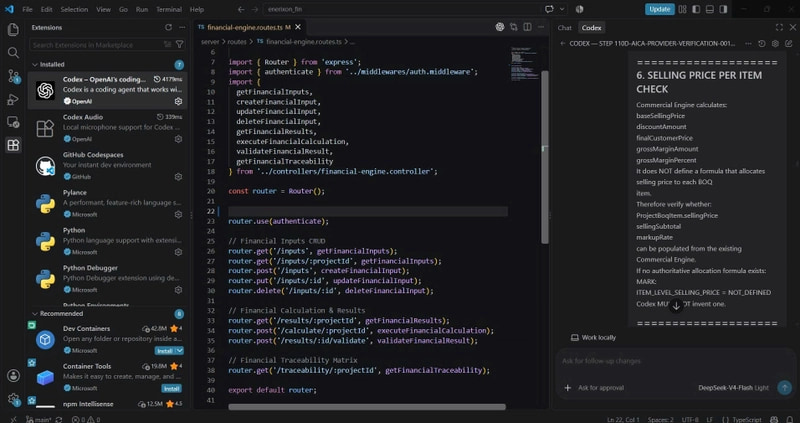
截图里的模型名称是 DeepSeek V4 Flash Light,历史账单里的模型标签是 deepseek-v4-flash。作者没有把两者直接认定为完全相同的请求路由,截图也不能证明全部请求都来自这个界面。原文没有提供可直接复用的接入命令和配置参数。
详细账单覆盖 2026 年 8 月 29 日至 9 月 1 日。仪表盘截图的筛选范围更宽,是 2026 年 8 月 20 日至 9 月 19 日;作者表示,导出的 Amount/Usage CSV 和 Cost/Billing CSV 已核对到相同的总量。
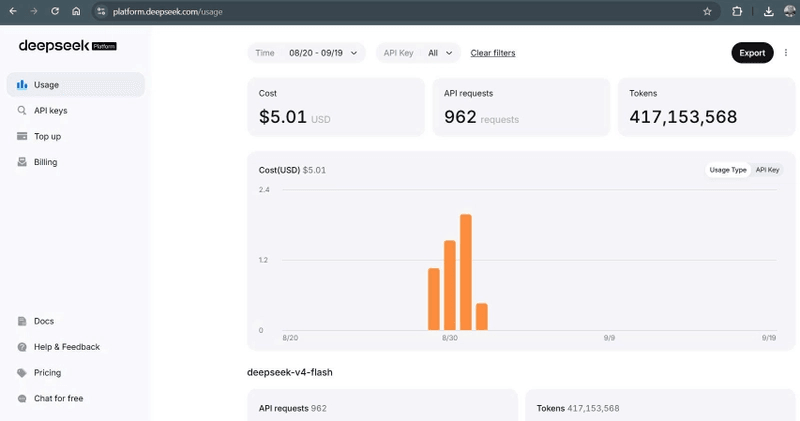
理解低价的关键,是先拆开「计费 token」。原文用下面的计算说明总量如何构成:
413,217,024  Input cache-hit tokens
  2,443,289  Input cache-miss tokens
  1,493,255  Output tokens
------------
417,153,568  Total billed tokens
要看第一行:其中 413,217,024 个是缓存命中的输入 token,并非每次都新增了这么多输入。
总输入为 415,660,313 token,缓存命中率约为 99.4122%。缓存命中输入的费用为 3.371224192 美元,占总 API 费用的 67.22%。另外两项费用分别是 0.566604280 美元、1.077015720 美元,占比 11.30%、21.48%;给定原文没有明确写出这两项对应的类别,不宜自行补全。
面板上的 5.01 美元是四舍五入后的显示值,精确金额是 5.014844192 美元。这笔钱只包含模型提供方的 API 收费,不含开发者工时、IDE 订阅、本地计算资源和其他交付成本。
缓存命中率很高,上下文就合理吗?
缓存降低重复输入的价格,上下文管理决定哪些输入有必要出现。
编码 Agent 可能反复携带系统指令、项目规则、历史对话、文件内容、工具定义、测试输出和诊断信息。重复部分命中缓存,可以便宜一些,但仍然收费。
问题在于,账单只告诉作者多少 token 命中了缓存,没有告诉他缓存里装了什么,也无法判断这些内容是否与当前任务有关。因此,既不能把所有重复上下文视为浪费,也不能因为命中率高就认定它们都有价值。
作者提出的目标是「最小充分上下文」:保留完成任务必需的信息。删掉架构约束、安全要求或验收条件,可能让单次调用更便宜,却增加返工和缺陷。
输入输出比例也值得继续追查。总输入与总输出之比约为 278.36:1;按 962 次请求平均,每次约有 432,079 个输入 token、1,552 个输出 token。
这些是均值,不能直接当作典型请求大小。少数超大请求可能拉高平均值,短输出也可能只是一个工具调用,随后由本地环境完成搜索、改文件或运行命令。
要解释这些数字,还需要逐请求的输入输出量、缓存状态、模型配置、工具调用历史及工具输出大小,并用任务 ID 将它们关联起来。现有汇总账单没有这些信息。
错峰能省钱,但这次只算出了假设结果
历史记录包含 Peak 和 Off-peak 两档价格。Off-peak 占计费 token 的 83.54%,费用为 3.816337904 美元,占总费用的 76.10%;Peak 占 token 的 16.46%,费用为 1.198506288 美元,占总费用的 23.90%。
当期每百万 token 的输入价格如下:
| 输入类别 | Off-peak | Peak |
|---|---|---|
| 缓存命中 | USD 0.007 | USD 0.014 |
| 缓存未命中 | USD 0.22 | USD 0.44 |
Peak 对应单价是 Off-peak 的两倍。作者据此模拟:如果原来的 Peak 工作量能按 Off-peak 计费,费用会从 1.198506288 美元降至 0.599253144 美元,差额也是 0.599253144 美元。
这不是已经实现的节省。它假设任务可以整体迁移时段,且交付时间和工程结果不受影响。文档分析、计划内代码审查、后台测试生成可能适合尝试;生产故障、安全问题和紧急发布则不能只看价格安排。
这些都是历史价格。原文没有给出完整的输出单价,也没有写明具体低峰时段,不能据此直接制定新的调度规则。
真正该比较的是一次验收通过花了多少钱
作者准备引入 Cost per Accepted Task,把计量单位从 token 换成通过验收的任务。原文定义如下:
Cost per Accepted Task =
    Total attributable model API cost
    across all attempts in the experiment
    / Number of tasks accepted against
      predefined criteria
要看分子中的 across all attempts:重试、失败和返工的费用都要计入。分母则只统计满足预先定义验收条件的任务,不能把 Agent 自报完成算作交付。
为此,作者计划先明确任务目标、允许和禁止修改的路径、依赖约束及必需测试,再建立上下文清单:Mandatory 表示任务必需,Conditional 表示触及特定区域才需要,Excluded 表示过时或无关,Authoritative 表示出现冲突时以哪个来源为准。
其他尝试包括缩减过大的工具输出、识别没有推进验收的循环、让最终报告覆盖构建与测试结果,以及按任务要求测试模型选择和调度。作者也强调,额外检查和重复测试可能是必要工作,调用次数少并不自动更好。
这些改动尚未获得对照验证。下一步计划比较四组:
- Experiment A:保留现有流程,收集用量、执行和验收数据。
- Experiment B:增加 Prompt Contract,明确任务范围和验收条件。
- Experiment C:在 B 上加入上下文清单、定向检索并减少重复信息。
- Experiment D:继续加入受支持的稳定前缀组织、结构化输出要求和可延期任务调度。
比较时要固定仓库快照与 commit、任务定义、验收条件、工具权限和执行边界。测试提示或上下文变化时,还应保持模型与配置一致,记录缓存冷启动和热启动条件,并在多个代表性任务上重复实验。
最终应同时报告 token 分类、构建测试结果、每个验收任务的费用,以及分布和中位数。只给平均账单,仍然容易掩盖波动。
我的判断
这篇最可靠的价值,是给出了一份边界清楚的历史计费基线。它证明作者核对到了这些请求、token 和 API 费用,没有证明完成了多少功能、代码是否全部通过测试,也没有证明比其他提供方更经济。
低 API 账单,不能单独证明低交付成本。
相比只看模型单价或缓存命中率,按验收任务计费更接近团队关心的问题。但它也有前提:任务难度需要可比,验收标准不能临时调整,失败费用必须能归属到任务。否则,一个简单文档修改和一次复杂缺陷修复混在一起,平均成本仍然可能误导。
上下文分类、控制工具输出、按任务选模型,都有实践价值;目前仍是待测方案,没有对照数据支持节省比例。作者将相关标准标为 Proposed / Experimental,这个定位合理。团队可以借用测量方法,不能直接照搬「5 美元跑 4.17 亿 token」作为预算承诺。
能拿来做什么
- 给一次前端或 Node 修改预先写好验收条件,例如允许修改的目录、必需通过的构建与测试,并把相关请求费用归到同一个任务,计入失败和返工。
- 为项目整理上下文清单,把全局规则、模块规则、过期资料及冲突时的权威来源分开,让 Agent 按任务读取相关信息。
- 检查搜索结果、日志和测试输出是否过大,只保留诊断所需内容,同时保留必要验证,不以减少工具调用次数作为单独目标。
- 选同一仓库快照上的代表性任务,对比原流程与上下文调整后的流程,记录缓存冷热条件、验收结果、费用中位数和分布,再决定是否推广。