自托管大模型 API 的部署与计费实战
文章拆解从自有 GPU 到对外提供模型 API 的完整链路,涵盖独立密钥、按 token 计费、余额限制及服务隔离。结合实际部署说明显存估算偏差、长提示阻塞、鉴权边界和支付重复通知等工程问题。
AI 深度解读
把开源模型跑在自己的显卡上,离一个能给团队或客户使用的 API,还有鉴权、计量、限额、支付和故障恢复要补。作者用 Blixild AI 的实际部署,把这些环节串成了一条请求链路:公网只接触网关,GPU 留在私有网络里。
这篇最有价值的地方,是几处上线后才容易暴露的问题:显存估算偏乐观、模型服务的 API key 没守住全部接口、长提示词卡在容器网络,以及付款通知重复入账。它提供了一套建设顺序,也留下了需要自己验证的边界。
模型装得下,不代表并发时跑得稳
作者的 GPU 服务器位于波兰:RTX 3090 跑 Arete 27B,RTX 5090 跑 Bielik 11B v3.1,每张卡采用一个 vLLM 进程服务一个模型的部署方式。vLLM 负责并发推理,并提供兼容 OpenAI API 的请求格式。
模型权重首先要放得下。RTX 5090 有 32 GB 显存,Bielik 使用 8-bit 权重;RTX 3090 有 24 GB,Arete 27B 的全精度权重需要超过其两倍的空间,因此采用 4-bit 版本。作者明确承认,尚未测量 Arete 量化后的准确率损失。
剩余显存还要装正在进行的对话,也就是 KV cache。作者用自家的 LLM GPU Token Speed Calculator 预估容量,再与端点实测比较:生成速度落在预测区间内,首个 token 的等待时间比区间上限多 2%,但实际对话容量比最低估算还少约四分之一。
启动日志解释了差距:vLLM 预留的工作显存,约为计算器原先针对纯文本模型假设值的三倍。修正后,同一配置预测可容纳约 96,000 至 105,000 tokens,略低于端点实测的 109,000。
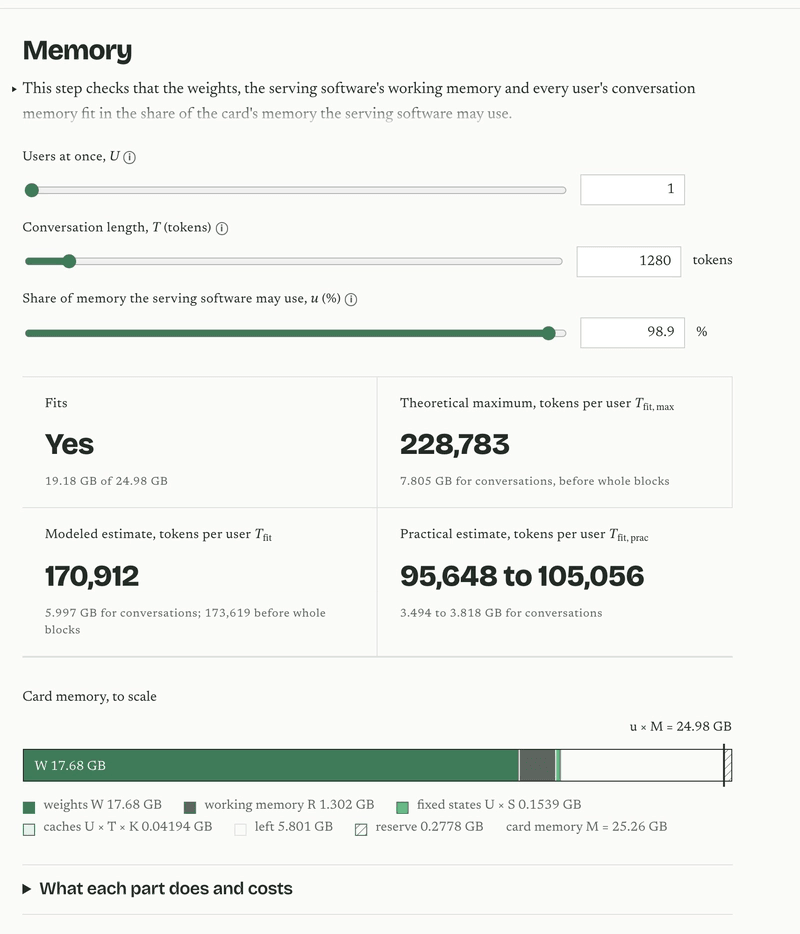
优化也有交换条件。3090 上采用 8-bit 对话缓存并关闭图像输入,容量约翻倍;启用每步起草多个 token 的机制,单请求速度约提高到 1.5 倍,却消耗了 60% 的对话容量。考虑长文档和 agent 的需求,作者选择保留容量。
计算器用来选卡,服务限额要靠满并发、最长提示词的实测来定。
作者还建议固定对话缓存大小,避免 vLLM 每次启动测量工作显存时出现波动。工具调用也必须单独验证:启动时要配置与模型格式匹配的 parser,这两个模型需要不同的解析器。配置缺失时,普通聊天仍能成功,带 tools 的请求却会失败。
为什么鉴权、计费和公网入口要分开
作者的原则是,每项职责尽量用现成工具,自己只写工具之间的连接代码。
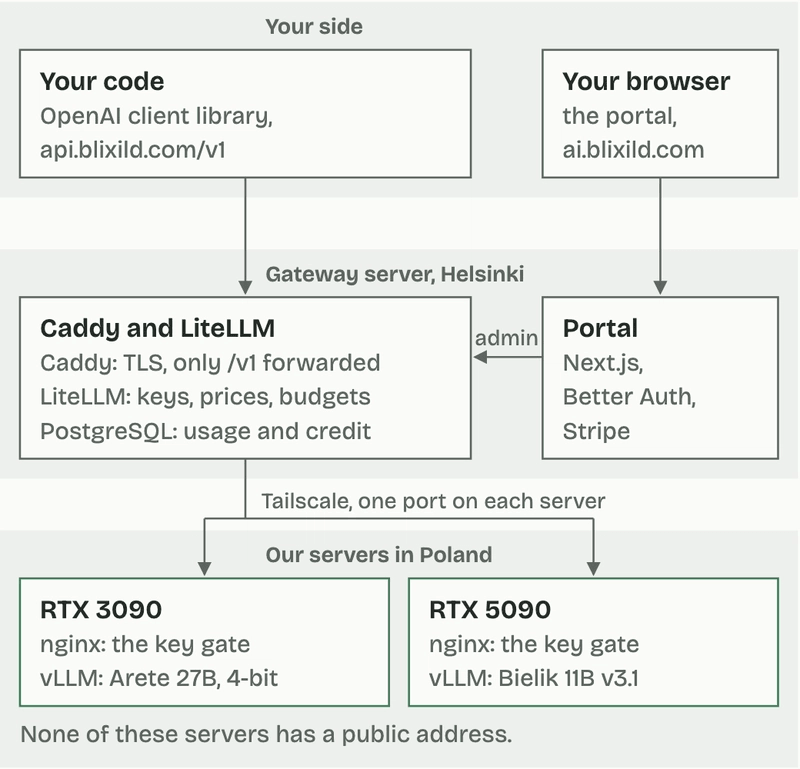
靠近 GPU 的第一道门是 nginx。它只允许携带已知 key 的 /v1 请求通过,拒绝其他路径;vLLM 只监听本机。这样安排的原因是,按原文引用的安全说明,vLLM 自带的 API key 检查没有覆盖同端口上的全部接口,其中还包括能生成文本的接口。
能访问这道门的只有赫尔辛基的网关服务器。两端通过 Tailscale 私有加密网络连接,访问策略只开放指定 GPU 端口,并用策略测试防止权限扩大。原文提醒,所查阅的 Tailscale 免费方案面向非商业用途,商业部署不能直接套用这个前提。
第二层是 LiteLLM,负责把模型访问变成可计量的服务。它按配置将 Arete 请求送往 3090,将 Bielik 请求送往 5090,同时签发客户 key、统计 tokens、扣减预算,并限制每个 key 的并发数。
自定义模型必须配置输入和输出两项费率。漏掉定价,请求就可能不消耗额度。作者为此向每个模型发送真实请求,核对扣费与公布价格是否一致。
公网前面还有 Caddy,负责 TLS 证书,并且只转发 /v1。LiteLLM 管理 key 和预算的 admin API 留在私有侧,仅供门户调用。Caddy、LiteLLM 与 PostgreSQL 部署在网关侧,门户另有服务器。
这里最容易被短请求掩盖的问题是上传链路。作者遇到长提示词停滞,逐跳计时后发现,瓶颈在 rootless Docker 使用的用户态网络 pasta,切换到 slirp4netns 后恢复。这个结果定位的是他们的部署故障,不能据此断言所有环境都该更换网络后端。
从可调用到可收费,难点在状态一致
门户是作者自己写的 Next.js 应用,使用 Better Auth,只支持 Google 或 GitHub 登录,因此不保存密码。首次访问会在 LiteLLM 创建客户和 key,并赠送 $1 额度。
额度记录保存在门户自己的数据库中。每笔赠送或充值形成一条账本记录,再将账本总额同步为 LiteLLM 的预算。这里要区分累计授予的预算与当前剩余额度,不能把一次充值直接覆盖成新的余额。
支付最重要的要求是幂等:同一笔付款无论通知多少次,都只能入账一次。付款结果既可能随用户返回支付页面到达,也会通过 Stripe webhook 到达;webhook 收不到响应还会重试。作者用支付引用标识每笔入账。
原文描述的 Stripe 配置由其充当 merchant of record,即以自己的名义销售额度,并处理相应税费和收据。这有具体产品与配置前提,不能理解为任意 Stripe 收款接入都自动包含这些服务。含税价还是价外加税也要显式指定,测试账户与正式账户的默认设置可能不同。这个门户只卖预付额度,没有订阅,也不自行开具发票。
最后,单个工具测试通过还不够。作者通过公网地址创建临时客户,调用真实模型,验证扣费、余额到 $0 时拒绝请求、删除 key 后失效,以及日志不保存提示词。运行期间,网关还持续向各模型发送短请求,并从网关侧发送故障邮件。
他们也主动停止过推理引擎,发现模型服务可能在引擎死亡后正常退出。只在错误退出时重启的规则会漏掉这种情况,因此改为容器停止就重启。模板项目继承的依赖版本,则需要在上线前检查已知漏洞。
我的判断
我认同这套方案对职责的划分:GPU 服务负责推理,入口负责拦截,网关负责资源分配,门户负责账户与资金状态。出了问题,至少能沿请求路径缩小范围。
不过,这是一份单个团队的部署经验。原文没有给出完整压测方法、持续运行数据、硬件总成本或与托管 API 的成本对照,提供的正文也没有列出完整的预测与实测表格。它足以说明这些故障确实可能发生,还不足以证明这套组合普遍更便宜、更快。
一张卡服务一个模型,是作者的部署选择;1.5 倍加速和 60% 容量损失,也只对应文中的配置。换模型、量化方式或请求分布,都要重新测量。服务链路可用,更不能替代回答质量评测,作者对这一点也做了明确区分。
相比一开始就搭完整商业平台,按使用对象裁剪更实用。个人本机使用只需显卡和推理服务;跨设备访问再加鉴权入口与私网;企业内部增加网关,通常不需要另建支付门户。
能拿来做什么
- 给现有前端或 Node 应用接入自托管模型时,可以利用 OpenAI 兼容接口降低接入改动,但要分别验证流式响应、最长输入和工具调用,不能只凭普通聊天成功就验收。
- 团队共用 GPU 时,可以先按应用或团队分配 LiteLLM key,设置预算与并发限制,再根据实际用量决定是否增加显卡。
- 用 Next.js 建充值门户时,应为支付引用建立唯一性约束,让页面回跳与 webhook 共用同一套入账逻辑,并显式配置税费方式。
- 按原文六步推进:估算并实测显卡、运行模型、保护入口、计量用量、开放服务、验证整条链路。个人和企业可按需停在前面的阶段,但端到端检查与持续探测适用于每种规模。