评估 Copilot 内部工具别只看调用量
Copilot 使用指标 API 开始记录自定义技能、Agent 和 MCP 服务名称,每条记录容量从 5 项增至 25 项。文章强调应结合评测结果判断推广效果,并考虑遥测缺失,权限控制仍需独立落实。
AI 深度解读
GitHub Copilot 的 usage metrics API 开始报告内部 skills、custom agents 和 MCP servers 的名称,单条记录的容量也从 5 项增加到 25 项。团队终于能看见自建工具有没有人用,但作者提醒:调用多,只能证明有人在用,不能证明工具有效。
这篇文章值得读的地方,是把使用统计、任务评估和推广决策接了起来。对正在维护内部 AI 工具的团队,它提供了一套可参考的数据处理方案,也指出了排行榜最容易掩盖的缺口。
从 5 项到 25 项,解决了什么问题
按照原文描述,过去组织部署了多个内部 MCP servers 和 custom agents,统计结果仍可能只显示某种自定义扩展被使用,难以区分具体工具。现在 API 会带上客户配置的名称,团队可以回答更具体的问题:上个迭代上线的只读账单服务,究竟有没有人使用?
容量变化也有实际意义。一个开发者一天接触十几种工具,只有 5 个位置的记录可能容纳不下,后面的工具便从统计中消失。增加到 25 项,能保留更多长尾工具,但仍不代表数据完整。
名称让采用情况可见,次数却不能替工具质量作证。
连接成功不等于任务完成,调用发生也不等于代码最终合入。作者反复强调的,是避免把这几件事混成同一个指标。
这里还有一个信息边界:原文没有列出适用套餐、正式响应结构或具体接口路径。因此,不能把文章里的 TypeScript 类型当成 GitHub 的官方 schema,接入时仍要按实际 API 文档映射。
先把数据存下来,再谈看板
作者建议定时拉取 API,将结果存入自己的表,而不是直接拿 API 响应画图。原因很实际:趋势需要历史数据,后续关联任务结果,也需要稳定的数据结构。
下面是作者提出的标准化示例,每行对应某一天、某个用户使用的某个工具。它是建议实现,并非原文展示的生产实测代码。
// normalize-usage.ts
// Map whatever the usage metrics API returns into one row per named tool, per user, per day.

type RawUsageRecord = {
  day: string; // map from the API's date field
  user: string; // map from the API's user identifier
  entries: Array<{
    kind: "skill" | "agent" | "mcp_server";
    name: string; // the customer configured name, now reported
    interactions: number;
  }>;
};

export type ToolUsageRow = {
  day: string;
  user: string;
  toolKind: "skill" | "agent" | "mcp_server";
  toolName: string;
  interactions: number;
  truncated: boolean; // the record hit the entry limit, so its tail may be missing
};

const ENTRY_LIMIT = 25;

export function normalize(records: RawUsageRecord[]): ToolUsageRow[] {
  return records.flatMap((record) =>
    record.entries.map((entry) => ({
      day: record.day,
      user: record.user,
      toolKind: entry.kind,
      toolName: entry.name.trim().toLowerCase(),
      interactions: entry.interactions,
      truncated: record.entries.length >= ENTRY_LIMIT,
    }))
  );
}
要看的是 truncated: record.entries.length >= ENTRY_LIMIT:达到 25 项就标记「可能缺失」,并不是确认发生了截断。看板应该保留这种不确定性。
名称处理同样需要留神。trim().toLowerCase() 能消除首尾空格和大小写差异,却不能自动识别工具改名,也可能合并原本不同的名称。作者提出统一名称是对的,但这段示例还不能独立解决工具身份的长期追踪问题。
怎样把调用次数接到任务结果上
GitHub 一侧的数据已经聚合,团队自己的评估通常按单次运行记录。两边粒度不同,不能直接逐条拼接。作者选择「工具名称+日期」作为共同关联键,让同一天的采用情况和评估表现出现在同一行。
作者没有推荐按用户排名。他认为,这容易把采用报告变成对个人的监控,进而促使开发者绕开统计。
评估数据需要团队自己补。原文引用 OpenTelemetry semantic conventions 1.44.0,建议用 span,也就是一次操作的追踪记录,分别描述执行行为和评估结果。示例使用 @opentelemetry/api 的 trace.getTracer("agent-evals") 与 startActiveSpan,设置:
gen_ai.operation.name,值为execute_tool。gen_ai.tool.name,记录工具名称。gen_ai.evaluation.name,示例值为task_passed。gen_ai.evaluation.score.value,记录评估分数。
作者也明确提醒,评估属性的确切名称要核对所用 semconv 版本。更关键的是,埋点代码不能替你定义「任务通过」:原文没有展开如何生成可靠的 passed 和 score,也没有给出它们与生产效果的验证数据。
下面的 SQL 解决另一个常见问题:先分别聚合,再关联,避免多条使用记录与多条评估记录互相匹配,把次数放大。
WITH usage AS (
  SELECT day, tool_name,
         SUM(interactions) AS interactions,
         BOOL_OR(truncated) AS any_truncated
  FROM tool_usage
  GROUP BY day, tool_name
),
evals AS (
  SELECT day, tool_name,
         COUNT(*) AS evaluated_runs,
         AVG(CASE WHEN passed THEN 1.0 ELSE 0.0 END) AS pass_rate
  FROM tool_evals
  GROUP BY day, tool_name
)
SELECT u.day, u.tool_name, u.interactions, u.any_truncated,
       e.evaluated_runs, e.pass_rate
FROM usage u
LEFT JOIN evals e USING (day, tool_name)
ORDER BY u.day DESC, u.interactions DESC;
要看的是 LEFT JOIN:有使用、没评估的工具也会留下来。evaluated_runs 为 NULL 是一个待处理的发现,不该被展示成零分,更不该默认为成功。
什么情况下该推广,什么情况下该收缩
作者把决策分成四种情况:使用多且结果好,可以扩大推广;使用多但结果差,先修复或限制;使用少但结果好,可以加强推广;使用少且结果差,可以考虑下线。没有评估结果,则暂缓判断。
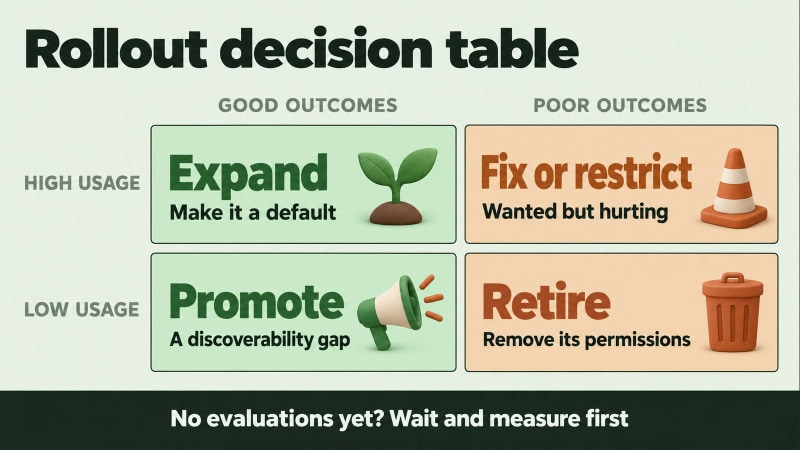
这张表成立的前提,是先承认统计有缺口。有些客户端不报告遥测,有些网络会阻断上报。工具看起来少人使用,可能只是它的使用入口更难被统计到。作者因此建议把次数看成观测下限,优先比较同一工具自身的趋势,避免制作团队排行榜。
权限又是另一回事。原文引用 OWASP LLM06,将过度代理能力的来源分为功能过多、权限过大和自主程度过高。统计系统只能记录行为,无法替代这些边界的执行。一个不需要写权限的 MCP server,即使广受欢迎,也不能靠好看的使用曲线证明权限合理。
我的判断
我赞同作者把采用率和质量拆开,尤其是保留「有人用,但没人评估」这一状态。它比直接展示热门工具排名更能帮助平台团队安排工作。
但这仍是一套经验方案。作者提到生产评估和看板建设经历,却没有提供改造前后的对照数据,也没有证明「工具名称+日期」足以支持准确的推广决策。
按天关联,最多说明当天的使用量与被评估运行的表现同时出现,不能证明每次调用都获得了对应效果。如果只评估了一小部分容易通过的任务,整体通过率仍会误导。这个方案比只数调用次数前进了一步,评估覆盖范围却依然需要交代。
对工具较少的团队,也不必立即搭齐 OpenTelemetry 和数据仓库。先保存每日使用数据、整理一组固定任务的评估结果,同样可以验证决策表是否有用。工具链的完整程度,不能代替评估本身的可信度。
能拿来做什么
- 如果团队已经部署内部 MCP servers,就先定时保存 usage metrics,统一名称,并给达到 25 项的记录标出可能缺失,保留后续追踪趋势的条件。
- 在 Node 编写的 agent 或工具执行层记录运行结果,先明确哪些任务算通过,再接入 OpenTelemetry;同时核对 semantic conventions 1.44.0 对应的属性定义。
- 给采用看板同时展示
interactions、evaluated_runs和pass_rate,将没有评估的工具单独列出,优先补齐它们的质量证据。 - 推广 AI 编程工具时,结合使用趋势和评估表现安排试用范围;MCP 的读写权限与自主执行边界,则通过独立机制约束。