代理命令拦截不能只检查首个单词
文章展示了仅按命令首词拦截的漏洞:包装命令、多行脚本及重定向可隐藏危险操作。hmharness的shellgate扫描完整命令字符串,覆盖管道和串联子命令,但不尝试完整解析Shell语法。
AI 深度解读
给 AI Agent 的命令执行加一道检查,不能只看开头是 npm、rm 还是 curl。作者借 HarmonyOS/OpenHarmony 开发框架 hmharness 中的 shellgate,讨论了一个容易漏掉的问题:危险操作可以藏在重定向、后续子命令和多行粘贴里。
它给出的方案是扫描完整命令字符串,再把无法识别的模式交给人工审批。这套思路值得参考,但原文没有展示检测率或绕过测试,完整扫描也不能直接等同于安全执行。
为什么一个 echo 就能绕过首词检查
只检查第一个词的拦截器,通常会把命令名拿去匹配黑名单。直接输入 rm -rf / 很容易识别,换一种写法就可能漏掉:
echo rm -rf / > s.sh && bash s.sh
这段代码展示了如何先把危险命令写入脚本,再执行脚本。要关注的是 > s.sh && bash s.sh:第一个执行程序虽然是 echo,后面却通过文件写入和 bash 执行串起了另一套行为。
作者将其描述为磁盘擦除。更严谨地说,它尝试执行危险删除,具体结果还受系统保护、权限和运行环境影响,不能把成功擦盘当作必然结果。
同类盲点还有 xargs、nohup 这样的包装命令,以及多行粘贴。只检查第一行,会漏掉后续行;只检查命令头,会漏掉真正承载操作的参数和后续命令。
命令的第一个词,不足以代表整段输入最终会做什么。
shellgate 为什么扫描全文,却不解析完整 shell 语法
shellgate 的选择是把完整命令字符串放进扫描范围,包括多行输入,以及管道、重定向、&& 后面的内容。
这里要区分「扫描范围完整」和「理解执行行为完整」。前者是所有字符都参与检查,后者还要解释变量、展开规则、脚本内容及 shell 语法。原文只主张前者,没有声称完成后者。
作者认为,完整解析 shell 语法会带来难以维护的解析器和大量边界情况,因此采用已知危险模式扫描,并将未知模式交给人工审批。扫描负责快速筛选,审批负责最终决定。不过,原文没说清「未知模式」如何识别,也没有列出危险模式库。
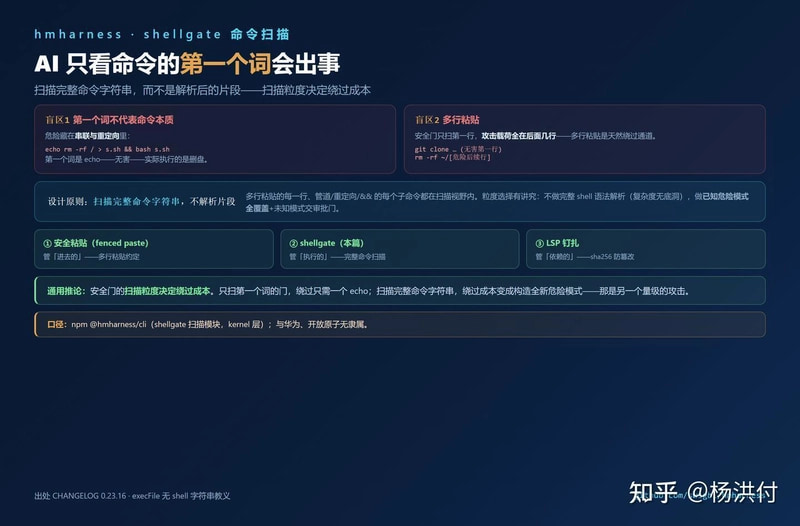
在 hmharness 中,这套检查属于三层防护的一部分:
- fenced paste 约束输入,多行粘贴需要遵循明确约定,但原文没有展开具体格式。
- shellgate 检查即将执行的命令。
- LSP pinning 使用
sha256固定依赖,防止运行过程中被替换。
作者称这些层相互独立,某一层失败不会让整个系统一起失守。这是设计主张,原文没有提供故障注入或攻击测试来验证。
hmharness 是采用 MIT 许可证的社区项目,与 Huawei、OpenAtom 没有隶属关系。它将项目创建、检查、构建、签名、安装、启动、日志读取和结果验证接入本地工具链;shellgate 随 npm 包 @hmharness/cli 提供,原文标注的 CHANGELOG 版本为 0.23.16。
我的判断
我赞同把完整命令作为检查对象。相比首词黑名单,它至少补上了一个明确缺口:危险字符串即使出现在后续子命令里,也有机会被规则发现。
但作者进一步提出,完整扫描会迫使攻击者构造全新的危险模式,从而大幅提高绕过成本。这个结论缺少对照数据,应当视为经验判断。扫描器是否有效,还取决于匹配规则、编码与转义处理,以及被执行脚本是否在检查范围内。全文字符串里没有直接出现危险模式,也不代表执行结果安全。
人工审批同样有前提:审批者需要看到完整输入,并有能力判断后果。提示过于频繁,还可能让确认变成惯性动作。
全文扫描适合补齐检查范围,不能独自承担全部执行安全。
和命令白名单相比,它能覆盖更多灵活写法,但更依赖模式库;和完整语法解析相比,它维护起来可能更简单,却无法据此推断出完整执行语义。原文没有给出这些方案的成本或效果对比,选型时还得看自己的命令范围。
能拿来做什么
- 如果你在给前端或 Node 项目接入 AI 命令执行,先检查执行入口是否拿到了完整字符串,尤其是多行输入、管道、重定向和
&&后面的内容。 - 把原文的写入脚本再执行案例加入拦截规则的回归检查,只验证是否被拦截,不要实际执行危险命令;同时覆盖
xargs、nohup等包装形式。 - 如果采用人工审批,在确认界面展示完整命令和触发原因,并明确哪些输入必须进入审批,避免只显示一个无从判断的命令名。
- 如果 Agent 会下载并运行工具或依赖,可以借鉴
sha256固定内容的做法,同时确认校验值来自可信来源,以及校验发生在执行之前。