模型选型应算任务成本,别只追榜单
文章用一组模型评分与任务成本快照说明,榜单分数接近的模型可能存在数倍成本差异。建议每次更换模型前重跑自身任务评测,核算完成任务的成本,并调整推理强度。
AI 深度解读
模型选型最容易掉进一个坑:把榜单第一名当成自己业务的最优解。作者给出的结论是,前沿模型能力接近,真正拉开差距的却是完成任务的成本、错误方式、稳定性和接入条件。尤其到了会调用工具、修改外部数据的 Agent 场景,回答看起来不错,远远不够。
这篇值得读的地方,是把「选哪个模型」改写成了一套可执行的验收流程。不过,文中的价格和成绩都是截至 2026 年 10 月 15 日的快照,既有独立评测,也有厂商自报和假设算例,不能混成一张采购结论表。
分数接近,为什么账单能差一个数量级
作者所说的前沿模型,是当前处于能力领先位置的通用模型。它描述的是位置,模型不会永久保有这个身份。
原文统计,Artificial Analysis 收录的 2026 年模型已有 123 个,仅 8 月和 9 月就至少有 49 个,还没把不同推理设置拆开计算。但真正处于前沿的只是少数,而且领先者挤得很近:八个模型的 Intelligence Index 成绩集中在 52 到 58 分之间。
把价格放进去,差异就明显了:
| 模型 | 指数成绩 | 每项评测任务成本 |
|---|---|---|
| GPT-6.1 Sol | 52 | $0.72 |
| GPT-6 Astra | 53 | $3.26 |
| Claude Fable 5.1 | 53 | $7.63 |
| Claude Opus 5.5 | 58 | $5.98 |
从 Sol 的 52 分到 Astra、Fable 的 53 分,成本约变成原来的 5 到 11 倍。但这是评测任务的账单,不能直接拿去估算自己的客服或代码助手。
比较条件也不完全一致:Gemini 4 Argon 的 53 分来自 High reasoning,Astra 和 Fable 的 53 分来自 Max reasoning,Claude 模型还包含默认回退配置。它们代表不同运行配置下的结果。
榜单适合筛候选模型,业务验收才能决定上线模型。
编程榜也不能互相替代。FrontierSWE v2 上,Astra、Opus 5.5、Argon 分别为 65.5%、62.3%、55.0%;Terminal-Bench 4.0 上,Sonnet 5.5 为 63.6%,Opus 5.5 为 59.6%。Anthropic 在自己的配置下又报告 Opus 达到 66.4%。任务、工具和配置一变,排序就可能变。
便宜、准确、快,都要等任务完成再算
Token 单价只是费率。实际账单还取决于推理消耗、工具调用和重试。原文引用的评测中,Argon 每项任务约消耗 62,000 个输出 token,Astra 约 27,000 个,两者都包含用户看不到的推理内容。
作者用一个明确标注为虚构的算例解释:
A 每百万 token 收 $5,每项任务用 20,000 token,成本是 $0.10;B 单价只有 $3,却要用 60,000 token,成本反而是 $0.18。若通过率分别为 90% 和 70%,每项通过任务的模型成本约为 $0.11 和 $0.26,还没计入人工修正。
应该追踪的口径是:
每项合格任务成本 =(模型总费用 + 人工修正费用)÷ 合格任务数
人工修正时间要先换算成金额。否则,一个频繁把半成品退回工程师的模型,很容易在报表里显得便宜。
准确率也需要拆开看。AA-Omniscience 中,Argon 的幻觉率为 15%,Astra 为 51%,但准确率分别是 50% 和 63%。该测试的幻觉率定义为:
incorrect / (incorrect + partial answers + not attempted)
它不是所有问题中答错的比例,而是在未完全答对的结果中,错误答案所占的比例。测试不惩罚拒答,且没有工具和额外上下文。因此,低幻觉不能直接解释为检索增强客服一定更可靠。它可能更愿意承认不知道,也可能把更多问题交给人工。
速度同样要计算到完成。原文的假设例子里,一个模型两秒返回,却通常需要两次重试,总共约六秒;另一个五秒一次通过,后者更快完成工作。GPT-6.1 Sol 在 Max 设置下约为 54 token/s,GPT-6 Sol 约为 102 token/s,新版本也未必生成得更快。
Agent 选型,最该验的是失败之后会怎样
聊天回答错了,用户还有机会识别;Agent 选错订单、误判资格,再调用退款工具,错误就进入了业务系统。
作者引用 tau-bench 的原始 2024 年结果:当时表现最好的 GPT-4o,任务完成率仍不足 50%;零售场景中,同一任务连续八次全部成功的比例不足 25%。这不能用于评价今天的模型,价值在于测试方法:检查实际状态是否正确,并重复运行。
单步成功率也会制造错觉。假设十步独立执行,每步成功率为 95%,全部成功约为 60%;每步达到 98%,整体也只有约 82%。这只是算例,真实错误可能相关,恢复机制也会改变结果,但它提醒团队必须设计检查点和修复路径。
能力上限还会影响产品交互。Argon 的一百万 token 窗口由输入、思考和输出共享;通过 Interactions API 输出超过 65,536 token 时,需要后台执行。产品因此需要进度状态、中断入口和费用上限,不能只提供一个持续转动的加载图标。
接入条件也应提前验收。Muse Wonder 有 API,成绩为 56 的 Muse Wonder Full 却仅面向 Muse Code 订阅用户,没有 API。单请求测试通过后,还要验证并发、限流和回退。
原文把这些要求整理成七步循环:
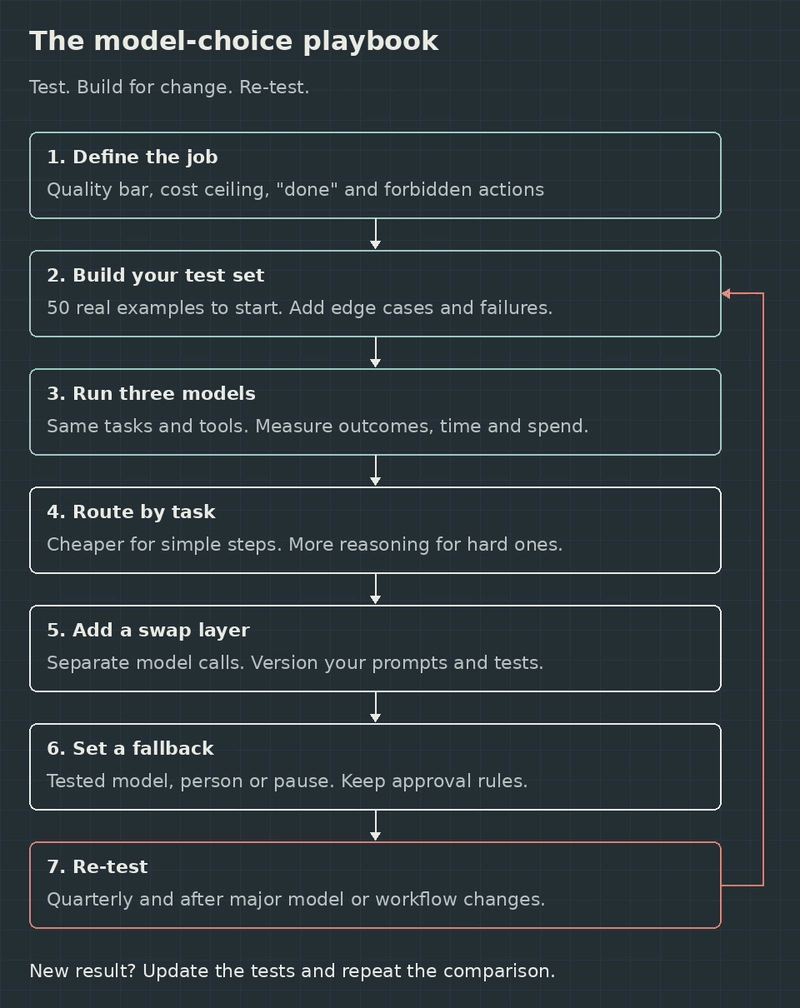
先定义完成标准,再用 50 个真实案例起步,对比三个模型;之后才是任务路由、接入抽象、回退和持续复测。50 个案例只是起点,不能证明罕见风险已经覆盖。
我的判断
我赞同作者把选型单位从「模型」缩小到「完成一项工作」。对于代码修改,生成代码、通过检查、实现需求是不同的验收层次;对于业务 Agent,文字声称成功,也不能替代工具结果和最终状态。
但这篇提供的是选型框架,没有展示某个团队采用整套方法后的对照数据。按任务路由、便宜模型先处理、困难任务升级,都属于值得验证的工程经验。路由自身会出错,多模型还会增加维护工作,不能预先认定一定省钱。任务比较单一时,先用一个模型建立基线通常更容易判断问题出在哪里。
「增加替换层」也有边界。统一调用接口能减少接入改动,却不能消除工具参数、输出格式和安全行为的差异。切换仍然需要回归测试。
价格更要看长期条件。原文称 Argon 的每项任务成本折扣期为 $1.99,标准价为 $3.98,后者高于 Astra 的 $3.26;每百万 token 的输入、输出价在 11 月 30 日前为 $2、$10,12 月 1 日起为 $4、$20。Sol 的输入超过 272,000 token 也会进入更高费率区间。预算只按短输入和优惠期计算,很容易失真。
此外,原文若干评测差异存在重叠的不确定区间,厂商测试与独立测试的配置也不同。它们支持「需要自己测」,不足以支持「某模型全面领先」。
能拿来做什么
- 给日常 AI 编程建立一个真实任务集,从 50 个案例起步,保留需求含糊、资料缺失、工具失败等情况。验收实际修改和检查结果,并记录人工修正分钟数。
- 对比三个候选模型时,保持输入、工具和验收标准一致,记录精确版本、提示词及推理设置,同时测完成时间、总费用和严重错误,重复运行关键案例。
- 在 Node 服务中集中管理模型调用和版本化提示词,为限流、超时准备经过测试的回退路径;涉及发送、删除或购买的操作,回退时也保留审批要求。
- 每季度及模型、提示词、工具发生重大变化后复测。迁移前检查工具参数兼容性、标准价格和回滚路径,再判断收益是否覆盖迁移成本。