Spark 草稿模型发布,投机解码加速本地推理
DSpark 是配合 Spark-X2.6-4B 使用的 6.24 亿参数草稿模型,每轮最多提出七个 token,由目标模型并行验证。发布方报告,在六个数据集上,BF16 推理平均加速分别为 RTX 4090 的 2.14 倍和 M5 Pro 的 2.50 倍,也提供了量化配置结果。
AI 深度解读
Spark-X2.6-4B 新增了一个推理加速搭档 DSpark:先让小模型起草,再让目标模型并行验收。公开模型卡显示,在六个数据集上,BF16 平均推理吞吐达到基线的 2.14 倍和 2.50 倍,分别对应 RTX 4090 与 M5 Pro 的测试环境。
对尝试本地模型的程序员来说,值得关注的是它如何减少逐个生成 token 的等待,以及这些漂亮数字需要哪些条件。原文转述的是模型卡结果,没有提供新的独立实测。
小模型为什么能让目标模型跑得更快
常规自回归生成需要逐步解码,后一个 token 要等前面的结果。DSpark 使用推测解码(speculative decoding):由一个更小的模型先提出候选,再交给目标模型验证。
这个草稿模型有 624M 参数,采用 BF16 精度,每轮最多起草七个 token。Spark-X2.6-4B 随后并行验证候选,从而减少目标模型必须串行执行的解码步骤。加速来自一次处理更多候选,而不是直接跳过目标模型的检查。
DSpark 是 Spark-X2.6-4B 的加速搭档,不能作为独立聊天模型使用。
本次发布提供 BF16 GGUF 格式的草稿权重,搭配 Spark-X2.6-4B-GGUF 使用。目标模型既可以采用 BF16,也可以采用量化 GGUF 权重。这里要分清:允许量化的是目标模型,原文发布的草稿模型仍是 BF16。
平均超过两倍,不能理解成所有任务都翻倍
公开结果覆盖六个数据集:AIME25、GSM8K、MATH500、HumanEval、MBPP 和 Arena-Hard-v2。其中既有数学任务,也有代码任务,但不能据此推断日常代码库修改也会得到相同收益。
在 BF16 配置下,六个数据集的平均推理吞吐提升分别为:
- NVIDIA RTX 4090 配合 llama.cpp,达到基线的 2.14 倍。
- Apple M5 Pro 配合 MLX,达到基线的 2.50 倍。
另外两个峰值很容易被混在一起:最高加速比是 M5 Pro 上以 BF16 跑 MATH500 时的 2.94 倍;最高吞吐则是 RTX 4090 上以 Q4_K_M 跑 GSM8K 时的 532 tok/s。
2.94 倍和 532 tok/s 来自不同测试配置,不能拼成同一套性能承诺。
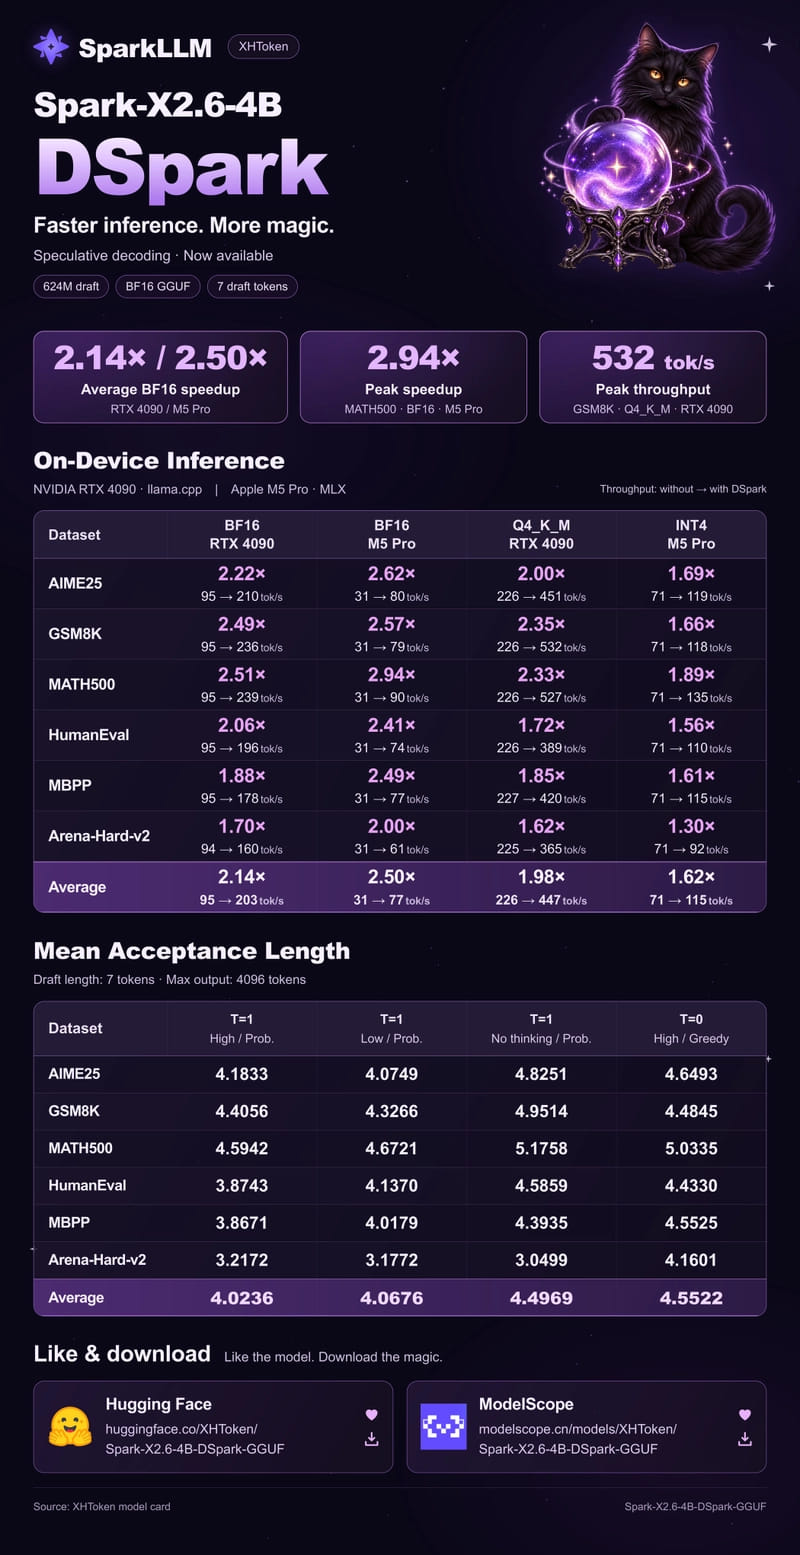
原文还给出了验收长度评估:每轮起草七个 token,最大输出长度为 4,096 token;四种已报告配置的平均验收长度在 4.0236 到 4.5522 之间。
这个指标包含额外生成的一个目标模型 token,所以理论最大值是八,不能把平均验收长度直接当成七个草稿 token 的接受数量。它有助于理解加速机制,但不能直接换算成吞吐倍数,草稿生成和目标验证也都需要计算。
接入之前,先确认运行时支持到哪一步
原文要求按照模型卡配置 XHToken/llama.cpp,文档命令面向 Linux、Bash 和 NVIDIA GPU。上游 llama.cpp 的集成仍在推进,因此不能默认安装任意版本的 llama.cpp 就能直接使用。
MLX 的测试结果是单独报告的。原文没有展开 Apple 平台的接入步骤,也没有给出完整命令、依赖版本或具体启动参数,这部分需要以模型卡为准。
权重在 Hugging Face 和 ModelScope 上以 Spark-X2.6-4B-DSpark-GGUF 发布;Spark-X2.6 系列采用 Apache 2.0 许可证。能下载权重、许可允许使用,与现有推理环境能直接接入,是不同层面的事情。
我的判断
这个方案值得关注,因为它针对的是逐步解码的串行等待,而且允许目标模型使用量化权重。对于已经运行 Spark-X2.6-4B 的团队,它提供了一条继续提速的路径。
但目前能支持的结论是「指定配置下的公开基准有明显收益」。原文没有交代平均值的计算方式,也没给出显存增量、首 token 延迟、并发吞吐等信息。不能拿生成吞吐的提升,直接推导出整个 AI 编程流程也快两倍。
与只运行目标模型相比,DSpark 多了一套草稿权重和适配要求。与单纯调整量化精度相比,它增加了另一种优化手段;不过原文没有给出两者在相同资源预算下的完整对照,暂时无法判断哪种更划算。
能拿来做什么
- 如果你已经用 Spark-X2.6-4B 做本地代码生成,可以固定硬件、目标精度和输入,对比启用 DSpark 前后的生成速度与总耗时。
- 测试时加入自己的补全、函数生成和代码解释任务。HumanEval、MBPP 的结果可以作为参考,不能替代真实工作负载。
- 如果准备把模型接入 Node 服务,先按模型卡跑通对应运行时,再评估服务请求的延迟;原文没有提供 Node SDK 或直接接入方法。
- 分享结果时同时写明设备、运行时、目标精度和任务类型,避免把不同配置的峰值放在一起比较。