用Skills与MCP拆解科学编程Agent
作者围绕Antigravity科学插件,介绍用渐进加载的Skills、常驻规则、生命周期钩子和独立MCP进程组织复杂科学工具。配套开源示例涵盖3D分子可视化及蛋白结构生成,旨在减少上下文膨胀和参数幻觉。
AI 深度解读
把 41 个科学技能接进 AI 编程助手,难点不只是让模型会调 API。规则、密钥、计算脚本和可交互界面都挤进提示词,参数容易编错,上下文也会迅速膨胀。作者拆解 Google Antigravity Science Plugin v1.3.1,给出的答案是:把这些职责拆开,让模型按需读取流程,让脚本承担计算,让独立界面承接操作。
对前端和全栈开发者,这篇最有参考价值的是插件如何组织,而非生物学案例本身。不过,作者展示了实现和演示,没有给出足够的性能对照,部分效果还得打个问号。
41 个技能为什么不用全部塞进上下文
Science Plugin 安装在 ~/.gemini/config/plugins/science/。它把定制能力分成几类:plugin.json 描述插件,rules/AGENTS.md 放常驻规则,skills/*/SKILL.md 放按需流程,hooks.json 对应 PreToolUse、PostToolUse 生命周期事件,mcp_config.json 注册工具服务,sidecar.json 声明附属界面。
关键区别是加载时机。
规则直接进入系统提示词;技能最初只暴露名称和描述,任务匹配后,Agent 才通过 read_file(SKILL.md) 读取完整步骤。这就是渐进式披露(Progressive Disclosure):先让模型知道有哪些工具箱,需要时再打开其中一个。
按需加载的是技能正文,常驻规则和 MCP 工具描述仍然要付出上下文成本。
原文架构图明确写着 MCP 工具 schema 提前加载,因此不能把它理解为「装多少插件都不占上下文」。规则还有每文件 24KB、总计 20K token 的上限。作者提到插件包含 41 个技能和一个提供 9 个工具的 3D MCP 服务,却没有提供安装前后的 token 消耗或响应耗时对照。
插件发现也有优先级:工作区 .agents/ 向仓库根目录查找,其次是工作区声明的 skills.json / plugins.json,再到全局配置、内置插件、全局声明 JSON。项目约定能够覆盖通用配置,但规则冲突也需要管理。
这里还有个容易漏掉的细节:作者将 README.md 标为面向用户、Agent 不读取的文档。安装说明写得完整,不代表 Agent 执行时就能看到;影响操作的约束需要放进实际加载的规则或技能文件。
让模型选流程,让脚本处理计算和输出
作者最值得借鉴的做法,是把容易出错的细节从自然语言要求变成程序行为。
例如,AlphaFold 获取脚本通过 polite-http 设置 qps=1.0。对超过 2,700 个氨基酸的大型蛋白,作者称脚本会回退到最长异构体。PAE,即预测对齐误差,用来辅助判断蛋白不同区域的相对位置是否可靠,也由脚本分析。
analyze_pae.py 用最近 20 个残基组成滑动窗口,计算双向平均 PAE;默认 distance_cutoff=7.0 Å、min_domain_size=40,正文还提到 merge_cutoff=15.0 Å。不过,展示的函数只有初步分段,没有展示合并步骤。这能限制模型随口猜边界,却仍是一套启发式方法,不能直接当成经过验证的结构域结论。
这些脚本使用 uv run 和 PEP 723 内联元数据声明环境,示例要求 Python >=3.10,依赖列表为 []。收益是把脚本运行需求从用户项目的依赖管理中分离出来,减少往仓库环境直接执行全局 pip install 的干扰。
输出体积也被写成了具体约束。AlphaGenome 查询带上 --include_track_info --format json,每个变异约产生 3.9 KB;查询超过 3 个变异时,技能要求通过 -o query_results.json 写文件。共享 artifact 目录则让后续技能继续读取结果,避免所有中间数据都经过聊天窗口。
密钥处理采用同样思路。下面这条原文命令只检查配置项是否存在,不把值打印出来:
grep -sq "^ALPHAGENOME_API_KEY=" ~/.env
要看的是 -sq:Agent 读取退出码,而不是密钥内容。但这条命令只证明文件里有匹配行,无法确认值非空、凭据有效或服务可用。原文后续要求用户在本地通过 read -s 隐藏输入,再由脚本内部通过 dotenv 加载。它减少了聊天记录、命令参数和标准输出泄露密钥的机会,「Zero-Leak」仍不能仅凭这一条检查成立。
3D 界面怎样成为 Agent 工作流的一部分
作者展示的 Sidecar,可以理解为与 Agent 配套运行的独立应用面板。模型通过 MCP 修改状态,用户通过 WebGL 界面观察和操作,同一份状态再回到后续对话。
实现分成两个进程:dist/mcp_entry.cjs 提供 MCP 接口,由 agy-node 启动;dist/server.cjs 负责本地状态及 WebSocket/HTTP 服务,由 node 启动。界面使用 PDBe Mol* v3.12.0 和 Lit v3.1.2。作者列出的构建体积分别为:前端 main.js 183 KB、服务端 68 KB、MCP 入口 30 KB。
下面的配置负责把工具入口接进 Agent:
  {
    "mcpServers": {
      "biomolecular_structure_viewer_mcp": {
        "command": "agy-node",
        "args": ["sidecars/biomolecular_structure_viewer/dist/mcp_entry.cjs"]
      }
    }
  }
要注意 args 指向 mcp_entry.cjs。界面服务另由 sidecar.json 声明,其中包含 has_web_ui: true、restart_policy: "always",以及入口 SIDECAR_UI_ENTRYPOINT_AUX_PANE 和路径 /ui.html。工具进程与界面进程各有职责。
以 TP53 为例,Agent 先获取 AF-P04637-F1-model_v6.cif 和 PAE JSON,再调用 load_structure,通过 highlight_region 标记 A 链第 245 至 250 位残基。用户在界面旋转模型、添加注释后,Agent 调用 get_state(),读回 activeSelection 和用户注释。
常驻规则还要求每次加载或更新可视化,都返回指定的 sidecar:// 入口。这个约束很实际:后台更新成功,却没让用户打开界面,任务仍然没有交付完整。
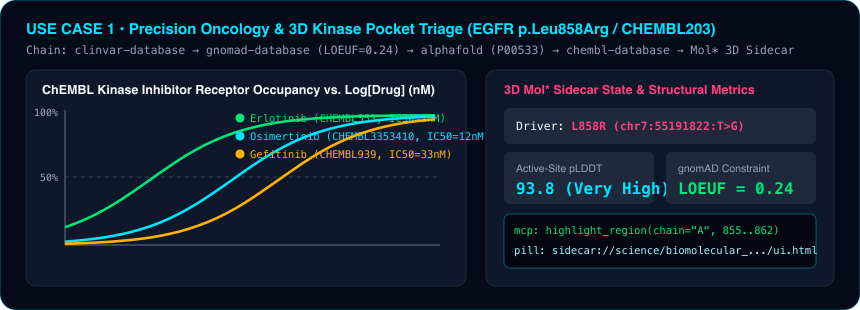
作者的 EGFR 案例串联 ClinVar、gnomAD、AlphaFold、ChEMBL 和 3D 查看器,目标变异是 L858R,标识为 rs121434568、chr7:55191822:T>G,并展示结合口袋:
另一个案例围绕 SORT1 位点 rs12740374、chr1:109274968:G>T,组合 AlphaGenome、UCSC 保守性数据、ENCODE、JASPAR 和 GTEx,分析调控机制:
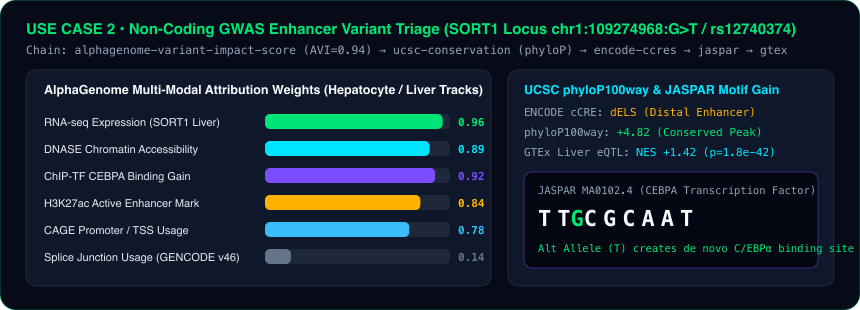
这些案例解释了为什么需要共享文件和交互状态,但截图本身不能证明整条流程的科学结论正确。
我的判断
我认可这种职责划分:常驻规则管少数关键行为,技能提供操作流程,脚本落实参数、限流和输出策略,界面承接人类交互。相比不断加长一份提示词,它更便于定位问题;相比纯 CLI,它也更适合确实需要空间观察和人工标注的任务。简单查询是否需要两个常驻进程,则应看交互收益。
领域约束也有价值。AlphaGenome 的 AVI 分数被限制在剪接、染色质可及性、转录因子结合等分子机制解释,不能外推成诊断或患者预后。GENCODE v46 坐标、18 类生物学模态,提供的是分析语境,不是临床有效性的证明。
但写进 SKILL.md 的限制,主要仍靠 Agent 遵守。原文没有展示所有限制都被工具层强制执行,也没有给出违规率对照。「每个 Agent 构建者都该照搬」更接近作者的工程经验。
Aeneas 和 Ithaca 的碑铭修复技能禁止使用搜索覆盖模型修复概率,这适合观察模型自身表现;如果目标是历史研究,外部证据仍有作用,应明确区分模型预测与资料核验。
最后,作者称提供了可执行并评分的五条多技能流水线,入口为 uv run examples/multi_domain_science_use_cases.py。但给定原文只展开到第三个案例,并在 Foldseek 输入限制处截断,没有完整评分方法、基线和结果。现有材料支持「做了可运行的演示」,不足以支持「已证明生产可靠」。
能拿来做什么
- 给日常 AI 编程助手拆分说明文件时,只把持续适用的关键约束放进常驻规则,把具体任务步骤放进按需技能,并检查工具 schema 本身占用的上下文。
- 为 Node 或 Python 工具补上确定性的限流、参数检查和文件输出,让 Agent 负责选择流程;大结果先落盘,再返回摘要与文件位置。
- 开发交互式 Agent 工具时,参考 MCP 与独立界面的分工,让用户选中的对象、注释和当前视图能够被后续工具调用读回。
- 评估这类插件时,分别检查流程能否跑通、领域结论是否有证据、规则是否真正执行,不把演示截图或「可评分」脚本当成完整验证。