DuckDB 2.0新增能力与存储升级边界
据文章介绍,DuckDB 2.0 LTS加入异步I/O、VARIANT类型、Agent模式、触发器及可扩展SQL解析器,支持期至少到2027年10月。升级需区分旧文件兼容性与新格式限制:旧版本无法打开2.0新写出的文件。
AI 深度解读
DuckDB 2.0.0 LTS 把一次大规模功能更新和明确的支持期限放在了一起。按原文介绍,这个代号为 Cinnamon Teal 的版本于 2026 年 10 月 21 日发布,补齐了远程访问、异步 I/O、半结构化数据等能力,但升级时最该盯住的是数据库文件兼容性。
对把 DuckDB 嵌在服务、脚本和定时任务里的程序员,这篇值得读的地方是一个具体判断:新功能可以逐步试,文件格式和回退路径必须提前安排。
LTS 给你的首先是一张有截止日期的日历
DuckDB 是运行在单个进程内的开源分析型数据库。它经常跟着 Python 服务、CLI 脚本、定时任务或 notebook 一起运行,各处依赖却未必同步升级。因此,支持多久,直接影响团队什么时候必须处理升级。
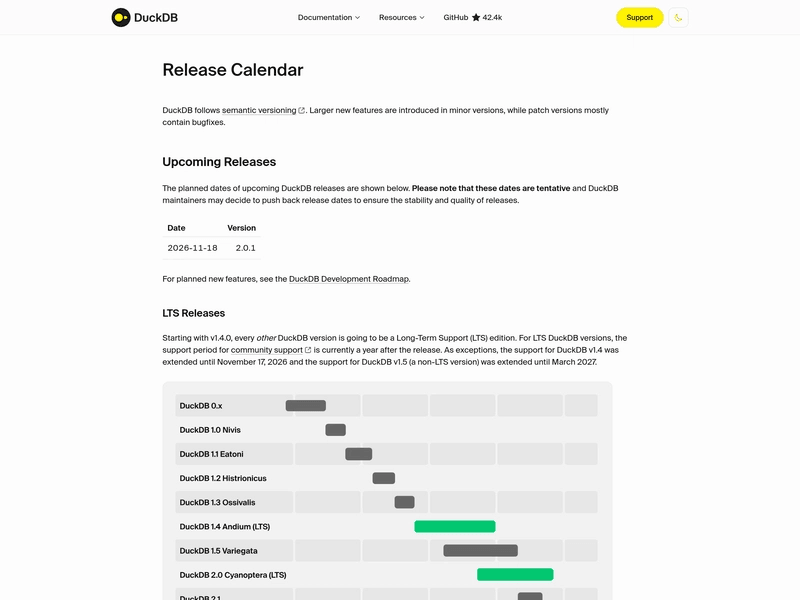
从 1.4.0 开始,DuckDB 的规则是每隔一个版本安排一次长期支持版本(LTS),目前社区支持期为发布后一年。原文列出的时间表是:
- 2.0.0 LTS 发布于 2026 年 10 月 21 日,日历中的支持结束日期是 2027 年 10 月 22 日。
- 1.4 LTS 的社区支持到 2026 年 11 月 17 日结束。
- 1.5 的支持延长至 2027 年 3 月,原文没有给出具体日期。
- 2.0.1 暂定于 2026 年 11 月 18 日发布,这个日期尚未确定。
所以,2026 年 11 月 17 日之前有三条受支持的版本线,此后到 2027 年 3 月还有两条。1.5 虽然最初不是 LTS,却因为延期获得了接近 LTS 的支持长度,可以充当升级缓冲。
LTS 承诺的是维护窗口,不是升级后不会出问题。
原文介绍的版本政策仍是语义化版本:较大的新功能进入次版本,补丁版本主要修复问题。团队需要记下支持截止日,同时决定自己何时验证、何时切换。
新功能解决了哪些实际问题
从 1.5 到 2.0,项目累计了接近 20,000 次提交,并将其称为迄今最大的功能版本。与侧重稳定性的 1.0 系列相比,这次明显在扩展使用方式,但提交数量不能直接当作性能或可靠性的证明。
第一组变化与数据访问有关。Quack protocol 早在 5 月的 1.5.3 中就已出现,让 DuckDB 可以采用传统的客户端与服务端模式;2.0 提供的是进一步完善的版本,并非首次加入。
异步 I/O 则覆盖了 Parquet、CSV 和 DuckDB 原生存储格式的读取。它让 I/O 层可以独立于查询处理扩展,同时保持多个请求进行中。远程读取经常要等待网络响应,多发出一些请求,就有机会减少等待造成的空转。项目宣称这能提高远程读取并行度,加快 S3 等对象存储上的查询,但原文没有提供基准测试。
第二组变化与输入和交互有关。VARIANT 成为一等类型,为半结构化数据提供原生容器;agent mode 让 CLI 检测到编程 agent 驱动时切换为紧凑输出。前者关系到数据如何表达,后者关系到工具输出如何被消费。原文没有说明 VARIANT 的具体查询语法,也没有量化 agent mode 能节省多少上下文。
SQL 能力也有调整。基于 PEG 的可扩展 SQL 解析器,从 1.5 时的可选项变为默认实现。新增的 CREATE TRIGGER 涉及 BEFORE、AFTER,以及行级、语句级触发方式,但支持矩阵尚不完整:BEFORE … FOR EACH ROW 和 UPDATE … FOR EACH ROW 仍不支持。迁移其他数据库中的触发器时,不能只看是否存在同名语法。
底层构建也变了:发布构建默认改用 Clang,覆盖 Linux、macOS 的引擎及核心扩展,以及 Windows CLI;大部分 Windows 核心扩展仍使用 MSVC。ICU 库被完全移除,icu 扩展自行实现时区、日历和排序规则,时区数据来自 IANA 数据库,压缩后约 45 kB。这说明内部实现有明显变化,但原文没有给出完整的行为兼容性验证结果。
升级最容易卡住的是新建文件后的回退
原文指出,2.0 最需要防范的破坏性变化在数据库文件。
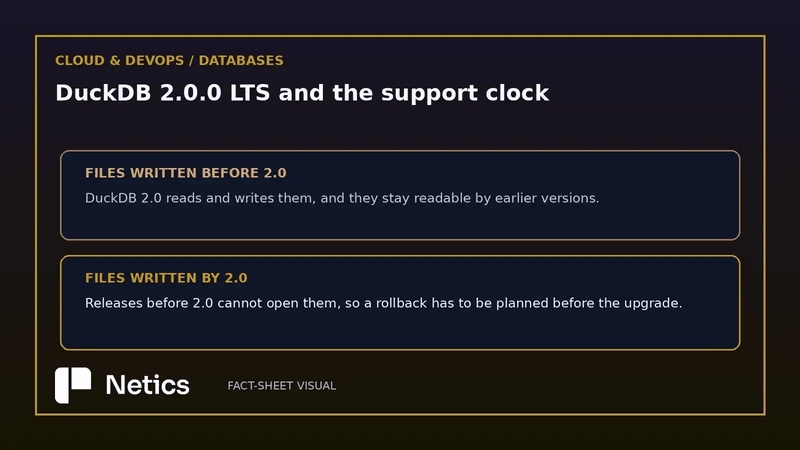
这里要分清两个动作:打开已有文件,以及创建新文件。2.0 可以读写旧版本创建的数据库文件,这些旧文件仍可被旧版本读取;由 2.0 新建的数据库文件,2.0 之前的版本则无法打开。
回退应用依赖,不等于回退已经创建的数据文件。
假设一个服务升级后创建了新数据库,随后因查询问题退回旧版客户端。代码可以退回,那个新文件却可能打不开。这也是嵌入式数据库容易被忽略的地方:升级的是应用里的库,留下的却是长期存在的数据。
原文有些概括性表述使用了「2.0 写入的文件」,具体兼容性说明则以文件的创建版本为边界。理解迁移风险时,应采用后面这个更精确的区分,避免把「旧文件经 2.0 写入」也一概视为无法回退。
作者建议先在影子环境中验证,也就是用独立副本运行新版本,不影响生产任务。升级前把重要数据导出为 Parquet,必要时使用 CSV,可以让恢复路径不依赖新的数据库文件格式。不过,这类数据导出不等于完整的环境备份,原文也没有证明它能自动恢复全部数据库定义和配置。
对关键任务,原文转述了项目的建议:可以考虑等到 11 月的首个补丁版本。等待期间仍要测试真实报表的行数和查询结果,不能把「等补丁」当成验证的替代品。
我的判断
这篇最有价值的是把功能更新放回维护周期里看。对于小团队,选择暂留 1.5、给 2.0 留出验证时间,是有明确期限支撑的安排;如果还停在 1.4,支持窗口就已经比较紧了。
但功能收益需要单独核实。异步 I/O 为什么可能改善远程读取,机制上解释得通;到底能快多少,取决于数据位置、文件组织和查询负载。原文没有对照数据,无法据此判断普通团队能获得多大收益。
影子环境、锁定客户端版本、导出数据,都属于合理的迁移经验。它们不是作者提供实测结果后证明的最优方案,文中没有展示迁移耗时、故障记录或恢复演练结果。
Quack 也值得关注,但文章没有展开连接管理、认证和部署边界。仅凭「支持客户端与服务端模式」,还不足以决定用它替换现有数据库服务。作者最后把这些变化联系到私有文档助手,是方向性联想,不能当作完成了相关场景验证。
能拿来做什么
- 如果服务、CLI 或定时任务已经使用 DuckDB,先盘点客户端版本和数据库文件的创建位置,并把 1.4、1.5、2.0 的支持截止时间写进维护计划。
- 在影子验证完成前锁定客户端依赖,避免某个任务提前升级并创建 2.0 文件;用独立副本比较真实报表的行数与查询结果。
- 升级前导出重要数据为 Parquet 或 CSV,并实际验证旧版本能否读回这些数据。恢复需要的数据库定义和配置也应单独保存。
- 如果主要查询 S3 上的 Parquet、CSV,可以优先验证异步 I/O 的实际收益;如果通过 CLI 配合编程 agent,则检查 agent mode 的紧凑输出是否适合现有流程。