用编程智能体搭建按计划执行的测试助手
作者用编程智能体在一周内构建 Saci,让其按自然语言测试计划逐步执行命令并核对预期结果。系统提供失败证据、判断说明和实时执行日志,便于人工检查测试结论。
AI 深度解读
把 Markdown 测试计划交给 AI,让它在真实环境里执行,再拿出每个结论的证据,这是 Midnight Saci 想解决的事。作者用 coding agents 在六天内搭出系统,自己负责需求、架构取舍和审查。
值得看的不只是开发速度。这个案例同时回答了两个问题:AI 怎样执行测试才方便核查,一个人怎样组织多个编程代理交付软件。它也留下了一个很实际的反例:引入小模型,并没有自动换来更低的成本。
测试交给 AI,结论凭什么可信
Wanaku 已经积累了数百个 Markdown 测试单元,内容包括创建 namespace、部署 operator、调用 CLI、检查输出。人能照着做,却很难愿意每晚重复。
Saci 接过的是这类已有流程。LLM 决定下一步调用什么,实际执行由范围受限的 shell、HTTP 和 MCP 工具完成。每次运行使用独立 worker,可以是 Podman 或 Docker 容器,也可以是 Kubernetes Job。模型接口兼容 OpenAI-compatible 服务,包括通过 OpenRouter 使用模型或连接本地 Ollama。
计划需要明确写出操作及预期结果。例如,下面这段把一次 HTTP 请求和两个验收条件放在一起:
### Test 1.1: Read an existing order

```bash
curl -sS -w '\nstatus %\{http_code}\n' "$SERVICE_URL/orders/1"
```

**Expected result:**

- The output ends with `status 200`.
- The order's `status` is `shipped`.
重点是 Expected result:不能只告诉代理「查询订单」,还要明确怎样才算通过。命令按原文保留,其中 %\{http_code} 的写法在文中没有解释,实际使用前需要验证。
Saci 的可信度设计,是把每项预期和执行证据逐条对应。
例如,创建订单预期返回 201 和订单 id,实际却返回 500,响应体为 {"error":"orders database is read-only"}。报告会分别指出两项预期被哪份输出否定,而非只给一个失败标签。
作者还划了执行边界:Saci 按计划运行,不自行增加修复步骤,也不修改代码。证据中的凭据会被脱敏。这让读者可以检查判定依据,但不能据此推断脱敏或隔离已经覆盖所有安全风险,原文没有展开这些细节。
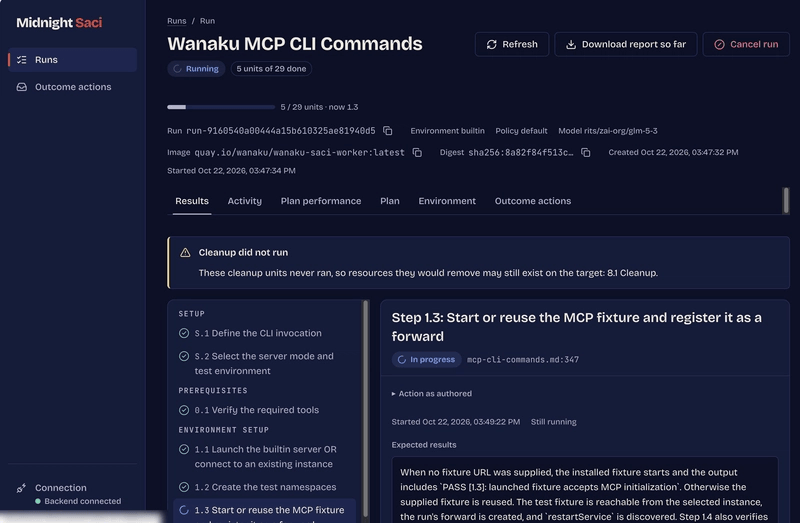
图中的计划包含 29 个测试单元,运行对象是真实 Wanaku 实例。它证明系统已经接上实际环境,但不等于已经证明判定准确率。
一次失败之后,怎样让人接得住
Saci 不只展示结果,还记录过程。Activity 页提供实时日志,每条 shell 命令都能关联证据,每次尝试会记录模型请求数和 token 用量。
Environment 页则保存 worker 镜像、操作系统、工具以及准确的 Saci 构建版本。排查历史失败时,这些信息能帮助区分代码变化和环境变化。
性能页提供了另一条有用线索:作者展示的一次运行中,模型占用 97% 的时间,工具占用 2%。
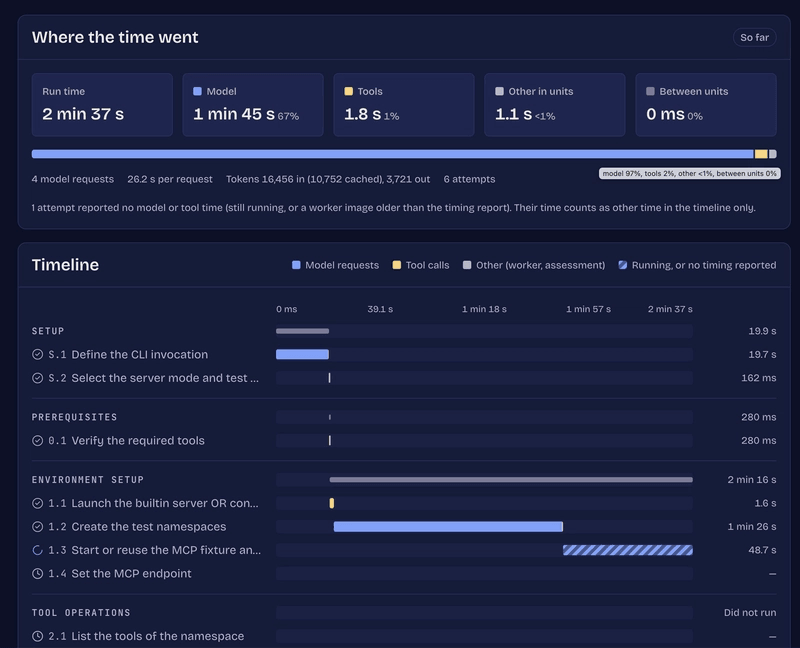
这组数据只对应该次运行,却足以指导当次优化:先检查模型调用,优化 shell 很可能收益有限。原文没有解释剩余时间的分类,也没有给出多次运行的统计。
失败之后,Saci 可以启动第二个 agent,克隆源码、阅读相关实现,输出带文件和行号的原因假设。这里的产物是「可能原因」,不能直接当作已确认根因。文章所展示的调查示例也明确使用了文档样例数据。
结果通知与测试判定分开:后端可以通过 MCP 建工单、发聊天消息或邮件,也可以等待人工批准,但这些动作不会改变判定。其他 agent 能通过 A2A 请求调查;saci-script-runner 则把管理员定义的脚本暴露为 MCP 工具,首个例子是用普通 bash 脚本发送运行结果邮件。
这套安排的价值在于缩短「发现失败到有人处理」的距离,而非让测试代理顺手修改生产代码。
六天交付背后,哪些约束真正起作用
从 2026-10-17 到 2026-10-23,仓库增长到约 40,000 行 Rust、八个 crates,同时包含 React 控制台、OpenAPI 契约、Helm charts、多架构容器镜像,以及 130 个 issues 和 pull requests。
作者说,代码由运行在云端会话中的 Claude Code 编写,自己担任审查者和产品负责人。这里的 130 是两类条目的合计,不能理解成 130 个已交付功能。
他的工作方式有几项明确约束:先写系统目标、原则、技术基线和系统形态,再由 agents 拆成 tickets,每次变更追溯到 issue;把长期规则放进 CLAUDE.md,包括生产代码禁止 unwrap 和 panic、工具脚本不用 Python 或 Perl、主要功能必须有有效测试、文档使用 Simplified Technical English,以及出现第二个真实用途前不做抽象。
质量检查交给 make check,覆盖格式、将警告视为错误的 Clippy,以及完整测试套件。agents 先修复 CI,再交给作者审查。调查功能、小模型判定器、脚本运行器和控制台页面分别使用独立线程并行推进,作者负责合并和关键设计决策。Saci 也运行针对自己的测试计划。
旧测试迁移同样体现了分工。很多 Wanaku 计划把预期藏在 echo "PASS ..." 中,提取验收标准需要理解语义,因此作者选择 agent skill 配合离线校验器:
saci skill install --all --agent claude   # or codex, cursor, copilot, gemini, opencode
saci check --strict plans/operator-basic-functionality.md
第二行最关键:代理负责转换,saci check --strict 提供明确反馈。它能指出格式问题,但原文没有证明它能判断验收标准是否完整。
作者还尝试用「System One」小型判定模型处理明显结果,复杂情况再回退给 LLM。实验使用 144M 参数的 Julia 1,通过小型 Rust 模块和 ONNX Runtime 提供服务。然而在真实 Wanaku 运行中,它很少达到足够置信度,几乎所有步骤仍交给 LLM。微调只是下一步实验,尚未给出效果。
我的判断
我认可它把执行、证据、调查和后续动作拆开的思路。测试需要保留失败现场,让同一个代理一边验收一边自由修复,会增加解释结果的难度。
但「一个人一周做出真实系统」仍是作者的经验报告。代码量、组件数量和 CI 通过,不能替代长期稳定性、误判率、维护成本和使用成本。原文没有提供与人工执行或固定自动化脚本的对照数据,「节省时间」也没有量化。
更值得复用的是约束和反馈机制,而不是六天交付的速度目标。
对于格式稳定、断言清楚的测试,传统脚本通常更容易追踪执行路径。Saci 的尝试更适合已有大量自然语言操作计划、迁移又涉及语义判断的情况。两者如何划界,仍需要结合误判和成本数据决定,不能仅凭一次模型耗时占 97% 就下结论。
能拿来做什么
- 把现有接口或 CLI 验收文档补成「命令、预期结果、输出证据」三部分。前端和 Node 项目的接口联调,也能先从明确状态码、响应字段开始。
- 让 AI 转换旧测试计划时,同时提供能离线运行的校验命令。格式检查完成后,仍要人工抽查验收条件是否遗漏。
- 给日常 AI 编程建立可执行的交付门槛,把类型检查、lint 和必要测试接进 CI,再把人工审查精力放在行为和设计上。
- 尝试替换测试判定模型前,先记录请求数、token、耗时和回退比例。小模型只有真正接住足够多的步骤,才可能兑现成本收益。