8.0
热点
AI SCORE
编程提效2026-10-06 07:07
DevFest 演讲实录:如何客观评估 AI 辅助开发体验
dev.to · AI#AI辅助开发#评测#Agent Skills
Editor brief · 编辑速览
演讲者调查发现多数开发者使用 Agent Skills 但不确定是否真正改善了开发体验,提出系统性评估框架——核心观点是"我们烧 token 是为了让开发者不必烧",并给出实际度量维度。
本文是 2026 年 10 月 3 日在 DevFest Melbourne 上演讲的编辑整理稿。为便于阅读格式理解,添加了小节标题。演讲者评语以斜体呈现。演讲中的所有图片均由 Nano Banana Pro 生成。
嗨!我是 Katie,今天给大家带来的是"评估 AI 辅助开发体验"。
我很喜欢那种在第二张幻灯片就给你总结的演讲,所以先来看总结:
我们烧 token,你们不用烧。
希望接下来的演讲能让这个结论变得合理。
好,先来统计一下观众情况,举手回答:
在座谁知道"智能体技能"(Agent Skills)是什么?大部分观众举起了手。
大部分观众举起了手。
继续举着——有人用过智能体技能吗?没想到,更多人举起了手。
更多人举起了手。
再坚持一下——你们觉得自己使用智能体技能确实对开发体验有帮助吗?大部分人把手放下了。
大部分人把手放下了。
有意思!帮大家补补课,来个回顾:
摘自 agentskills.io 的定义:
Agent Skills 是一种轻量级、开放的格式,用于通过专业知识和工作流扩展 AI 智能体的能力。
这是一个不断发展的领域,但总体来说:技能就是一个文件夹,里面有 SKILL.md 文件,可选地附带其他内容:脚本、参考资料、资源,或其他有助于 AI 智能体完成任务的东西。技能的元数据包括名称和功能描述。
技能可以是任何有助于智能体完成任务的东西。
你可以创建自己的个人技能,帮助处理日常工作流,比如帮你撰写月度通讯,或者分类未读邮件。你可以有一个坐落在工作区中的智能体,它知道在给出代码建议后自动应用你项目的代码规范。
或者,你可以导入别人创建好的技能。
Google 把一堆技能打包好了!
可以在 skills 仓库获取:github.com/google/skills
目前约有 150 个技能,而且还在增长。
如果你在使用任何 Google 产品,可以安装专门了解该产品的技能。就算你装了很多技能,仓库里甚至还有一个技能能帮你找到合适的技能来使用。
安装这些技能可以满足你的开发需求。
技能真的有帮助吗?
使用技能后,你是否得到了更快、更准确的答案?
因为确实,你可能会听到有人说他们感觉技能有帮助。如果你自己也装了一些,你可能也会觉得效果变好了。如果你打算把自己的技能分享给别人使用,就像我们现在在做的这样,你需要知道这些技能确实能改善结果。你需要实证数据,就像发布软件之前要测试一样。
在我们这个案例中,可以借助一些早期的神经网络研究。
Keith-Magee, Russell. 2001. "Learning and Development in Kohonen-style Self Organising Maps",Curtin University。https://hdl.handle.net/20.500.11937/162
AI 研究在课程呈现和训练顺序的重要性方面已经探讨了 25 年。教模型时,你先从基础开始,然后逐步细化。你向学生呈现信息的顺序很重要。
因为在这种情况下,当你使用智能体时,它内部已经封装好了很多东西,你提供的是最后一刻的用户输入或系统提示词,那是优先级最高的东西。
技能是一份作弊小抄。
智能体技能就是给智能体用的作弊小抄。与其让智能体每次都要调用网络搜索工具,不如以技能的形式直接给它答案。
回想一下你曾经参加的那场"开卷"考试吧?你可以把教科书带进去!你不需要背下教科书里的所有内容,对吧?因为你可以把它带进考场!
但当你把教科书放在那里,却不知道里面有价值的信息在哪的时候,你会花很长时间翻来翻去找答案,结果花在答题上的时间反而更多。而在考试时间只有一个小时的情况下,你必须保证答题速度,否则时间不够,题目答不完。(倒不是说本人有什么经验。)
智能体技能就是那种有时允许你带进去的一页纸或手写笔记。花时间准备这样一份资料本身就是一种学习,它帮助你了解有用的信息在哪里,这样找起来更快、理解起来更容易,你就能更快地回答问题。
AI 智能体会根据技能描述来审视有哪些技能可用,然后如果看起来合适,就会加载该技能及其所有附加资源,再从那里继续思考如何回答你的问题。它使用预先整理好的信息来帮助更快地回答问题,而不是仅靠内置的知识语料库,或者去查整个互联网——后者给出的信息未必总是正确的。
但要验证技能是否真的能让回答更快、更可靠,我们需要评估技能在回答问题方面是否对智能体有用。
google/skills 真的有帮助吗?
这就是我过去几个月一直在做的这个项目的核心问题。
我所在的团队一直在评估 Google Skills,持续向技能作者和领导层提供数据,展示这些技能是否真的有用。
我们想要证明:如果开发者安装了我们的某个技能,他们将获得更准确的结果、消耗更少的 token,并得到更快的响应。
评估框架
可供使用的评估框架有很多,而且这个列表也在不断变化。
如果你已经在某个生态系统中,那里已有评估框架,就用那个。
DeepEval 和 harbor 是我听说过的其他有用的框架。
我们使用的是 Inspect AI。它由英国 AI 安全研究所和 Meridian Labs 开发,被全球多家 AI 安全机构和 AI 研究实验室采用。
如果你有兴趣自己尝试 Inspect,可以访问 g.dev/ai/eval-aide 体验 codelab。
from inspect_ai import Task, task
from inspect_ai.dataset import Sample
from inspect_ai.scorer import model_graded_qa
from inspect_swe import gemini_cli

@task
def skills_eval(skills):
    questions = [
        Sample(
            input="How do I deploy a Cloud Run service?",
            target="gcloud run deploy"),
        ), ...
]
return Task(
            model    = "google/gemini-3.8-flash"
            dataset  = questions,
            solver   =  gemini_cli(skills=skills),
            scorer   = model_graded_qa(),
            sandbox  = "docker",
   )
这是一个评估任务的示例,用 Python 编写。
这里展示了一个包含多个要素的简单评估。
我们有输入数据集
其中包含一系列问题提示和目标答案
这里的 solver 是 gemini_cli——即执行我们问题的智能体。在这个案例中,我们使用的是 Inspect SWE 包提供的实现,它包含多个不同的软件工程智能体。
最后,scorer 是"模型评分问答"——一个 LLM 充当裁判,检查答案是否包含目标值。
但这是 Python。对于想用这个评估系统的人来说,这是一个限制。Python 不应该成为门槛。
语言不应该成为障碍
"实现所用的语言对最终用户毫无影响"
Dr Keith-Magee,就是前面课程顺序论文的同一作者,提出了这句话,我经常引用它。没有任何理由要求想要评估技能的人同时还得学会 Python。
在 Google Agent Skills 的案例中,写技能的人是 Google 员工,他们对自己技能所针对的特定 Google 产品或功能具有专业知识。
他们可能不懂 Python,或任何编程语言。这不应该成为阻碍。
我们的解决方案是围绕 Inspect AI 创建了一层封装,允许用户用 YAML 而非 Python 来定义任务。
我们在这里做的是定义一个测试矩阵。
测试矩阵定义了一组不同参数的组合来运行测试。
变体越多,你能得到的不同组合就越多。
在我们的案例中,针对每个提示词:
我们测试多个不同的模型:Gemini(多个版本)和 Anthropic 的 Claude
我们进行"技能消融"测试——即同一个提示词在启用技能和不启用技能时的表现对比。
我们对同一个提示词运行多次。
Inspect AI 将这称为"轮次"(epochs)。
我们这样做是因为 AI 具有非确定性,所以如果多次运行同一个测试,我们可以检查结果的一致性。
我们可以使用不同的智能体运行测试:Gemini CLI、Antigravity CLI、Claude Code 以及 Agentic AI Foundation 的 Goose。
最终,我们的配置看起来是这样的:
version: 1
description: Weekly Evaluation for Google Skills

models:
 - google/gemini-3.8-flash
 - google/gemini-3.1-pro
 - anthropic/claude-sonnet-5

variants:
 - variants.yaml

task_parameters:
  dataset: prompts.yaml
  eval_tasks.gemini_cli:
    agent_framework: "gemini-cli"
    include-variants: [baseline, skills_github]

model_roles:
 - grader: google/gemini-3.8-flash
我们使用不同的模型——这里是撰写时最新的 flash 和 pro 模型,进行技能消融测试,选择我们想要的智能体——负责执行任务的角色,以及我们选择的评审器——负责检查任务结果的角色。
由于这个矩阵涉及这么多维度,这让我们的测试变得……很有意思。
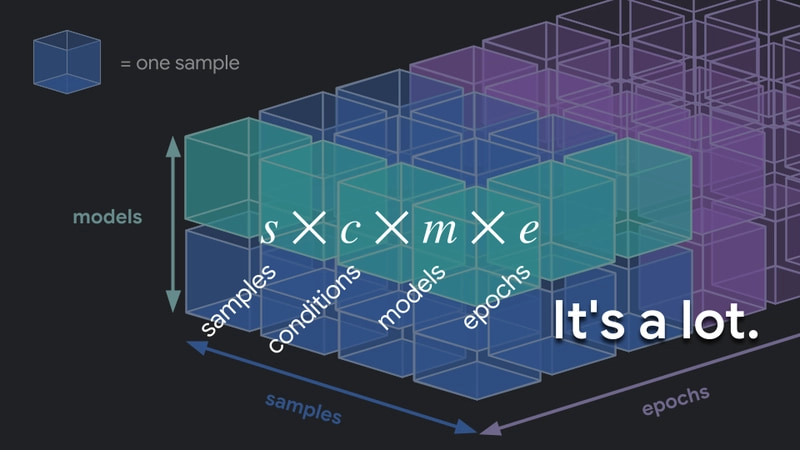
对于单个样本,你需要运行
但随后你需要对测试套件中的所有样本运行测试,
然后你还需要针对每个模型进行测试,
然后还要不断地重复测试。
你需要运行的测试总数将是
样本数量
乘以条件数量(有技能和无技能)
再乘以你要测试的模型数量
然后再乘以轮次数量以应对非确定性。
这是真正的数据科学级别的测试量。
编写评估和设计评分标准
但在这些所有工作中,你需要实际编写正确的评估。
就像单元测试和代码覆盖率的理念一样,你可以运行大量测试,但如果你测试的内容不对,结果会很差。
糟糕的评估会提供虚假信号,浪费你的 token 预算,并在指标中产生噪声。
演讲的这部分然后总结了以下 DEV 帖子:
https://dev.to/googleai/how-to-design-ai-evaluations-you-can-actually-trust-41c3
https://dev.to/googleai/how-to-write-reliable-rubrics-for-llm-as-a-judge-evaluations-ndp
对于所有这些建议,请记住:
我们知道 AI 在能偷懒的时候会尽量偷懒。
但是,对于智能体技能,我们提供的是一份经过验证的作弊单,我们希望 AI 使用它。我们花了时间编写了这份考试时的 goto 信息一页纸,当 AI 看到这份资料时,它会使用它。
所以如果有最佳实践,把它放进你的技能里。如果有应该使用的工具,加上它。让智能体有最大的成功机会。
那么,考虑到所有这些,我们的项目进展如何了?
我们每周对所有技能进行评估。然后处理数据,生成显示技能随时间改进情况的仪表板,随着技能的迭代发展。这让我们能够向作者提供持续的迭代反馈,而无需他们自己运行评估。我们还花了大量时间扩展环境以支持发布的大量技能。
考虑到我们工作的规模,架构在这个项目中很重要。
整体设计相当一致。
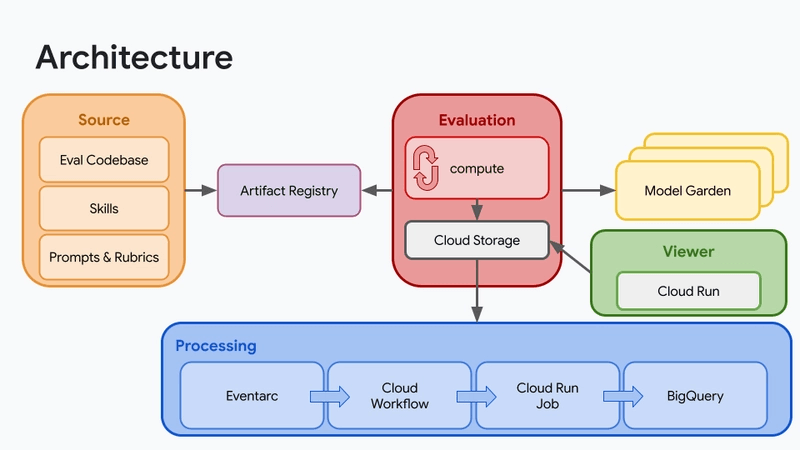
我们有评估源代码,其中包含帮助我们处理技能和提示词的工具,我们将它们打包并发布到 Artifact Registry。
然后当我们准备运行评估时,计算节点从 Artifact Registry 拉取数据,并在沙箱中运行评估,调用所需的任何模型。我们可以支持任何托管在那里的模型作为评估的一部分,包括 Sonnet :)
Inspect AI 将结果流式传输到二进制的 .eval 文件,我们在构建时将它们存储在 Cloud Storage 中,这样我们可以在 Cloud Run 中看到进度,Cloud Run 使用 Inspect AI viewer Web 服务来查看从 Cloud Storage 传入的文件。
当评估完成后,我们向存储桶写入一个特殊文件,然后被处理。当我们的"完成"文件被写入时,Eventarc 触发事件,然后启动一个 Cloud 工作流,将相关信息发送到 Cloud Run 作业,后者对 .eval 文件执行后处理,并将结果存储在 BigQuery 中,为仪表板提供数据支持。
所以这个架构的大部分方面都是产品名称,但"计算"这里看起来有点……模糊。
我们还需要大规模地扩展这个环境。
如果你看一下 GitHub 仓库的提交历史,可以看到随着时间推移有多少技能被纳入。
加上我们的测试矩阵,你可以看到我们处理的数字。
幻灯片显示了一张图表,有一条向右上升的线,以及一些柱状图。
你可以在图中看到这条线形图代表技能数量,一直在上升
我们在 7 月和 8 月每周发布很多技能,那段时间大量工作快速迭代以跟上进度。
这个图中的柱状图是我们的文本矩阵向量的值:轮次、模型和智能体。
不过,我们不能在这里使用堆叠图,因为所有这些维度需要相乘
柱状图的数字是相乘在一起的
我们目前的总评估乘数是 36,包含所有不同的组合。
但我们还没有乘以技能数量。
线形图从大约 150 上升到大约 1100。
我们用评估数量乘以这个数字。
每个技能有两到多个评估提示词,每个提示词运行 36 次。
所以上次我运行数据时,我们进行了大约 3 万次不同的检查。
7 月的峰值是因为我们一次添加了太多东西,不得不缩减回可持续的水平。
刚开始时,我们对每个样本测试 3 次,但被要求将轮次增加到 9,以确保一切运行一致。
这没问题,直到执行的测试数量开始攀升。之前的峰值是我们添加了更多模型和更多智能体,这意味着我们运行了 5 万次检查,这不是我们每周能合理完成的。我们的一个向量必须改变以帮助我们支持规模。
因此,通过与数据科学专家合作,我们能够确认将轮次从 9 减少到 6 在统计上是合理的。当我们扩展正在使用的模型数量时发生了这种情况,所以评估的总数保持不变(大致)。
当时也是我们手动运行这些作业的时候,作为澳大利亚的工程师,所以我们有周一的工作时间来运行评估,并在美国周一之前准备好仪表板的数据。考虑到我们发展的规模,已经有一段时间没有评估作业在工作时间内完成了。
通过这个配置更改,我们能够在测试矩阵中添加新的模型和智能体。之前我们只测试 Gemini 模型和 Gemini CLI,但现在我们测试 Anthropic 的 Sonnet 和 Opus,并使用 Claude Code 作为智能体。
这很重要,因为我们想了解当使用 Google 生态之外的模型时技能的表现如何。我们理解并非所有使用 Google 产品的开发者都使用 Google 的 AI 工具来支持它,所以了解特别是无技能基线测试在这些模型上的表现如何,以及技能带来多少改进是很重要的。
我们尝试使用 Cloud Run 作业来运行评估,如果你添加 Cloud Scheduler 应该允许更早开始评估。然而,使用这种设置我们受到可用 CPU 的限制。Inspect AI 默认按可用 CPU 数量扩展配置,所以只有基础的 8 个 CPU 意味着我们的评估确实运行了,但速度不如我们希望的那样快。为了解决这个问题,我们使用了 Cloud Run Jobs 的多任务能力将评估的不同分片分片到 GKE 中。
我们在 GKE 上的实验遇到了这个计算平台所能达到的吞吐量的瓶颈。Inspect AI 生态系统确实有 Kubernetes 沙箱插件,但以我们运行评估的规模,我们没有获得预期的结果。我们怀疑我们遇到了 Kubernetes 控制器限制,因为正在扩展的并行沙箱 Pod 数量太多了。
运行完所有评估后,得到了结果!
这是 Inspect AI 在一次示例运行后展示的视图示例
可以看到矩阵,简化为只包含 3.6 和 3.5-flash 两个版本,以及基线和技能两组数据。
可以对比这些数值。
gemini API 基线示例得分 0.28,而启用技能的版本得分 0.55。提升了 25%!
在查看器中可以点击查看结果详情、工具调用等所有信息。
但这对不熟悉数据科学的人来说并不友好。
因此,把处理后的数据导入 Data Studio 仪表板,让技能作者能更直观地看到自己技能的表现情况。
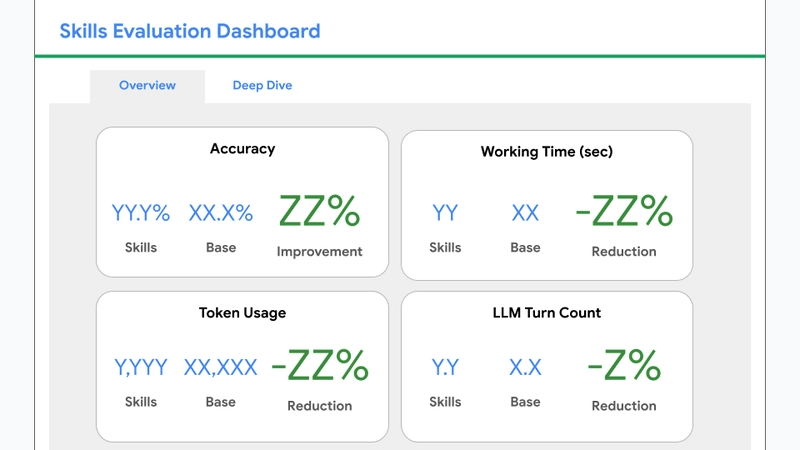
这是仪表板的视图。这是概览页面,展示了所有技能消融的顶层平均值。
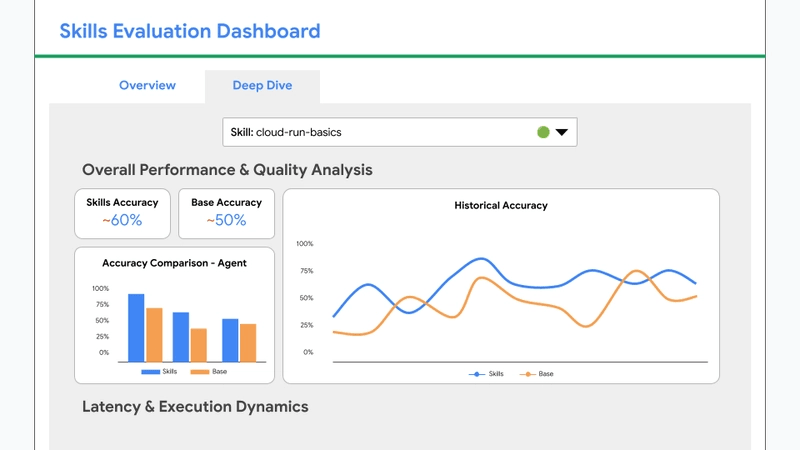
这是单个技能的详细视图。
这是历史数据的匿名化视图,但确实显示了启用 cloud run basics 技能后,基于 Cloud Run 的提示获得了 10 分的提升。
向下滚动页面,作者可以直接链接到每条提示和结果,返回 Inspect AI 查看器查看具体评估的更多详情。
更重要的是,他们想看技能是否达标(绿色)。
如果技能显示为绿色,则表示该技能已通过,采用基于两个因素的总体通过/失败判定:
启用技能的评估准确率超过 50%,更重要的是:启用技能的评估相比无技能准确率的提升超过 5%。这很重要,因为这意味着我们获得了足够大的改变,以证明安装该技能是合理的。
了解我们获得了足够大的改变以证明技能安装的合理性,这很重要。
仪表板还包含当前数据点和历史图表,涵盖多个因素:
通常,我们希望技能的准确率更高,而轮次/时间/token 均低于基线版本。
总结一下:我们烧 token,是为了你不必烧。
我们有数月的实证数据证明,如果你在 Google 生态系统中使用 AI 智能体,使用 Google Agent Skills 将提升查询效率并减少 token 使用量。
今天演示的所有资源和参考文献可以在二维码处找到。
二维码与整场演示相同:g.dev/ai/eval-aide
感谢你的时间!