DeepInfer 部署门槛:从引擎到服务
DeepSeek 开源的 DeepInfer 面向数据中心多机多卡推理,采用 Apache 2.0 许可,并附带 Rust 分词组件 deepseek-recipe。文章拆解模型权重、推理引擎、在线服务和应用运行环境四层边界,说明显存、集群拓扑与 RDMA 网络要求。
AI 深度解读
DeepInfer 开源,交付的是面向数据中心的推理引擎。把它接成可供业务调用的模型服务,还要补上鉴权、计费、限流和故障处理;把它部署起来,则需要远超普通开发机的集群条件。
原文最有用的地方,是用四层边界解释「开源了什么」和「你还缺什么」。但文中的性能收益、收益测算和本地工具推荐,需要分开看:有些是团队报告的工程结果,有些只是社区推算,还有些带着明显的产品推广倾向。
开源推理引擎,离可用的 API 还有多远
据原文,DeepSeek 于 10 月 20 日以 Apache 2.0 许可证开源 DeepInfer,同时发布 Rust 组件 deepseek-recipe。DeepInfer 从 vLLM 演进而来,面向超大规模混合专家模型(MoE)和多头潜在注意力(MLA)的推理场景。
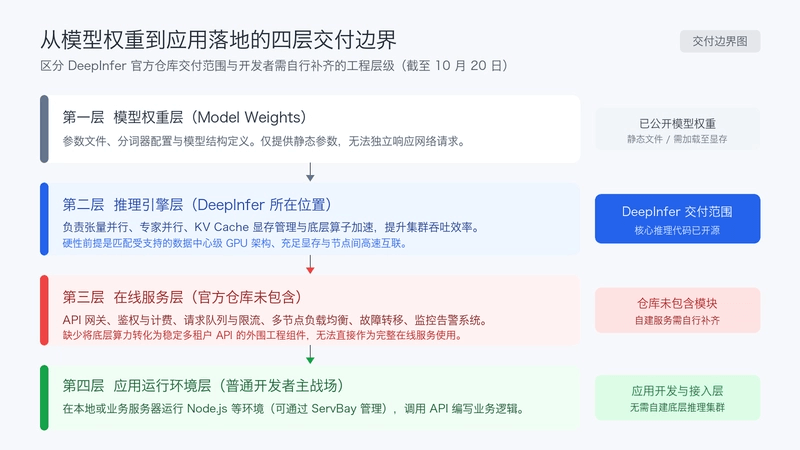
理解它的交付范围,可以沿着一次请求经过的四层看:
- 模型权重是参数文件,通常有数百 GB,保存在硬盘上不会自己回答问题。
- 推理引擎负责把权重加载到显存,协调 GPU 执行计算。DeepInfer 和 deepseek-recipe 位于这一层。
- 在线服务层把计算能力包装成可运营的 API,负责注册、API Key 鉴权、余额计费、并发限制、排队、故障切换和监控告警。
- 应用运行环境承载 Node.js、Python、数据库、提示词流程和前端页面,通过网络调用第三层。
拿到第二层的源码,不等于拿到了第三层的完整服务。
deepseek-recipe 容易让人误判,因为它能处理 API 协议。它把 OpenAI Chat Completions、OpenAI Responses、Anthropic Messages 转成统一的内部表示,再通过分段并行编码处理长文本分词,并在底层阻止特殊 Token 注入。
但协议转换只解决请求怎么被理解。谁可以调用、用了多少额度、某个租户是否超限,仍然需要服务端系统处理。特殊 Token 注入防护也不能被扩大理解为解决了所有提示词注入问题。
性能收益成立的前提,是整套集群一起工作
DeepInfer 优化的是昂贵硬件的利用率。GPU 如果不断等待 CPU 调度、数据搬运或其他阶段完成,即使算力很强,也会间歇性闲置。
原文给出三类做法。第一,通过 GPU 与 CPU 的异步流水线重叠,让等待和计算尽量同时发生。第二,为推测解码加入变长验证,团队报告其在生产环境中额外带来 6% 吞吐提升。第三,使用 SWA Bounded Replay,针对存活时间只有分钟级的滑动窗口缓存,跳过磁盘写入,每次只重算最后 128 tokens,原文称可让预填充计算量减半。
这里的「减半」有明确场景,不能直接解释成所有请求成本减半。
硬件要求也解释了这些优化服务于谁。系统从设计上分离预填充(prefill)和解码(decode):前者处理输入,使用常见的 8 卡机器;后者逐 Token 生成答案,使用 64 至 128 卡超级节点,以平衡吞吐和延迟。
文档里「用最便宜的单卡」的建议,指向多模态组件中的 Vision Encoder,并非整个主模型。
缓存系统同样属于集群工程。原文称,团队为保留超过 72 小时的 Agent 流量 KV Cache,以及完整 7 天的聊天缓存,建设了 100 PiB 的 3FS 分布式存储,依靠 RDMA 高速网卡与 GDR 技术实现 10 TiB/s 聚合读取带宽,并让缓存换入显存与前向计算重叠。
这些数字描述的是团队的生产设施。原文没有明确区分哪些是最小部署要求,哪些是其业务规模下的配置,不能直接把 100 PiB 当成所有部署的最低门槛。但它足以说明,普通工作站和常规云主机内网,并不对应文中这套运行条件。
应用开发者应该接在哪一层
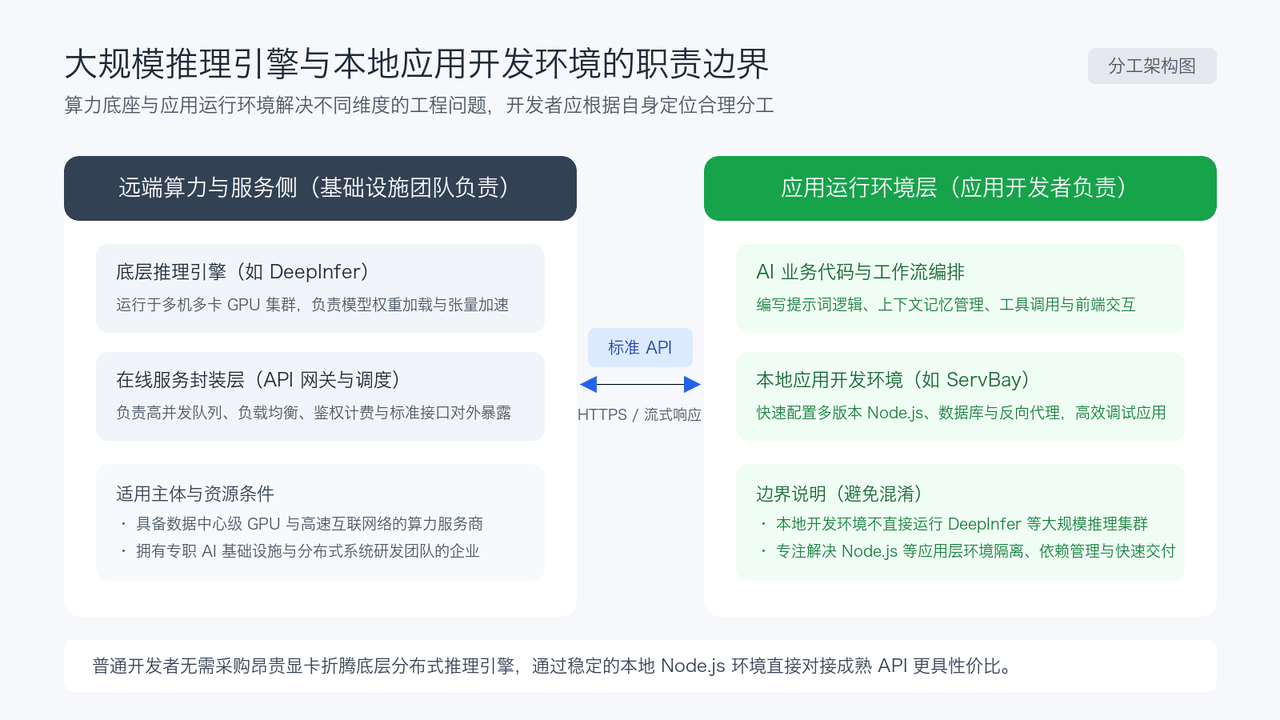
如果目标是在现有项目中接入 DeepSeek,原文建议把精力放在第四层:稳定运行本地 Node.js、数据库、缓存和反向代理,通过 HTTPS 调用已经部署好的模型服务。
原文推荐 ServBay 管理这些环境,并举出 Node.js 20 与 Node.js 16 项目并存的版本冲突。不过,运行环境管理与推理集群部署是两件事,ServBay 在这里负责前者。
下面的代码解决从本地 Node.js 向远端模型服务发起请求的问题。原文有一张图片插进代码块中,这里将图片移出,代码内容保留:
// 从本地 Node.js 环境调用兼容 DeepSeek 的 API
// 前提:已通过 ServBay 在本地启用 Node.js 18 或以上版本

async function askDeepSeek(question) {
  const apiKey = process.env.DEEPSEEK_API_KEY;
  const url = 'https://api.deepseek.com/v1/chat/completions';

  const response = await fetch(url, {
    method: 'POST',
    headers: {
      'Content-Type': 'application/json',
      'Authorization': `Bearer ${apiKey}`
    },
    body: JSON.stringify({
      model: 'deepseek-chat',
      messages: [
        { role: 'system', content: 'Please answer technical questions in crisp, concise Chinese.' },
        { role: 'user', content: question }
      ],
      temperature: 0.3
    })
  });

  if (!response.ok) {
    throw new Error(`Request failed with status code ${response.status}`);
  }

  const result = await response.json();
  return result.choices[0].message.content;
}
要看清 process.env.DEEPSEEK_API_KEY 这一行:这是服务端 Node.js 示例,不能直接搬进浏览器前端并暴露密钥。它展示了最小请求流程,没有提供超时、重试或流式响应处理;也没有自行部署 DeepInfer,而是调用现成服务。
我的判断
四层划分很实用。它把选型问题从「这个项目能不能装」推进到「团队准备承担哪一层责任」。Ollama、LM Studio 面向个人电脑上的模型运行体验,DeepInfer 面向分布式集群的吞吐优化,用安装便利性评价后者,确实容易错位。
但硬件门槛应当限定在原文描述的架构与部署范围内。原文没有给出缩小规模、替换模型或修改架构的实验,因而不足以证明所有个人设备上的适配尝试都绝对不可能。
性能和收入也不能混着读。6% 吞吐收益、预填充计算量减半,是原文转述的团队结果,文中没有展开模型配置、负载和对照测试。社区拿每日 155 万亿 Tokens 推出每 GPU 每小时 38 美元账面收入,甚至宣称毛利率超过 90%,更不能当成经营结论。训练、研发、电费、GPU 折旧以及实际利用率,都没有被完整核算。
至于「多数 AI 应用停滞源于环境」和「依赖处理耗掉半个工作日」,文中没有对照数据,应当视为经验判断。ServBay 可以作为一种环境管理选择,但原文没有证明它优于已有的版本管理、容器或开发环境方案。读者需要拿走的是职责边界,无须把工具推荐一并当成结论。
能拿来做什么
- 接入模型前,先写清团队要负责哪几层。前端和 Node.js 团队若只需要模型能力,可以先通过服务端调用现成 API,把预算投入会话状态、业务流程和界面体验。
- 阅读部署文档时,把主模型、Vision Encoder、缓存系统的要求分别记录,确认「单卡可运行」究竟指哪个模块,再评估硬件。
- 评估自建服务时,除了引擎吞吐,还要列出鉴权、计费、限流、排队、故障切换与监控的交付成本,避免把推理成功当成服务已经可运营。
- 使用示例接入项目时,把密钥留在服务端,并按实际需求补齐超时和错误处理。已有 Node.js 环境能稳定工作,就先沿用,再判断是否需要更换管理工具。