本地模型怎么选?先算清内存与显存
开源 Python 工具 Jaull 根据硬件和使用需求,从 Hugging Face 元数据中筛选模型,给出文件、运行时及 GPU 卸载配置。它分别估算内存与显存占用,并将实测结果绑定文件哈希、机器和测试协议,避免混用不同量化版本的成绩。
AI 深度解读
本地模型能不能跑,不能只看参数量和显卡容量。Jaull 想把反复下载、换量化版本、试到崩溃的过程,变成一份针对当前电脑的运行方案:选哪个文件、用什么后端、多少层交给 GPU,以及为什么这样推荐。
它更值得关注的地方,是把内存估算和机器实测分开。作者甚至撤掉了误差过大的速度预测,只在测过之后展示速度。对准备尝试本地 LLM 的程序员,这比一张笼统的硬件推荐表更有参考价值。
推荐的应该是运行方案,而不只是模型名
作者在毕业设计中研究小公司运行本地语言模型需要什么硬件,最初靠下载模型、观察崩溃或运行缓慢,再换量化版本试验。Jaull 就来自这段试错过程。
它是带终端界面的开源 Python 工具,会检测 CPU、RAM、GPU 和可用后端,再询问用途、优先考虑什么、使用语言,以及是否用于商业场景。随后只读取元数据搜索 Hugging Face,不需要先下载模型文件。
最终最多给出五套方案,每套明确到具体文件、运行时、后端和 GPU 卸载配置,并解释排序原因。GPU 卸载(offload)可以理解为把模型的一部分计算交给显卡承担。
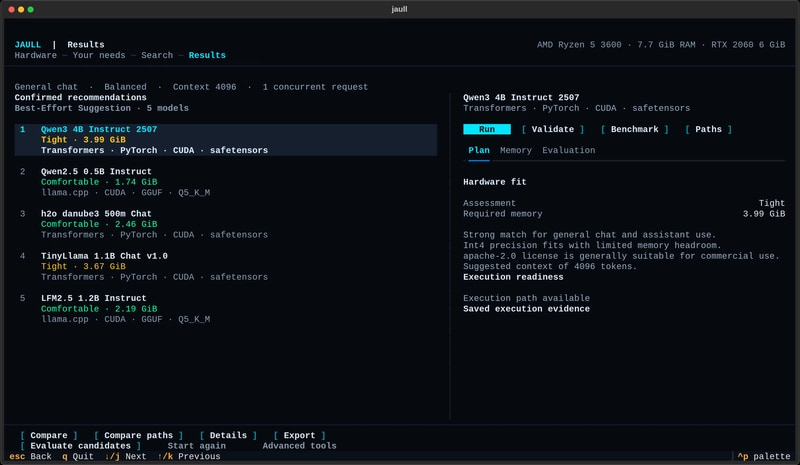
这个粒度很重要。同一个模型采用不同量化文件、不同卸载方式,资源占用和运行速度都可能不同。只告诉你「可以跑某个 7B 模型」,离真正启动还有几步。
能装下和跑得快,必须分开验证
Jaull 按权重、KV cache、额外开销和预留余量估算内存,同时把 RAM 与 VRAM 当成两个独立资源池。KV cache 是生成过程中保存的注意力键值数据,也会占用内存。分别计算,才能指出先耗尽的是系统内存还是显存。
但估算只是起点。用户可以在本机运行方案、做基准测试或评分,结果会连同文件 SHA-256、机器信息和测试协议一起保存。只有与方案匹配的结果,才能改变推荐排序。
测过 Q5_K_M,不能拿结果替旁边的 Q6_K 背书。
作者在 RTX 2060 上的几组结果,说明了为什么需要这么较真:
- 指令遵循测试中,1.2B 模型明显胜过 1.5B 模型,参数更多并不保证更适合任务。
- Qwen2.5-7B 最初的卸载策略只跑到 21.5 tok/s,GPU 大量闲置;全部层放到 GPU 后达到 59.4 tok/s,显存只多用 133 MB。
- 修正卸载计算公式后,同一次测试场景达到 44.9 tok/s,但仍低于全部卸载的结果。
- 简单的速度预测器曾给出 170 tok/s,实际只有 18 tok/s。作者因此移除了界面中的速度预测,改成实测后才显示。
这里最有用的教训是:装得下,不代表配置合理;估得出,也不代表测得到。
还有无法可靠比较的指标。对于承担显示输出的 GeForce,作者指出 Windows 不会报告每个进程的显存占用,因此 Jaull 在这种情况下标注「not comparable」。这不等于显存没有消耗,而是缺少可比较的数据。
先拿推荐,再决定是否安装运行环境
原文给出的启动方式如下,用来安装并进入 Jaull:
git clone https://github.com/Ton-Llop/Jaull.git
cd Jaull
uv sync --locked
uv run jaull
留意 uv sync --locked,安装时使用仓库锁定的依赖。获取推荐不需要 llama.cpp,实际运行方案时才需要它。
不过,作者明确说 Jaull 尚未完成,也没有在真实硬件上测试 Intel(Vulkan)和 AMD 支持。检测到后端、能够生成方案,与已经验证过这套硬件能稳定运行,是不同程度的承诺。
我的判断
我认可它把推荐落到具体文件和配置,并限制实测结果的适用范围。相较于只按参数量或显存容量筛选,这种做法更接近用户真正要完成的事。
但原文提供的仍是作者在 RTX 2060 上的个别测试,没有给出完整的模型名单、指令遵循评分方法或跨机器对照数据。1.2B 胜过 1.5B,能说明参数量不能独自决定排序,不能进一步推出小模型普遍更好。
卸载策略的结果也很有启发,但不足以形成通用公式。其他显卡、模型和上下文配置下,133 MB 显存换来多大收益,需要重新测量。
Jaull 适合用来缩小试验范围,最终选择仍要由本机实测决定。
它比手工轮流下载更有组织,但原文没有提供对照数据来证明整体能节省多少时间,推荐质量也还需要更多硬件验证。
能拿来做什么
- 准备在开发机上跑本地模型时,先用 Jaull 获取具体文件和运行配置,确认 RAM、VRAM 各自的限制,再决定下载哪个版本。
- 比较日常 AI 编程候选模型时,把任务表现与生成速度分别记录,不要仅凭 1.2B、1.5B 或 7B 这样的参数规模做选择。
- 如果模型能运行却明显偏慢,检查 GPU 卸载配置,并在修改前后测量 tok/s 和显存占用,确认瓶颈是否来自配置。
- 为团队保存测试结果时,同时记录文件 SHA-256、机器和测试协议;更换量化文件后重新验证,避免沿用不匹配的结论。