Caret:自带密钥的轻量开源AI编辑器
Caret 0.2.0采用Tauri 2、Rust与React/Monaco,借助系统WebView运行界面,无需捆绑Chromium或运行时Node。模型请求从本机直接发送给所选服务商,代码以MIT协议公开。
AI 深度解读
Caret 想把 Cursor 式的 AI 编程体验,做成一个开源、模型请求直接发往所选服务商的编辑器。作者给出的方案是 Rust 核心、系统 WebView,以及可接入多家模型和现有 CLI 订阅的统一界面,当前版本为 0.2.0,采用 MIT 许可证。
它值得看的地方,是把改动验证、命令权限和长任务管理放进了编辑器工作流。但「不用 Electron 就更省内存」并没有被作者的数据证实,VS Code 插件兼容性也仍是明显缺口。
换掉 Electron,究竟省下了什么
Caret 使用 Tauri 2:核心是搭配 tokio、mimalloc 的 Rust 进程,界面由 React 19、Monaco 和 xterm 构成。macOS 使用 WKWebView,Windows 使用 WebView2,Linux 使用 WebKitGTK,运行时没有 Node,也没有扩展宿主进程。
这套架构省去了应用自带的 Chromium 和 Node,但系统 WebView 同样需要内存。
作者在 release 构建中测得:打开一个 TypeScript 文件和终端时,Caret 整个进程族约占 490 MB;同一机器上,空闲 Cursor 约为 393 MB。测试方法和改进计划放在 docs/PERFORMANCE.md。
这组数据不能证明 Caret 更省内存,两边的工作负载也没有完全对齐。
编辑器基本功则覆盖得比较广:Monaco 支持分组、差异编辑、面包屑和大纲;语言服务协议(LSP)客户端覆盖 TypeScript、Rust、Python、Go、C、C++、Java 等;调试适配器协议(DAP)客户端支持 Node、TypeScript、Python,并读取现有 launch.json。Git 功能包括提交、分支、stash、worktree、blame,以及类似 Bugbot 的代码审查。
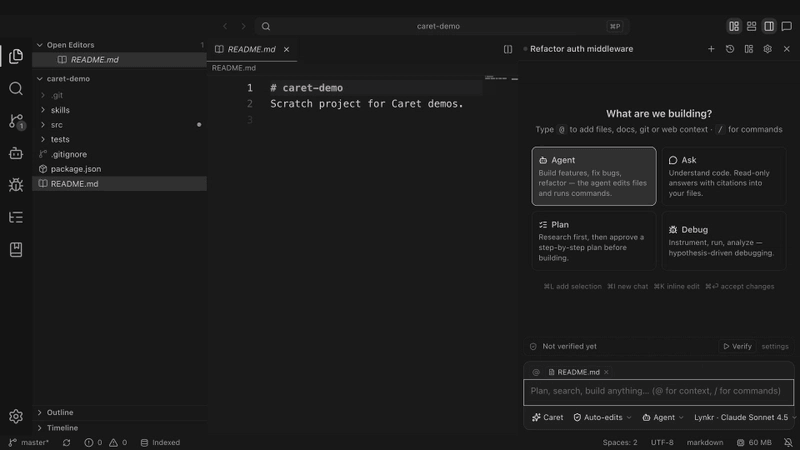
日常体验上的重点,是把 AI 放进已有操作。Tab 根据最近修改、打开文件和诊断生成多行补全,支持部分接受与下一处编辑预测,并尝试与 LSP 建议保持一致。Cmd+K 在代码中生成流式差异,在终端中把自然语言变成 shell 命令。
终端还能按命令边界分组输出、显示退出状态、点击路径跳转行号,并为失败命令提供修复入口。不过,这些是作者的功能陈述,原文没有补全质量或修复成功率的对照数据。
Agent 的可靠性,要看退出码和执行边界
Caret 的 Agent 面板提供 Agent、Ask、Plan、Debug 模式,支持逐轮检查点、逐文件审阅、上下文摘要和实时费用。它读取 .caret 文件、.cursorrules、AGENTS.md、CLAUDE.md,也支持 memories、hooks、slash commands、skills 和 subagents。
更有价值的是两道具体机制。
第一道是 Verified diffs。每轮结束后,Caret 会在用户接受修改前,运行检测到的构建、测试、lint、类型检查等项目检查,把证据和风险等级放在变更旁边。用户看到的是进程退出码,而不只是聊天里的「测试通过」。
但原文没说清:检查命令识别不完整时怎样处理,风险等级又如何计算。项目没有有效测试,编辑器也无法凭空补足验证能力。
第二道是 shell classifier。Agent 发起的命令会先拆分、分类;被阻止或列入拒绝名单的命令不执行,递归删除、git clean 等破坏性命令需要审批,并指出危险片段。按作者描述,经由 Caret 终端执行的 Claude Code、Codex 命令也经过这道关卡。
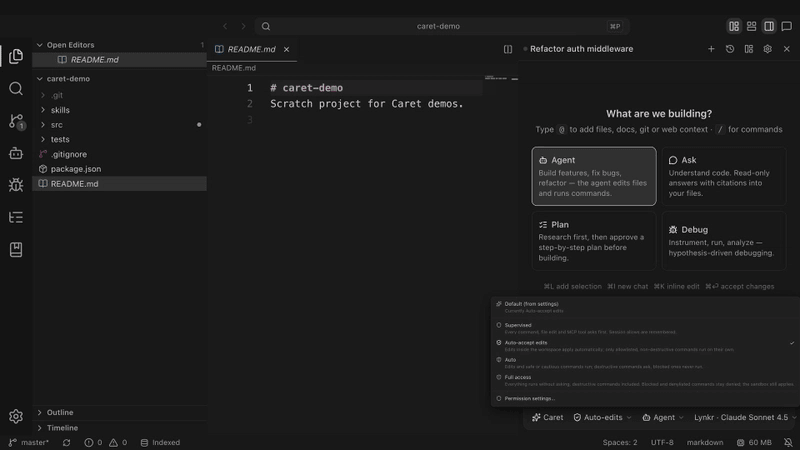
权限模式叠加在分类器之上:Supervised 每次询问;Auto-accept edits 接受工作区内编辑;Auto 按分类结果执行,遇到破坏性操作仍暂停;Full access 除被阻止的命令外都运行。项目可通过 .caret/settings.json 限制权限上限。
作者描述的沙箱实现是 macOS Seatbelt 和 Linux bubblewrap,允许写入工作区,把主目录其余部分设为只读。Windows 对应的隔离方式没有交代,不能据此推断三端具有相同保护。
模型、订阅和长任务,怎样放进一个界面
Caret 直接连接 Anthropic、OpenAI、Google、OpenRouter、Ollama、LM Studio、vLLM,以及 OpenAI-compatible endpoint。密钥保存在本地 JSON 文件,请求直接发往用户选择的服务商;本地模型可离线用于聊天、Tab 和 embeddings。
这里的「直连」只是少经过一层中转,使用云模型时,请求内容仍会发送给所选服务商。
已有订阅走另一条路径:通过 Agent Client Protocol(ACP)驱动厂商自己的本地 CLI。支持对象包括 Claude Code、Codex、Cursor、Grok Build、Gemini CLI、OpenCode、Pi,各自使用自己的登录状态。Caret 明确表示,不会拿订阅 token 去重放厂商 API 请求。
选择模型 Auto 时,受管理的 Lynkr 辅助进程会给请求评分,在用户配置的模型层级之间路由,支持会话固定和失败回退,并显示实际回答的模型。原文没有给出路由质量、延迟或节省费用的数据。
长任务管理则更接近待办事项:线程可以置顶、定时稍后处理、标记完成、归档,归档有五秒撤销。运行期间可排队追加消息,Alt+Enter 在下一步前插入指令,Cmd+Shift+Enter 把草稿发到后台新线程。
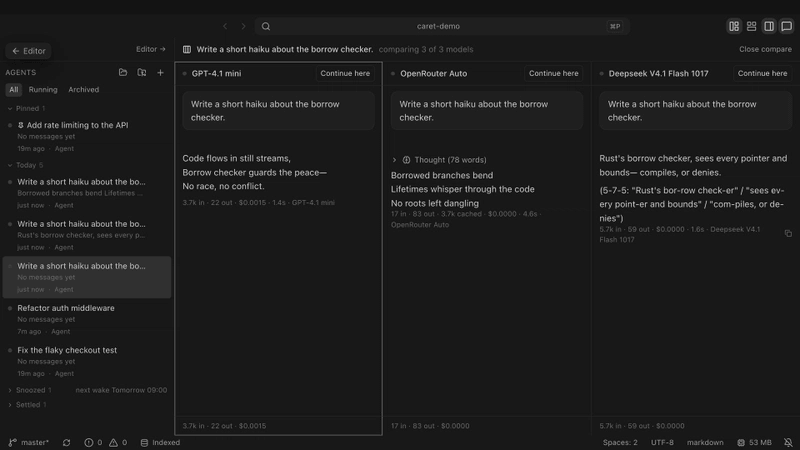
用户还可以从消息处分叉、向其他 Agent 转交限定上下文预算的任务,或让多个模型同时回答,分别使用线程和 git worktree。本地账本记录 Agent、Tab、审查、提交信息等请求的 token 与费用,并只读汇总 Claude Code、Codex、OpenCode 的本地历史。
对外集成有两个方向:Caret 能作为带 bearer token 的回环地址 MCP 服务,提供创建线程、派发任务、读取记录和处理审批等工具;也能通过 caret serve,在局域网或 Tailscale 中开放浏览器访问。后者由 Mac 继续执行任务,浏览器通过认证 WebSocket 转发命令,使用六位配对码和可撤销 token。
这依赖它的前后端契约:Tauri 命令统一采用 snake_case 的 domain_action,跨边界 serde 类型与 src/types.ts 对应,流式数据走 Tauri channels。远程端因此可以复用界面,只替换传输层。
我的判断
我更看好 Caret 对「改完如何验、命令如何执行、任务如何接续」的处理。这些机制直接影响程序员能否放心把一段工作交出去。相比只提供聊天和补全,它给出了更可检查的过程。
但「Cursor class」目前更适合看作产品目标。它没有 VS Code 扩展市场,不带 Chromium 的扩展宿主仍在规划中。LSP、DAP、MCP、ACP 能覆盖部分需求,无法替代所有团队已有的插件工作流。
作者提到 cargo 和 vitest 合计接近六百个自动化测试,Agent 核心可无界面运行,编排和远程服务会通过真实 HTTP、WebSocket 做端到端测试。这说明项目有验证投入,但不能推导出跨平台成熟度。作者也承认,Windows、Linux 安装包的运行测试远少于 macOS。
因此,它更适合愿意尝鲜、主要依赖标准语言服务和 CLI Agent 的开发者。关于更轻、路由更划算、工作效率更高,原文缺少充分对照,现阶段仍要当作设计取向和作者经验来看。
能拿来做什么
-
先用一个熟悉的前端或 Node 项目试跑,检查
launch.json、类型检查、测试和构建能否被正确识别。重点观察 Verified diffs 实际执行了什么,以及失败时展示了哪些证据。 -
已有 Claude Code、Codex 等订阅时,可以先试 ACP 接入,检查登录、权限提示、差异审阅和终端执行是否连贯;需要 API 或本地模型时,再比较直连与
Auto路由的实际成本。 -
安装可使用原文提供的脚本:
curl -fsSL https://caret-ochre.vercel.app/install.sh | sh需要留意末尾的
| sh:下载内容会直接执行。偏好 Homebrew 的用户可使用另一组命令:brew tap fast-editor/caret brew trust fast-editor/caret brew install --cask caret其中
brew trust fast-editor/caret对应原文所说的 Homebrew 7 第三方 tap 信任步骤。macOS 构建目前采用 ad-hoc 签名,浏览器下载的 DMG 需要执行xattr -dr com.apple.quarantine并指定应用路径;安装脚本和 Homebrew cask 会处理这一环节。