用 AWS 构建可处理重复与乱序的票据流水线
方案组合 Textract、Bedrock 与 AWS 事件及编排服务,将发票和收据转为结构化数据。设计同时考虑重复事件、乱序处理、字段校验和不确定结果的人工复核。
AI 深度解读
把发票上传到云端,让 AI 读出金额,并不等于做成了一个可靠的报销或应付账款系统。作者给出的 AWS 方案,重点是把文件接收、重复事件处理、票据识别、金额校验和人工审核串成一条可追溯的工作流,Amazon Bedrock 只承担可选的辅助解释。
这篇值得程序员读的地方,是它把「识别成功」和「业务处理正确」分开了。不过,原文提供的是参考架构,没有部署实测、识别准确率或成本对照,适合用来检查方案是否漏项,不能直接当成上线效果的证明。
同一张发票,为什么需要两种去重
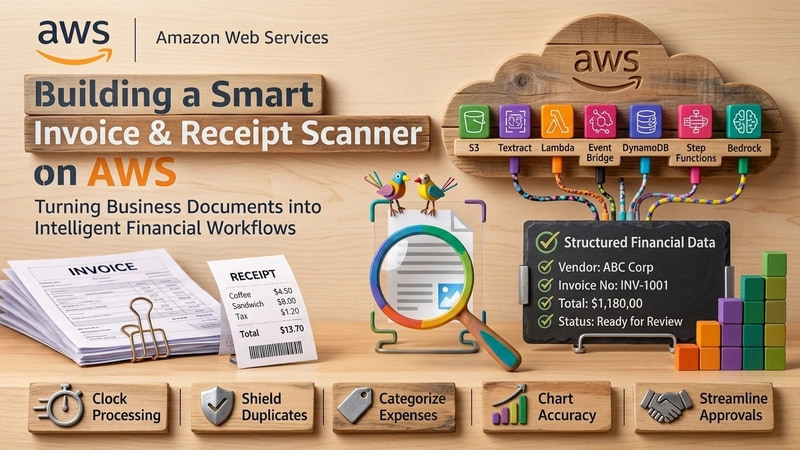
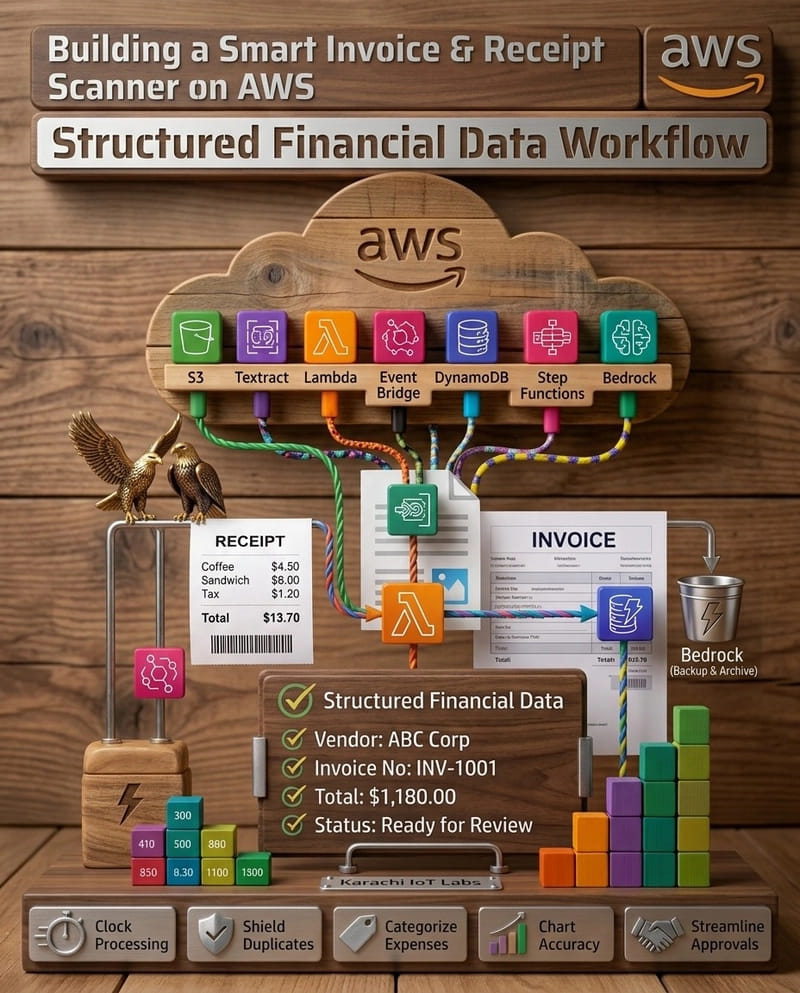
作者设想的入口包括邮件、客户门户、移动上传和共享文件夹。文件进入 Amazon S3 后,经 Amazon EventBridge 触发 AWS Lambda,再由 Amazon DynamoDB 记录事件身份和处理状态。
这里首先要解决的是消息可靠性。S3 事件通知采用至少一次投递,同一个事件可能收到多次,事件到达顺序也没有保证。如果每收到一次通知就新增一条发票记录,重复入账的风险就从入口开始了。
对于支持的对象事件,S3 的 sequencer 可以帮助判断先后:同一个对象键下,十六进制值 00B5 比 00A1 更新。比较前要给较短的值左侧补零,再做字典序比较;不同对象键的值不能拿来排序。
DynamoDB 可以记录 documentKey、latestSequencer、status 和 versionId。接受新事件时,需要条件写入或其他原子状态转换。先读状态、在 Lambda 里比较、再直接写回,会给两个并发任务留下同时通过检查的机会。
事件去重解决重复通知,业务去重解决重复票据,两者必须分别设计。
例如,incoming/invoices/invoice-1001.pdf 和 incoming/email/vendor-invoice-october.pdf 是两个对象,却可能装着同一张发票。作者建议结合标准化供应商身份、发票号码和币种生成候选重复键,但匹配后通常应进入复核。供应商复用号码、贷项通知单和更正发票,都可能让简单匹配误伤正常业务。
另一个容易漏掉的细节是版本读取。启用 S3 Versioning 后,工作流应按事件携带的版本标识读取文件。否则旧事件延迟到达时,读取对象键拿到的可能已经是新内容,事件记录和实际处理文件就对不上了。
Textract 负责提取,金额正确要靠规则判断
Amazon Textract 的 AnalyzeExpense 用于提取发票和收据里的摘要字段、商品描述、数量、价格等信息。它比只返回整页文字的 OCR 更贴近票据处理,但提取结果仍需要标准化和校验。
下面是原文用 Boto3 调用接口、读取摘要字段的示例:
import boto3

textract = boto3.client("textract")

response = textract.analyze_expense(
    Document={
        "S3Object": {
            "Bucket": "invoice-scanner",
            "Name": "incoming/invoices/invoice-1001.pdf"
        }
    }
)

for expense_document in response.get("ExpenseDocuments", []):
    for field in expense_document.get("SummaryFields", []):
        field_type = field.get("Type", {}).get("Text")
        field_value = field.get("ValueDetection", {}).get("Text")

        print(field_type, field_value)
要看的是 SummaryFields 这一行:示例只遍历摘要字段,没有展示行项目解析、置信度处理,也没有指定对象版本。作者明确说它只是基本调用,权限、文档限制、错误和重试都需要另外处理。耗时较长的任务还可使用异步接口 StartExpenseAnalysis 和 GetExpenseAnalysis。
提取成功也不能证明金额合理。原文举例:小计 $1,000,税额 $100,总额却是 $1,250。即使每个数字都识别准确,这张票据仍应被标记为异常。
下面的函数解决最简单的加总校验:
def validate_invoice(subtotal, tax, total, tolerance=0.01):
    expected_total = subtotal + tax
    difference = abs(expected_total - total)

    return {
        "expected_total": expected_total,
        "difference": difference,
        "is_valid": difference <= tolerance
    }
要留意 difference <= tolerance:这里默认容差为 0.01,并假设输入已经转成兼容的数值类型,没有折扣、附加费或额外舍入规则。它展示的是校验思路,不能直接覆盖所有票据。
Amazon Bedrock 则放在规则之后,辅助归类费用、概括内容、解释异常、生成审核备注。原文没有指定模型或给出分类准确率。算术、币种标准化、税额计算、必填字段和会计规则,应由确定性逻辑负责。
工作流的价值,是让失败也有明确去处
完整链路里,AWS Step Functions 负责协调已接受事件、读取指定版本、启动和获取 Textract 分析、标准化、校验、业务去重、可选 AI 分类、存储及通知。
这些步骤不能共用一种失败处理。临时服务错误可以重试,无效文件应进入异常路径,低置信度和缺失字段需要人工审核,金额不一致需要标记。工作流还要定义超时和失败出口,并通过执行历史定位卡点。
作者给出的业务记录示例中,发票 ET-2026-1001 的日期为 2026-10-20,币种为 USD,小计 1000.00、税额 100.00、总额 1100.00。它的状态是 READY_FOR_REVIEW,重复检查状态是 NOT_FLAGGED。这是应用自定义的数据模型,并非 Textract 固定响应格式。
「等待审核」这个状态很重要:高置信度且校验通过,只代表可以进入审核或后续流程;付款仍需组织授权的审批程序。
存储也要留证据。原始文件与生成结果分开,使用 incoming/、processing/、processed/、failed/、reports/ 等前缀,保留源文件引用和处理元数据。输出目录还必须避开入口触发规则,否则 Lambda 写文件可能再次触发自己。
安全方面,作者要求最小 IAM 权限、存储和传输加密,以及 CloudWatch 日志、指标和告警。Amazon SNS 通知应减少敏感信息暴露。发送给 Bedrock 的内容也应按任务裁剪,票据中的文字只能作为待分析数据,不能成为 AI 执行指令或绕过授权的依据。
我的判断
我认同这套方案的优先级:先保证文件、事件和状态对应,再谈 AI 提供多少便利。对已经使用 AWS、又需要异步处理和审核留痕的团队,这份服务分工有参考价值。
但它还不能算完整实现。原文没有给出 DynamoDB 条件表达式、Step Functions 状态机定义,也没有说清一个关键竞争问题:旧任务先被接受,随后新版本开始处理,旧任务最后才完成,如何阻止它覆盖新结果?这是根据架构推导出的待补环节,最终结果写入也需要检查版本或任务身份。
选型上,小规模内部系统也可以先用任务队列、数据库唯一约束和明确的状态字段搭建流程。是否需要同时引入 EventBridge、DynamoDB 和 Step Functions,要结合团队已有设施与排障能力判断。原文没有提供两类方案的维护成本对照,不能据此认定 AWS 服务组合更省钱。
作者同样没有展示真实票据测试集、异常比例或节省工时。其价值主张目前属于设计预期,应通过平均处理时间、提取准确率、异常率、重复检测率和单份处理成本来验证。
能拿来做什么
- 做上传后台时,把源文件、对象版本、处理任务和业务记录关联起来,让前端能展示等待、处理中、失败和待审核状态,并能回到对应原件。
- 用 Node 或 Lambda 消费文件事件时,分别设计事件幂等与业务重复检查;并发接收和最终结果写回都要防止旧状态覆盖新状态。
- 接入票据 AI 时,先实现必填字段、金额、币种和重复检查,再增加摘要与分类;审核界面应清楚区分提取值、规则校验结果和 AI 建议。
- 上线前用模糊扫描、旋转页面、缺失字段、多币种、更正发票和重复上传组成测试样本,同时模拟重复通知与乱序完成,用真实结果决定哪些步骤可以自动推进。