交互式 AI 视频如何处理点击与片段衔接
文章讨论视频反应尚未下载完成时,动作调度、浏览器解码与缓存如何共同影响交互响应。通过让反应片段从同一关键帧出发并回到该帧,减少切换时的姿态跳变,但生成结果仍需检查。
AI 深度解读
点一下视频里的猫,下一段反应还没下载完,界面该怎么办?Cariora 作者把这个问题拆到了素材生成、动作调度、浏览器解码和缓存。结论很明确:互动是否自然,取决于整条播放链路能不能接住用户的操作。
这篇值得读的地方,是它记录了几个容易被误判成「模型不够好」的工程问题:画面为什么跳、宠物为什么不回应、预加载为什么没起作用。对做视频交互的前端来说,这些比继续调整生成提示词更有参考价值。
视频能不能接起来,先由素材决定
Cariora 的房间把对话和预先准备的视频反应组合起来,角色包括数字猫狗。这里讨论的是视频部分:怎样把独立片段拼成可交互的连续体验。
上图是场景参考图,实际房间播放的是准备好的反应片段。这个区别很关键:系统能展示什么动作,受已有素材约束。
单段视频好看,不代表相邻两段能顺畅衔接。上一段结束时猫还探着身子,下一段却从端坐开始,切换就会跳变。作者的做法是给普通反应设置同一个房间锚点,也就是共同的姿态和构图参考。
下面这段关系描述解决的是片段从哪里开始、最后回到哪里:
room anchor -> reaction -> room anchor
room anchor -> glance   -> room anchor
room anchor -> rest     -> room anchor
要看的是每一行末尾的 room anchor:普通反应结束后都应回到共同状态,后续片段才有稳定的接入位置。
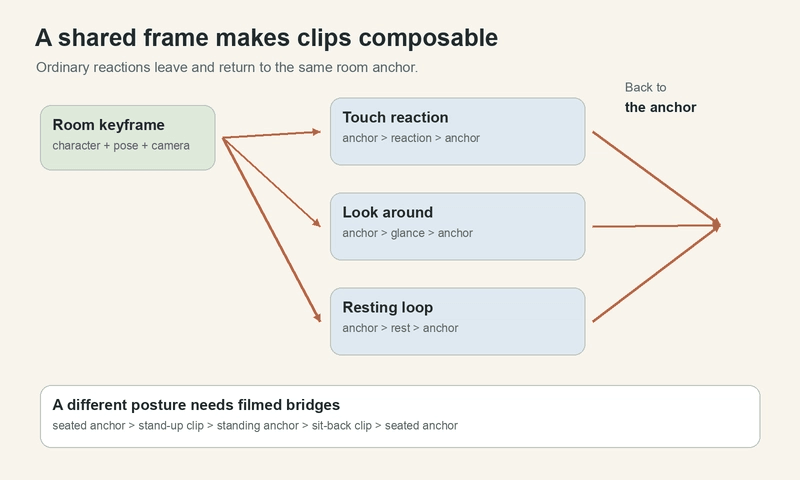
生成请求会把同一张图指定为起始帧和结束帧,但模型未必遵守。作者还会检查交付帧,淘汰不合适的素材;同一场景尽量使用一致的视频模型,以减少纹理和构图变化。
站立则是另一套状态:需要坐到站的过渡、站立休息循环,以及返回坐姿的片段。把静态图片向上移动,补不出身体真正站起来的过程。
新增姿态会同时增加素材成本和调度复杂度。
切换是否自然,要看姿态,也要看画面有没有上屏
作者早期把「运动很少」当作可切换的条件,后来发现不够。角色举着手停住,运动量虽然低,切到端坐状态仍然突兀。
回到房间锚点时,切点需要同时满足低运动量和姿态接近锚点。特定片段之间,也可以使用人工审核过的匹配帧。大幅动作则可能只能等到允许的边界再切换,调度器无法凭空创造安全出口。
浏览器播放还会制造另一种跳变。早期演示曾在动作之间插入 poster,但 poster 和视频宽高比略有差异,裁切发生变化,看起来就像背景移动了。
作者现在会在下一个解码器准备期间保留当前画面。这里有个前端容易忽略的细节:play() 的 Promise 完成,并不证明新视频帧已经出现在屏幕上。支持 requestVideoFrameCallback 的环境,可以用它观察视频帧送往合成器的时机。
Cariora 在解码器交接时观察帧状态,并为准备失败设置有限恢复过程。不过原文没有给出具体恢复次数、等待阈值或兼容方案,不能照着描述就认定播放器实现已经完整。
先让第一次点击有回应,再加载更多花样
早期加载顺序是待机、几段丰富表情,最后才到通用触摸反应。用户看到宠物动起来,自然以为可以互动,实际需要的片段却还排在下载队列里。
调整后的顺序是:待机之后立即加载通用触摸反应,再加载其他早期有用的响应。换房间则采用另一套顺序,确保入场视频能赶上场景切换。
加载器限制并发,并允许用户请求的片段提高优先级;测得传输速度较低时,还会降低并发,减少后台下载对当前响应的争抢。原文没有公布并发数或测速阈值,这部分是策略说明。
对于尚未下载好的反应,系统先确认收到点击,再进行有上限的等待。规则允许时,可以播放已经加载、语义兼容的触摸片段;等待超时,就解释房间仍在准备。根本没有对应素材的动作应显示为不可用,人类角色也不该因为复用组件,就继承狗的玩耍按钮和音效。
预加载还必须命中播放器实际读取的资源。Cariora 用同一个同源 URL 辅助函数,把对象键转为播放器路由:
object key:   uploads/cariora/ab/<content-hash>.mp4
player URL:  /api/pet-assets/uploads/cariora/ab/<content-hash>/mp4
注意第二行结尾的 /mp4:这是为避开本地中间件把 .mp4 结尾路径提前识别为静态文件的问题,属于该项目的具体适配。
预热和房间使用相同的普通 GET,并读取完整响应体。房间加载器获取字节后,再给解码器提供 blob URL,让切换复用已经下载的片段。
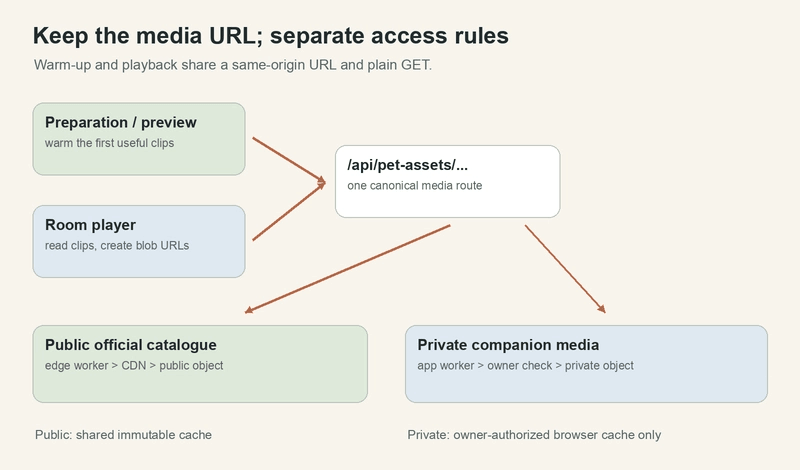
统一入口还承担权限分流:边缘 worker 检查明确列出的官方公开素材索引,允许它们使用共享 CDN 缓存;其他对象交给应用 worker 校验所有者权限,使用私有浏览器缓存。公开路径还保留字节范围请求能力。
内容哈希只能标识固定字节,不能证明访问权限。涉及用户上传照片生成的角色,这条边界尤其重要。原文提到 Cache-Control 的 public/private 区别,但没有给出完整响应头配置。
我的判断
我认同作者把「第一次点击」作为检验入口。它能同时暴露下载顺序、动作抢占、冷却逻辑和画面呈现的问题,比只验证某个模块更接近用户体验。
作者确实用空缓存、限速网络,从真实领养或角色列表入口进入房间,在首段待机出现后立即点击。检查的不只是耗时,还包括确认反馈、反应是否正确,以及问候或后台动作有没有挤掉请求。
这找到了两个具体缺陷:初始播放时间戳为零,导致从未播放的反应被误判为冷却中;迟到的问候素材又会覆盖待处理的触摸请求。它们都能表现为「点了没反应」,调整视频提示词解决不了。
不过,作者没有给出修改前后的延迟数据,也没有和其他方案做对照。这是一份有具体故障依据的工程经验,尚不足以证明某套调度或缓存策略最优。
与实时生成动作相比,预制片段更容易围绕已有素材安排衔接,但覆盖范围也被素材库限制。长动作可能必须播完;说话使用预制运动,无法随意做到音素级口型同步。原文也没有比较两种路线的成本和延迟。
调度可以更好地利用已有动作,却补不出缺失的动作。
能拿来做什么
- 做类似视频角色时,先准备一个锚点、一段待机和一个触摸反应,跑通最小交互,再增加姿态和表情。
- 前端验收时,用空缓存和限速网络复现首次进入后的立即点击,测到实际响应帧呈现,并检查请求是否被后台动作覆盖。
- 在 Node 或其他服务端实现媒体入口时,让预热和播放复用同一资源路径,同时明确公开素材索引、所有者鉴权和缓存范围。
- 给操作定义清楚状态:正在加载时确认并限时等待,没有素材时直接说明不可用,避免界面承诺角色做不到的动作。