把编码任务交给 Agent 前先明确五件事
文章将可委派任务拆为触发条件、输入、执行步骤、交付物和停止条件,强调先定义完成与复核边界。方法适用于缺陷处理、发布说明、文档维护及定期简报。
AI 深度解读
把任务交给 Coding Agent,难点往往在于人有没有把工作交代完整:从哪里开始、可以看什么、做到什么算完成、遇到什么必须停。原文的核心判断是,委派效果首先取决于任务怎么组织,而不是先找一个更聪明的模型。
这篇适合正在用 AI 修 Bug、补文档、整理发布说明的程序员。它没有模型跑分或效率实验,提供的是一套交接方法:先把一个稳定的小任务写清楚,在监督下反复运行,再逐步扩大范围。最有用的部分,是把「能做事」和「有权执行最后一步」分开。
任务能不能交出去,先看能否写清五件事
作者给「可委派任务」设了五个组成部分:
- 触发条件(Trigger):新 Issue、合并后的 PR、日历事件,或者周一简报。
- 输入(Inputs):允许使用的文件、链接、日志和既有决策。
- 步骤(Steps):实际应该遵循的处理顺序。
- 产出(Output):下一个人或系统需要接收的具体成果。
- 停止条件(Stop condition):什么时候暂停、询问,或者拒绝猜测。
这五项解决的是同一个问题:让任务不再依赖发起人脑子里的隐含知识。
比如「维护这个仓库」很难交接,因为它没有明确终点;「根据已合并的变更起草本周发布说明,交给人审核」就清楚得多。前者把排期、判断和执行揉在一起,后者有输入、有产物,也有结束位置。
作者建议先选一个无聊、稳定、重复发生的工作。适合起步的包括:把可复现的 Bug 报告整理成调查简报和草稿 PR,检查命令或 API 变更后哪些文档失效,以及从指定来源生成定期简报。
「让产品更好」、没有写作要求的开放式文案、规则每周变化的工作,以及依赖审美、协商和现场判断的决策,都不适合作为第一次尝试。
先交出去一条能走通的小流程,再考虑扩大职责。
这里还有一个容易被跳过的动作:人先手动做一遍,记录真实步骤。先打开哪个文件,为什么跳过某项检查,看到什么才认为完成,都应该写下来。作者强调的不是流程写得漂亮,而是把真正影响结果的上下文留下。
好指令要告诉 Agent 怎么做,也要告诉它何时停
原文用一个 Bug 处理任务展示了差别。「Handle this bug.」只有意图,下面这份指令才包含可执行的交接内容。它解决的是从问题报告走到调查结果和修复草稿的过程:
Trigger: new bug report labeled "needs-repro"

Goal: prepare an investigation brief and a draft fix for human review

Inputs:
- issue body and comments
- failing test or reproduction notes, if present
- related files mentioned in the report

Steps:
1. Restate the user-visible failure in one sentence.
2. Reproduce or explain why reproduction failed.
3. List likely files and constraints.
4. Propose the smallest patch that addresses the reported failure.
5. Note tests run and tests skipped.

Output:
- investigation brief
- draft patch or PR description
- open questions

Stop if:
- expected behavior is a product decision
- reproduction is impossible with current info
- the fix would change public API without approval
最该看的是 Stop if: 后面的三项。预期行为需要产品决策、现有信息无法复现、修复需要未经批准地改变公共 API,都不能靠 Agent 自行补全。
这对前端问题尤其容易理解:一个按钮点击后没有反应,可能是事件绑定丢失,也可能是需求根本没定义清楚。Agent 可以调查实现,却不能仅凭现有代码替产品决定按钮应该做什么。
作者还建议在指令里明确允许的工具、禁止的动作、输出示例和质量要求。例如研究简报可以要求每个事实都有来源链接;文档更新可以限定为扫描变更的 CLI 命令、列出受影响页面、起草补丁,再停下来等待措辞审核。
首次运行时,要逐份检查产出:是否遵循步骤,有没有编造缺失事实,是否越过停止条件。结果反复需要大改,就收紧指令,补充好例子和坏例子,不要急着扩范围。
原文没有规定监督多少次才算可靠,也没有给出通过率标准。「信任来自反复出现的证据」是方法原则,具体门槛仍需团队自己确定。
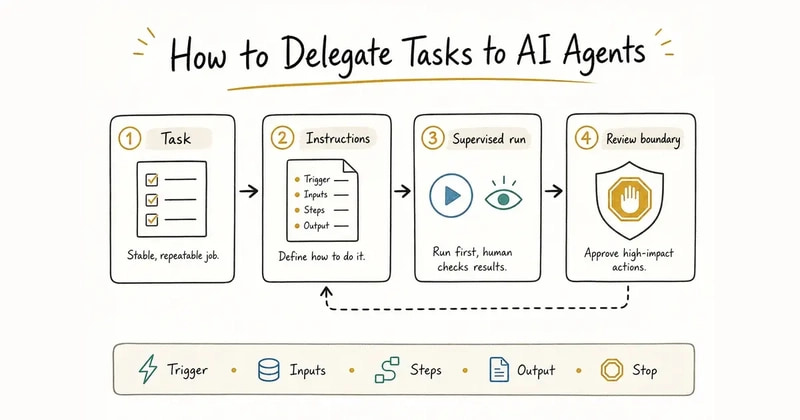
这张图是概念流程,并非产品截图。它表达的关键顺序是:先定义任务与指令,监督执行,再检查输出和审核边界。
跨天任务靠交接包延续,权限靠明确边界约束
对于持续多天的开发,作者反对把一周工作塞进一个宽泛提示词。更稳妥的做法,是把任务切成能逐段验收的小块,为当天这一块写完成定义。
每天结束时,留下分支或提交、已作出的决策、运行过的检查,以及尚未解决的问题。第二天从这个交接包继续,而不是指望对话记忆自动补齐状态。
这些信息各有用途:分支或提交定位代码,决策解释取舍,检查记录提供验证依据,未决问题标出下一步。单独一句「今天已经完成大部分」无法支持继续工作。
跨天执行也不能冲淡权限边界。作者区分了三个概念:
| 概念 | 要回答的问题 |
|---|---|
| 寻址(Addressing) | 谁可以向 Agent 发起请求? |
| 权限(Authority) | Agent 可以使用哪些工具和凭据? |
| 审批(Approval) | 哪些动作执行前必须由人确认? |
同事在共享房间里 @ 一个 Agent,可以是在请求它工作,并不因此获得所有者的本地密钥,也不应让 Agent 的工具权限自动扩大。请求来自谁,与工具能做什么,需要分别管理。
作者主张,改变生产行为的合并、发布说明和公开变更日志、对客户作出的时间或价格承诺,以及付款、法律措辞、安全披露等事项,都保留人工审批。Agent 可以准备草稿、收集证据、整理待决问题,最后一步单独处理。
对于会发送、发布或修改重要系统的任务,原文建议从只读或仅生成草稿的模式开始。任务稳定之后需要多个角色,再考虑 AI orchestration 或完整的 Agent 团队。
我的判断
这套方法最有价值的地方,是把 AI 编程中的失败拆成可以检查的交接问题。输出不稳定,就检查示例和质量标准;频繁卡住,就检查例外是否太多;总在猜测,就检查停止条件是否明确。它比笼统地说「模型不行」更方便定位原因。
但这篇属于经验性指南。作者没有展示真实项目的运行记录,也没有给出返工率、节省时间或不同指令方案的对照数据。不能据此认定,写好五项信息就一定能稳定交付。
「先挑稳定任务」也有前提:团队得有人知道正确流程是什么。历史项目里的 Bug 可能缺复现环境、测试和行为约定。把这些缺口列进交接单很有帮助,却不会自动消除缺口。
与普通聊天式提问相比,这套方法适合需要读取文件、调用工具、保留状态并持续推进的工作。如果只是解释一段代码或润色几句话,没有必要每次都填写完整模板。与多 Agent 分工相比,先跑通单个任务也更容易判断失败发生在哪一步。
原文最后提到 Alook 工作区能组织角色、消息线程和上下文,但没有提供比较证据。应把产品介绍和前面的任务组织方法分别看待;这套方法并不要求采用某个平台。
能拿来做什么
- 下次让 AI 修前端 Bug 时,补上复现步骤、预期行为和允许修改的范围,并要求它说明复现是否成功、运行了哪些测试、跳过了哪些测试;预期行为不明确时先停下来。
- 给 Node CLI 或公共 API 更新文档时,把任务限定为列出受影响页面并起草补丁,同时提供允许参考的文件,避免 Agent 仅凭猜测补写行为说明。
- 对跨天开发保留一份交接记录,写明分支或提交、关键决策、检查结果和未决问题;下一次执行从这份记录恢复任务。
- 从发布说明草稿等重复工作开始试运行,逐次审核是否遗漏事实或越过边界;产出持续需要重写时,先修改任务范围和指令。