
8.0
热点
AI SCORE
技术实践2026-08-20 18:24
Amazon Bedrock AgentCore实现多Agent共享客户记忆
n8n Blog#AWS#Agent#多Agent架构
Editor brief · 编辑速览
通过单个AgentCore支撑多个专业Agent(数值计算、AWS指导、调查)协同工作,且每个客户会话共享同一记忆,避免重复提问。
客户发消息给你的客服机器人,说他们的夜间同步自更换 API 密钥后就一直失败。分诊 agent 读取消息后判断这是配置问题,于是转交给集成专家处理。专家问他们指的是哪个集成。
但客户已经说过了。就在这条消息里,四十秒前发的,就在这个对话里——而专家还在看的那条对话。站在客户角度,这是和同一家公司的同一场对话。但站在工作流角度,这是两个 agent,第二个 agent 一无所获。你可以把所有对话记录传给每个专家——在对话长度超出上下文窗口之前这招管用。你可以把历史存入向量数据库——这也管用,但你现在要运维一个数据库和一套 embedding 流水线。本文走第三条路。
Amazon Bedrock AgentCore 是一个平台,用于大规模构建、连接和优化 agent,支持任意框架或模型。AgentCore Harness现已正式发布,它为模型提供了托管能力的脚手架:你通过配置定义一个 agent,包括它使用的模型、调用的工具、拥有的技能以及遵循的指令,然后 AgentCore 为你组装并运行循环。正是这个能力的两个特性使得专家团队变得切实可行。
AgentCore 的托管内存按 actor 和 session 划分作用域。因此,用标识客户而非任何单一 agent 的 Actor ID,可以让每个专家读到和写入相同的历史记录,且该历史记录的生命周期长于单个工作流的执行。另外,由于工具、技能、模型和指令随每次调用携带而非绑定在已部署的 agent 上,一个 agent 可以服务于全部四个专家,而无需为四个专家各配一个。
本文中,你将在 n8n 编辑器中构建这个支持团队:一个分诊 agent 对每个入站问题进行分类并路由给三个专家之一——一个持有 AgentCore Code Interpreter 用于计算,一个持有 AWS 技能目录用于架构指导,一个处理其他所有问题。回答第三个问题的专家已经知道第一个专家学到的东西,无需运维向量存储,也无需部署任何基础设施。
Step 1: Connect your credentials
Step 2: See how one harness serves four agents
Step 3: The customer asks about their bill
Step 4: The same customer asks what to do about it
Where to go from here
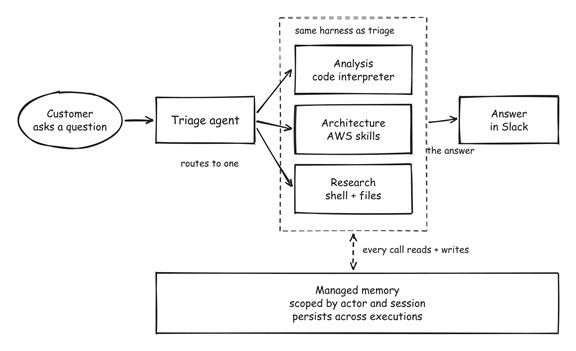
Figure 1: Triage picks one specialist per question. All four agents run on the same harness and read and write one memory of the customer.
客户在 When Chat Message Received 中提出问题。Set Customer Context 将聊天会话转换为客户标识符,然后每个 agent 都将其作为 Actor ID 和 Session ID 发送出去。Triage Agent 读取问题并以 JSON 形式返回分类,Read Triage Decision 解析该分类。Route To Specialist 将问题发送给匹配的 agent,该 agent 使用该次调用授予的工具来回答。Format Reply 解开答案,Post Answer To Slack 将其发布出去,并标注产生该答案的专家。
由于每次调用都携带相同的 Actor ID,每个专家都读写相同的历史记录,第二个问题因此受益于第一个问题。客户对使用量数据有异议,分析专家据此计算出了数据。他们随后追问如何重构,不同的专家直接使用这些数据作答,而无需客户再次告知。
这一切在哪里运行与它做什么同样重要,因为这决定了你需要运维什么。
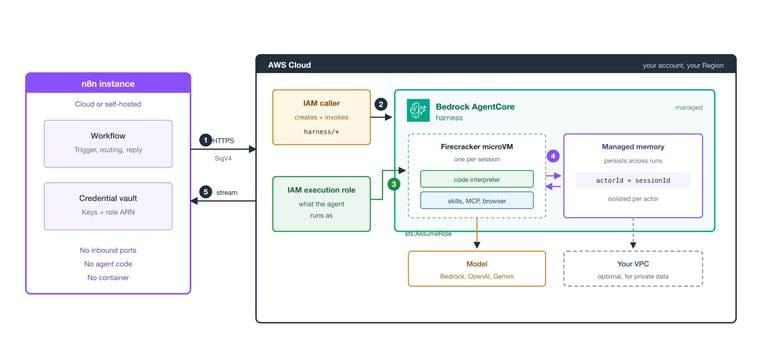
Figure 2: Your n8n instance holds the workflow and the credentials. AgentCore runs the agent in your AWS account, under the execution role rather than the caller's keys.
职责划分很清晰。n8n 负责触发、路由决策和回复。AgentCore 负责 agent 循环和超过工作流运行生命周期的内存,且每个 session 都在独立的 Firecracker 微 VM 中运行,无共享状态也无共享文件系统。画布上十个节点,两个凭证,一个 harness 资源——而不是四个。流量全部为出站,所以你这边无需暴露任何东西到互联网:n8n 用 SigV4 签名每个请求并调用 AWS。两个 IAM 身份做不同的工作,下一节将介绍如何配置。
一个 n8n 实例。自托管或 n8n Cloud 均可与此节点配合使用。
节点已安装。@aws/n8n-nodes-agentcore 是一个经验证的社区节点,你可以在节点面板中找到它。添加一个节点,搜索 Amazon Bedrock AgentCore,然后选中它。你也可以通过设置 > 社区节点 > 安装,输入 @aws/n8n-nodes-agentcore 来安装。
一个 AWS 账户,且在支持的 AWS 区域中可访问 AgentCore Harness。
在 Amazon Bedrock 控制台中启用基础模型。模型访问是按账户和按区域 opt-in 的,所以在首次运行前启用你计划使用的 Claude 模型。
两个 AWS IAM 身份,下一节将详细介绍。
用于回复的 Slack 凭证。如果你想直接在 n8n 中查看答案,可以删除该节点。
两个 IAM 身份
AgentCore Harness 使用两个独立的 IAM 主体,知道哪个是哪个可以省掉大部分首次运行的调试工作。调用者(caller)是其访问密钥写入 n8n 凭证的身份,它创建并调用 harness。执行角色(execution role)是 agent 在运行时作为哪个身份运行,因此它需要模型、代码解释器、技能目录和内存的权限。
AgentCore Harness 安全指南包含两个身份的标准策略,其示例执行角色策略已涵盖此工作流用到的所有内容。节点仓库在 docs/iam-trust-policy.json 中提供了信任策略,README 则将每个功能映射到它需要的策略块。首次运行时出现 AccessDenied,几乎总是执行角色上缺少某个 action,而不是调用者上。
尽可能使用来自 AWS IAM Identity Center 或 AWS STS 的临时凭证。
关于成本的说明:Harness 本身不单独收费。你只需为使用的底层 AgentCore 能力付费,托管内存按标准 AgentCore Memory 费用收取,涵盖短期事件、存储的长期记忆记录和检索请求。此工作流为所有四个 agent 创建一个 harness,而不是每个各创建一个。用完后删除 agent,详见 Amazon Bedrock AgentCore 定价。
导入免费模板到你的 n8n 实例中,边看边跟进。画布加载后将包含全部十个节点,已连线且已配置。
Step 1: Connect your credentials
打开四个 agent 节点中的每一个,选择你的 Amazon Bedrock AgentCore API 凭证。
打开 Post Answer To Slack,选择你的 Slack 凭证。
在 Set Customer Context 中,将 slackChannel 设置为你的机器人已加入的频道。
没有 harness 需要部署,没有容器需要构建,没有 agent 代码需要编写,也没有向量存储需要配置。
运行前,检查画布上任意节点的警告标记。n8n 在运行任意节点前会验证每个节点,所以任何一个未设置的凭证都会导致工作流停止。
Step 2: See how one harness serves four agents
打开 Triage Agent。它的 Harness ARN 字段为空,这告诉节点在首次运行时创建 agent,之后复用。 在 Provisioning Options 下,托管内存已启用,采用语义总结、摘要和用户偏好策略。
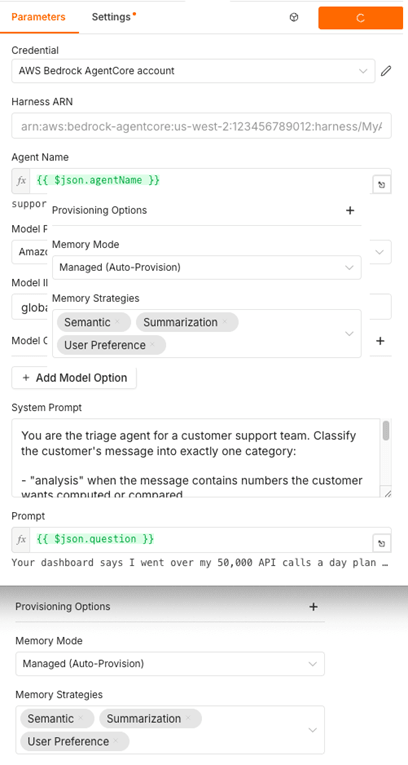
Figure 3: Only the Triage Agent provisions a harness. Memory is configured here because memory is a property of the harness rather than of an individual call.
现在打开 Analysis Specialist。它的 Harness ARN 是一个表达式:
{{ $json.harnessArn }}
这就是 Triage Agent 返回的 ARN。该专家调用同一个 harness 而不是创建自己的,并在单次调用中为自己授予 AgentCore Code Interpreter。Architecture Specialist 同样操作,授予的是 AWS 技能目录。
每次调用时授予工具也使每个专家的成本更低,因为工具定义会计入模型输入 token,即使 agent 从未调用该工具。而每个 session 都自带两个内置工具,无论你如何配置——一个 shell 和一个 file_operations,这也是为什么 Research Specialist 完全没有配置也能工作。
有一个细节需要注意:Set Customer Context 中的 Agent Name 是 harness 的缓存键,因此也是团队记忆的缓存键。修改它会创建一个新的 harness,之前积累的客户历史记录将无法从该工作流访问。
Step 3: The customer asks about their bill
打开画布底部的聊天面板,发送一条真实客户会发的消息——一条包含数字的消息:
Your dashboard says I went over my 50,000 API calls a day plan but my own logs for the five busiest days are 41200, 38900, 52300, 61800, 58400. Am I actually over on average?
首次运行需要两到三分钟,因为 AWS 要配置 agent。之后再运行只需几秒。
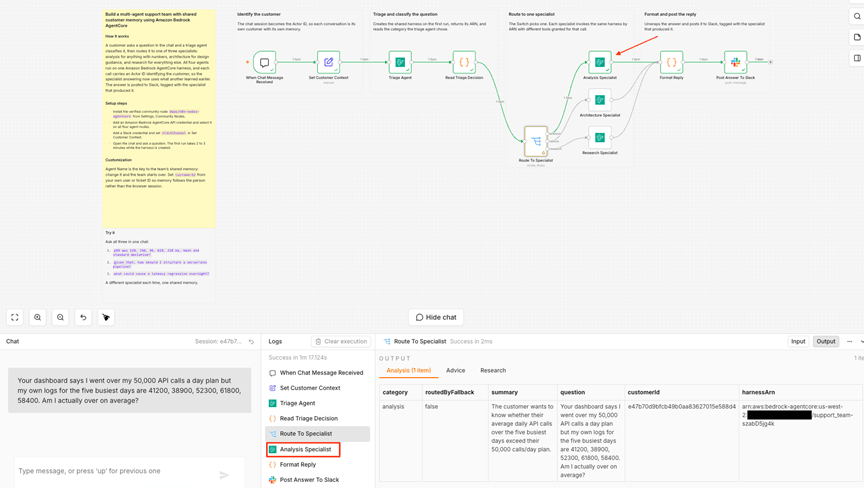
Figure 4: Triage classified this as analysis because answering it means computing something, and routed it to the specialist holding the code interpreter.
打开 Analysis Specialist 的输出,展开 toolUses。其中包含 agent 编写并执行的 Python 代码:
import statistics
calls = [41200, 38900, 52300, 61800, 58400]
print(statistics.mean(calls), statistics.pstdev(calls))
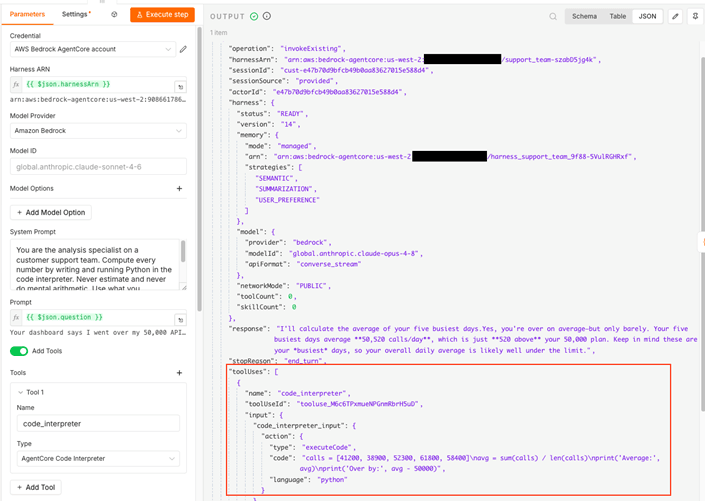
Figure 5: The AgentCore Code Interpreter runs Python in a sandbox, so the number in the answer is the output of an execution rather than a prediction of one.
平均值是 50,520。客户确实超标了,日均超出 520 次调用,基线是 50,000,比例是 1%。这里的答案是执行的结果,trace 准确显示了它是如何得出的。在一起计费争议中,这个差异就是整场对话的核心。
Step 4: The same customer asks what to do about it
留在同一聊天中,发送一条完全不包含数字的后续消息:
That is closer than I thought. How should I restructure things so I stop going over?
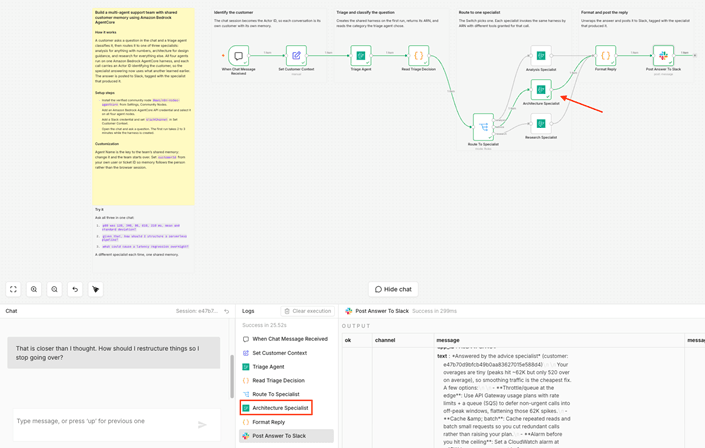
Figure 6: A different specialist answers, and it uses the call volumes from the first question.
分诊将其分类为架构指导,路由给了一个拥有不同工具的不同 agent:AWS 技能目录而非代码解释器。那个 agent 从未被告知客户的调用量,但它仍然使用了这些数据,因为两次调用都到达了同一个 harness 并携带了相同的 Actor ID。第一次对话被写入了该客户的内存,第二次调用从中读取。无需任何专家知道另一个专家的存在。
这是支持团队立刻能感受到价值的地方。没有共享内存的话,客户需要再次在同一个对话中粘贴那五个数字——给一家已经拥有这些数据的公司。
在面对真实客户之前,有一个作用域细节需要注意:内存事件按 Actor ID 加 Session ID 划分作用域,因此在同一个 harness 上使用不同的 Actor ID 将获得完全独立的内存。在此模板中,Actor ID 来自聊天会话;在生产环境中,你应该从你自己的用户、账户或工单 ID 中设置它。参见 Memory 了解保留策略以及如何调优检索。
现在发一条既不是计算问题也不是架构问题的问题:
Also, does the daily limit reset at midnight UTC or in my local time?
开放性问题路由到 Research Specialist,它使用每个 harness session 中都可用的 shell 和 file 工具工作。同一客户的三条消息,三个专家,一份不断积累的内存。站在客户角度,这是与同一家公司的单一对话。
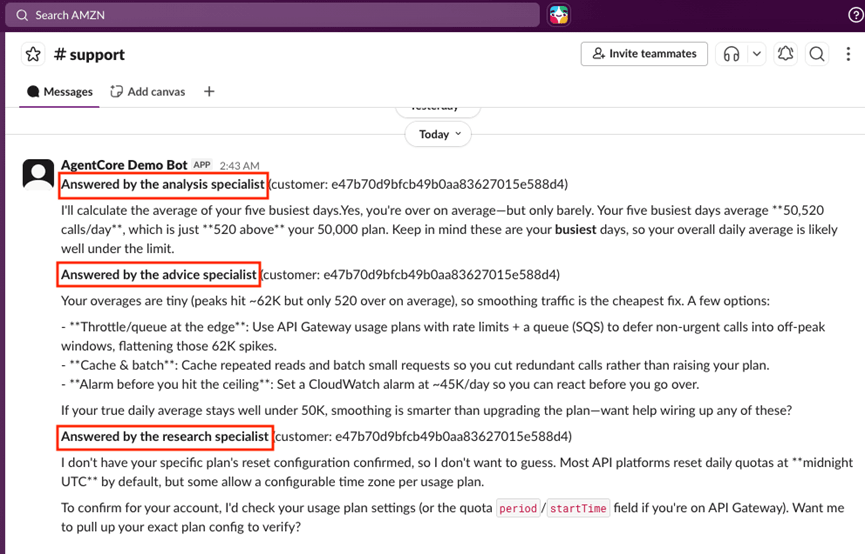
Figure 7: Each answer arrives in Slack tagged with the specialist that produced it.
Where to go from here
此模板是一个起点,每个方向的功能配置方式都与上述相同。
从你的客户已经在的地方触发它。聊天面板无需设置,这就是模板附带它的原因。Slack Trigger 或 Webhook 是自然的生产选择;两者都需要一个可从互联网访问的 n8n 实例。
使用你已经构建好的 agent。将专家的 Harness ARN 表达式替换为你通过 AgentCore CLI、控制台、CloudFormation 或 Terraform 创建的 harness ARN。节点直接调用它,配置字段成为每次调用的覆盖项。
添加一位专家。在 Switch 上再加一个分支,再加一个 agent 节点。给它一个远程 Model Context Protocol 服务器、一个用于对你自己的 API 进行受控访问的 AgentCore Gateway,或者 AgentCore Browser。
有关私有 VPC 网络、OAuth 认证调用、多提供商模型切换以及该节点支持的其他功能,请参阅 AWS Machine Learning Blog。
这个团队是你 AWS 账户中的一个 harness 资源,它配置了一个托管内存存储。用完后删除它以避免持续产生费用。
aws bedrock-agentcore-control list-harnesses --region us-west-2
然后删除此模板创建的那个,名为 support_team:
aws bedrock-agentcore-control delete-harness \
  --harness-id <harness-id> --region us-west-2
由于节点按 Agent Name 复用同一个 harness,无论你问了多少问题,测试此工作流都只会留下一个资源。
你构建了一支专家 agent 团队,每个客户共享一份记忆,无需向量存储、数据库或任何已部署的基础设施。三条理念使其成为可能:专家比通才做得更好,因为每个人都有适合其工作的工具;以客户为作用域的内存让团队能够在成员之间传递工作,而无需客户重复自己;每次调用时授予工具意味着专家团队无需成为一组独立资源 fleet 就能运作。
将此工作流导入你的 n8n 实例,所有节点已连线和配置。
有关该节点支持的其他功能(包括私有 VPC 网络和 OAuth 认证调用),请参阅 AWS Machine Learning Blog 上的 Run production AI agents in n8n with Amazon Bedrock AgentCore harness。了解更多底层能力,请参阅 AgentCore 文档。
此节点在 MIT 许可证下开源。AgentCore Harness 本身由 Strands Agents 驱动,这是来自 AWS 的开源 agent 框架。欢迎在 GitHub 仓库上提交贡献和反馈。
n8n 用户来自各种各样的背景、经验水平和兴趣领域。我们一直在寻找在博客文章中突出不同用户及其项目的机会。如果你正在使用 n8n 并希望启发社区,请联系我们 💌