让智能体造游戏,再用机器人验证玩法
一次 Godot 游戏实验中,智能体完成开发后编写机器人试玩,并根据结果调整游戏。第二轮提示继续检查关卡可解性、策略收益和结局可见性,作者提供提示词、源码及检查记录,同时明确这只是单次案例。
AI 深度解读
AI 写出一个能运行的游戏,还不足以证明它理解了游戏设计。这次实验更有价值的地方,是让 agent 写机器人反复试玩、根据结果调整规则,再回头检查:验收指标通过了,是否仍然藏着必输的关卡、失效的策略和看不见的结局?
作者用两轮提示完成了这个过程,中间没有人工修改游戏代码。结果支持了一套可借鉴的工作方法,也暴露了它的边界:自动测试能检验明确写下的要求,却不会自动补齐要求里遗漏的问题。
游戏平衡怎么从「感觉不错」变成可测的规则
实验中的 Kêr-Is 取材于布列塔尼的 Ys 传说。玩家要让一座低于海平面的城市撑过 12 次潮汐:工人采石、种粮、维修堤坝,金币用于雇人,打开海门可以赚钱,也可能放海水进城。天气预报会出错,陌生人提供的资源则附带延迟生效的损害。
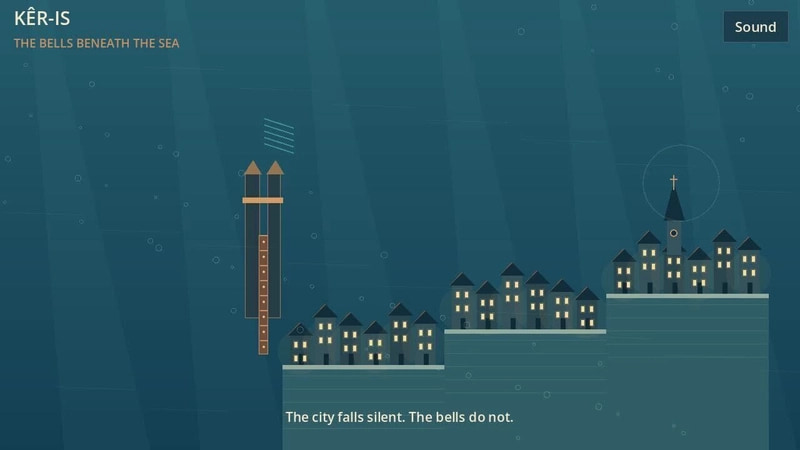
提示词并非只有「做个游戏」。它要求用代码生成美术和声音,不下载素材;游戏规则必须与渲染分离,让机器人能在无界面模式(headless)下运行。agent 还要选择平衡参数、录制视频,并导出网页版本。
规则与画面分离,是后续验证能够成立的基础。不必启动完整界面,也能批量计算不同策略会把城市带向什么结局。
测试安排了几类玩家:Greedy 一直开门、接受所有交易;Fixed 始终采用固定的工人分配和海门策略,穷举全部 110 种组合;Steward 只根据玩家能看到的信息决策;Seer 则知道未来事件。
它们在 200 个随机种子上运行。验收要求包括闲置时应较早失败、贪心策略很少获胜、固定策略表现较差,以及 Steward 的胜率处于指定区间。取消维修或永久关门,还必须明显削弱 Steward。
这些要求检验的是规则有没有发挥作用。例如,取消维修后仍然轻松获胜,维修系统就可能只是摆设。执行记录确实发现过贸易没有必要、城区被淹反而更容易防守等问题,agent 据此修改并重跑测试。
七项验收通过,为什么还要再做一轮
第一轮通过了全部 7 项原始目标,但复查发现了三处缺口。
首先,机器人没赢,不代表关卡无解。200 个种子里,有 24 个没有任何受测策略获胜,Seer 的总胜率为 87%。可能是种子无法通关,也可能只是机器人不够聪明。
第二轮里,agent 编写了利用完整未来信息的搜索程序,为全部 200 个种子找到了获胜方案,并通过游戏规则逐一回放。公开对比显示,平衡参数没有变化,所有固定策略在两轮中的结果也完全一致。
提高解题能力,与降低题目难度,是两件需要分开验证的事。
不过,这个搜索器已经超出了最初「像 Steward 一样行动,但知道未来」的设定。它证明这些种子存在胜利路径,无法证明普通玩家能发现路径。最终结果还报告,有 58 个种子只有 Seer 获胜。
第二处问题是交易策略。第一轮中,始终接受交易的胜率为 55%,Steward 挑选交易的胜率却只有 44.5%。原要求只规定交易既能救场,也能毁掉一局;即使满足这一点,无脑接受仍可能更划算。
第二轮补充要求:选择性接受必须同时胜过全部接受和全部拒绝。agent 为陌生人加入温暖、迟疑、空洞三种可见的声音线索,提示礼物背后的损害。Steward 利用这些信息后,胜率升至 60%,超过全部接受的 55%。
代价是线索可能太好猜。在后续未见种子测试中,空洞声音几乎总是对应严重损害,迟疑声音保留了更多不确定性。选择终于有收益了,但是否有足够的博弈空间,还得另看。
第三处问题完全不在胜率里:结果弹窗挡住了沉没的城市,终局画面也太暗。第二轮隐藏了沉没过程中的规划面板,保持城市照明,并让钟声响满 8 秒后再显示结果。
测试知道玩家输了,却不知道玩家有没有看见失败的演出。
谁来检查 agent 生成的证据
作者保留了一次提示词失误:初稿写过 Seer 达到 95% 的目标,实际发送版本没有。第二轮却依据初稿指责首轮漏做要求。
agent 的目标审计正确识别出这是新增要求,最终报告仍然接受了责备。因此,准确表述应是首轮通过 7 项原目标,第二轮新增 3 项目标,不能倒过来判首轮失败。审查 AI 输出时,需求记录也需要一起核对。
另外,游戏和机器人都由同一个 agent 编写。双方结果一致有参考价值,却可能共享同一处理解偏差。
作者因此把后加检查与 agent 交付物分开:agent 提供源码、机器人数据、尝试日志和媒体;作者另加 Python 脚本重算结果、比较两轮产物,并增加 2,000 个未见种子的测试,检查在原来 200 个种子上调过的策略是否仍有效。
作者称策略优势在新增样本上保持,但所给原文没有列出具体输出,无法据此补出胜率或优势幅度。它也没有提供真人试玩结果。
运行环境同样需要准确归因。实验使用 Spore 1.57.0、Godot 4.7.2,以及通过 ChatGPT 套餐使用的 gpt-6.1-sol。首轮约半小时,第二轮约 45 分钟。没有按量计费的 API 成本,不等于模型访问和执行没有成本。
Spore 提供工作区、工具执行和跨轮保留程序与结果的环境;Godot 在沙箱内通过命令行运行,不需要外部应用桥接。游戏逻辑由模型生成,Spore 没有提供 Godot 专用插件。实验也没有分离测量模型和运行时各自贡献了多少。
我的判断
这篇最有价值的是把「做出来」和「验证做对了」接在一起,并展示验收之后还能怎样追问。几类不同策略,比单张截图更能揭示规则是否有效;补充未见种子,也比只反复优化原有样本更有说服力。
但它仍是一条公开记录的成功案例。作者也是 Spore 的作者,实验没有比较其他运行时、普通编码助手或人工开发流程,不能据此认定持久化 agent 更快、更便宜或成功率更高。
与人工试玩相比,机器人适合批量验证明确规则,人工更适合发现信息难懂、反馈不清、演出被遮挡等体验问题。两种检查覆盖的盲区不同。把交易胜率从 44.5% 调到 60%,能证明指定机器人在这些条件下更有效,不能直接证明选择过程更有趣。
自动验收的价值,取决于它覆盖了什么,也取决于有人继续检查它遗漏了什么。
能拿来做什么
- 给日常 AI 编程任务补上行为验收。例如实现一个带策略判断的功能时,先说明正常输入、边界输入和简单投机做法应得到什么结果,再让 agent 编写可重复运行的检查程序。
- 开发前端交互或小游戏时,把核心规则从界面中拆出来,用无界面测试检查逻辑,再单独检查遮挡、亮度、反馈时机和最终状态是否可见。
- 让 agent 调整规则或参数时,保留一批未参与调试的输入,并比较修改前后的固定策略结果,避免只在熟悉样本上得到漂亮数字。
- 审核 agent 报告时,同时核对实际发送的需求、生成的证据和额外验证结果。对方接受了批评,也不代表批评依据正确。