从文档到回答:搭建基础 RAG 流程
介绍文档摄取、分块、向量化、检索与生成的 RAG 流程,并给出分块长度和重叠比例建议。强调保留来源与权限元数据,通过更新索引维护知识时效性。
AI 深度解读
给模型接上内部文档,并不等于它就能可靠回答业务问题。RAG(检索增强生成)的做法,是先从自己的资料里找出相关片段,再让模型据此作答。原文用 Azure AI Search 和 Azure OpenAI 串起了这条流水线,也给出了切分、检索和评估的基本方法。
最值得带走的结论是:RAG 的质量不能只靠生成模型兜底。文档有没有切完整、正确片段有没有被找到、索引有没有过期,都会影响答案。它是一套需要逐环节验证的工程流程。
先找资料再回答,数据才能独立更新
原文把 RAG 分成两部分:入库时处理文档,提问时检索并生成。
入库可以从 PDF、网页、Wiki 或数据库行开始。提取干净文本后,还要保留标题、URL、日期和权限等元数据。文本负责回答问题,元数据负责解释来源、判断时效和控制访问范围。
随后将文档切成片段,通过 embedding 模型转成向量。向量可以理解成文本语义的数字表示,含义接近的内容通常距离也近。片段正文、向量和元数据一起存入 Azure AI Search、Pinecone、pgvector 或 Qdrant。
用户提问后,系统也把问题转成向量,找到相关片段,再将片段与问题一并交给模型。
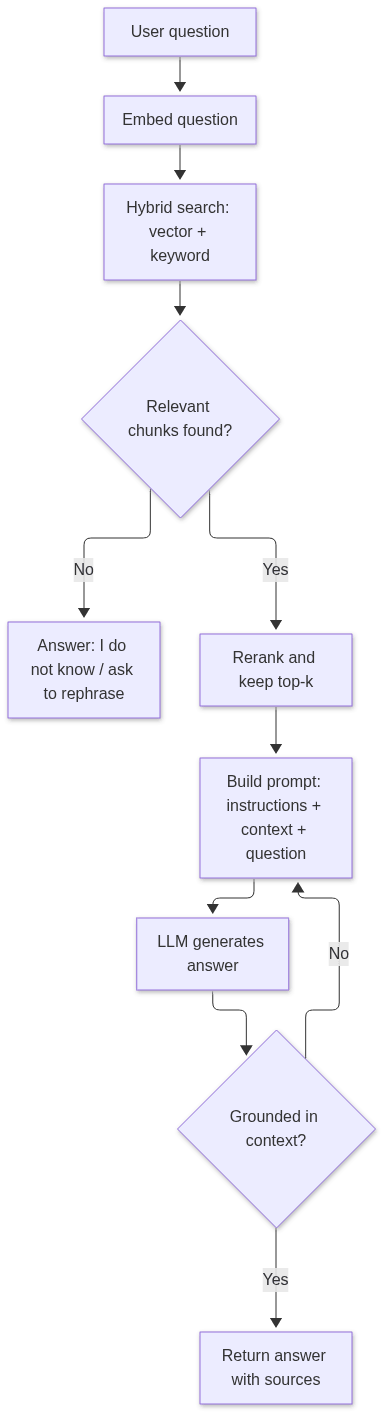
这样,更新业务知识主要靠更新索引,不必为每次政策调整重新训练模型。来源信息也能进入回答,方便用户核查。
但这些能力都有实现前提。**RAG 提供了让回答依据资料生成的路径,可靠性仍要靠检索、提示和评估共同保证。**尤其是权限,必须在检索阶段按用户访问范围过滤;等回答生成后再过滤,受限资料已经进入模型上下文。
切分建议和示例代码,其实不是同一套标准
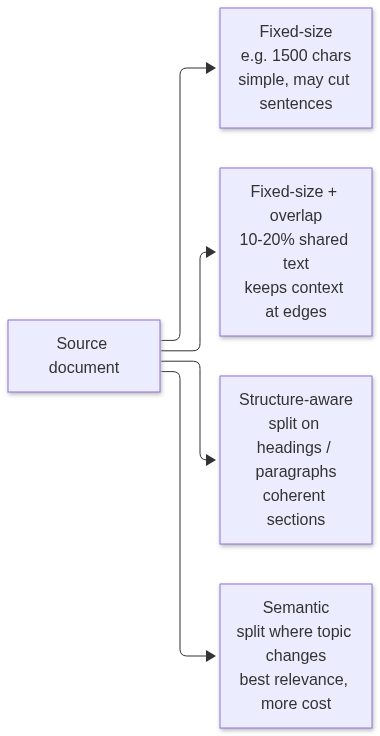
作者建议每段约 300 到 800 tokens,重叠约 10% 到 20%,优先沿标题、段落边界切分。片段太短会丢掉条件与解释,太长又容易混入无关内容。
示例先通过 pip install azure-search-documents openai 安装依赖。索引名为 docs,字段包含 id、content、source、vector;vector_search_dimensions=1536,用 HnswAlgorithmConfiguration 配置 HNSW,并通过 VectorSearchProfile 关联名为 default 的配置。
下面这段负责切分、生成向量并上传,需要前面已经建立索引,并准备好 endpoint、INDEX 和 cred:
from openai import AzureOpenAI

aoai = AzureOpenAI(
    azure_endpoint=os.environ["AOAI_ENDPOINT"],
    api_key=os.environ["AOAI_KEY"],
    api_version="2024-06-01",
)

def chunk(text, size=1500, overlap=200):
    step = size - overlap
    return [text[i:i + size] for i in range(0, len(text), step)]

def embed(texts):
    resp = aoai.embeddings.create(model="text-embedding-3-small", input=texts)
    return [d.embedding for d in resp.data]

search = SearchClient(endpoint, INDEX, cred)

def ingest(doc_id, text, source):
    pieces = chunk(text)
    vectors = embed(pieces)
    search.upload_documents([
        {"id": f"{doc_id}-{i}", "content": p, "source": source, "vector": v}
        for i, (p, v) in enumerate(zip(pieces, vectors))
    ])
要看清 text[i:i + size] 这一行:这里按字符切分,size=1500、overlap=200,既没有计算 token,也没有识别段落。它演示了流程,并未落实前面的结构切分建议,处理中文文档时尤其不能把字符数直接当作 token 数。
配置也要前后一致。示例使用 text-embedding-3-small,索引维度设为 1536;查询与文档必须使用同一个 embedding 模型,切换模型后需要重新生成全部文档向量。连接配置包括 SEARCH_ENDPOINT、SEARCH_KEY、AOAI_ENDPOINT、AOAI_KEY,原文使用的 API 版本是 2024-06-01,并未说明 SDK 版本。
混合检索负责找对,生成约束负责少猜
只做向量检索,适合找语义接近的表达,却可能漏掉产品代码、专有名称等精确词。作者因此建议混合检索(hybrid search),同时使用向量和关键词,并进一步配合重排器(reranker)调整候选顺序。
下面这段把混合检索结果放进提示,再要求模型按来源回答:
from azure.search.documents.models import VectorizedQuery

def answer(question, k=5):
    qvec = embed([question])[0]
    results = search.search(
        search_text=question,  # 混合检索中的关键词部分
        vector_queries=[VectorizedQuery(vector=qvec, k_nearest_neighbors=k, fields="vector")],
        top=k,
    )
    context = "\n\n".join(f"[{r['source']}] {r['content']}" for r in results)

    messages = [
        {"role": "system", "content":
            "Answer using only the context. Cite sources in [brackets]. "
            "If the context does not contain the answer, say you don't know."},
        {"role": "user", "content": f"Context:\n{context}\n\nQuestion: {question}"},
    ]
    resp = aoai.chat.completions.create(model="gpt-4o-mini", messages=messages, temperature=0)
    return resp.choices[0].message.content

print(answer("What is our refund policy for annual plans?"))
关键在 search_text=question 与 vector_queries 同时出现。默认 k=5,用于向量近邻数量和最终返回数量;生成模型是 gpt-4o-mini,temperature=0。示例没有接入重排器,不能把正文建议当作已经实现的功能。
系统提示要求只依据上下文、用方括号引用来源、资料不足时回答不知道。这是必要约束,但不能当作正确性证明。增加片段数量也未必改善结果,无关内容会消耗 token,并干扰回答。
原文说改用 Pinecone 主要涉及存储和检索调用:写入使用 index.upsert(vectors=[...]),查询使用 index.query(vector=qvec, top_k=k, include_metadata=True)。不过,这段查询只展示了向量检索,不能据此认为 Azure 示例中的混合检索行为也会自动保留。
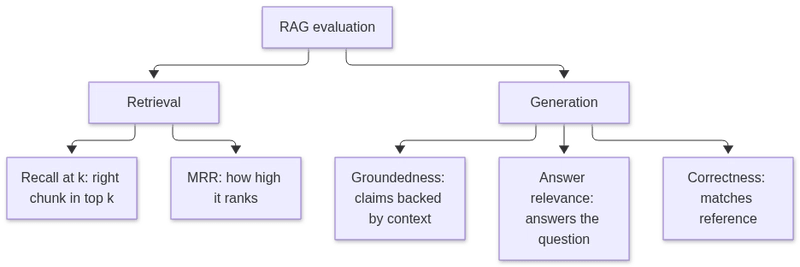
定位问题时,作者建议把检索和生成分开测。检索看 recall@k,即正确片段是否进入前 k 个结果;再看 MRR,衡量正确结果排得有多靠前。
生成则分别检查 groundedness、answer relevance、correctness:陈述有没有资料支持、有没有回答问题、是否符合参考答案。Ragas 和 Azure AI Foundry evaluators 可以让 LLM 辅助评分,但仍要人工抽查。切分、embedding 或提示发生变化,都应重跑测试集。
我的判断
这篇适合作为 RAG 入门骨架,尤其是先建立测试集、再逐环节优化的思路。它能帮助团队分清「没找到资料」和「找到了却答错」两类问题,避免每次都去改提示。
但原文没有给出实际评测结果、成本、延迟,也没有展示作者团队的对照实验。「混合检索通常优于纯向量检索」在这里属于经验建议,收益仍需用自己的数据验证。
示例与生产系统还有距离:文字要求保留权限,索引代码却没有权限字段;文字提醒删除过期片段,入库函数却只有上传操作。文档变短后,旧片段如何清理,原文没有实现。
我的取舍是:先用这条流程验证问题是否适合通过文档检索解决。已有 PostgreSQL 的团队也可以把原文列出的 pgvector 纳入候选,再根据维护成本和检索效果选择存储方案。文章没有提供足够证据替任何一种数据库背书。
能拿来做什么
- 给内部组件文档或产品政策做问答时,先整理一组真实问题,并标出应该命中的片段。保留「资料里没有答案」的问题,用它检查系统是否会乱猜。
- 沿用 Python 示例,或用 Node 实现相同流程时,先验证切分结果是否保留完整条件、例外和解释,再调整片段长度。不要直接把 1500 字符当成通用标准。
- 在问答页面展示可核查的来源,并在服务端检索时加入权限过滤。定期重新入库,同时清理被删除文档对应的片段,避免旧内容继续参与回答。