用架构文档约束 AI 开发与交付
文章提出 AAT 实践,将架构决策、接口契约、行为定义和计划作为产品的统一依据。团队先更新文档,再由 AI Agent 实现,并将交付结果回写核对,配合仓库和测试维持一致性。
AI 深度解读
AI 能很快写出代码、文档和业务场景,但它未必知道:一段通过测试的实现,为什么仍然违背公司的业务承诺。Emanuele Pugliese 提出的 Architecture as Truth(AAT),就是把这些判断依据写进版本化文档,让人和 AI 按同一份约定工作。
这套方法值得看的地方,是它把「给 AI 补充上下文」变成了持续维护产品知识的流程。作者团队已经用它管理数十个仓库,也公开了一次真实失误:文档没有说清的细节,AI 还是擅自做了决定。
AI 接手产出后,谁来判断它做得对不对
原文用分析师 Marta 的故事说明问题:过去,一个普通功能的验收场景要写约两天;AI 根据半页笔记,不到一分钟就生成了 40 个场景,其中三个不符合公司的结算规则。企业客户退货只能获得贷项通知单,不能直接退款。Marta 凭六年的业务经验发现了问题,这条规则却没有出现在输入里。
这个故事用于解释观点,原文没有把它作为有实验设计的效率测量。作者自己的实践是:PuglieseWeb 在多个产品、超过 60 个仓库中使用 AI agents,大多数 pull request 由 agent 编写。
作者据此判断,人的工作正在转向三件事:理解整个产品、决定产品该往哪里走,以及识别「在这个系统里不对」的结果。
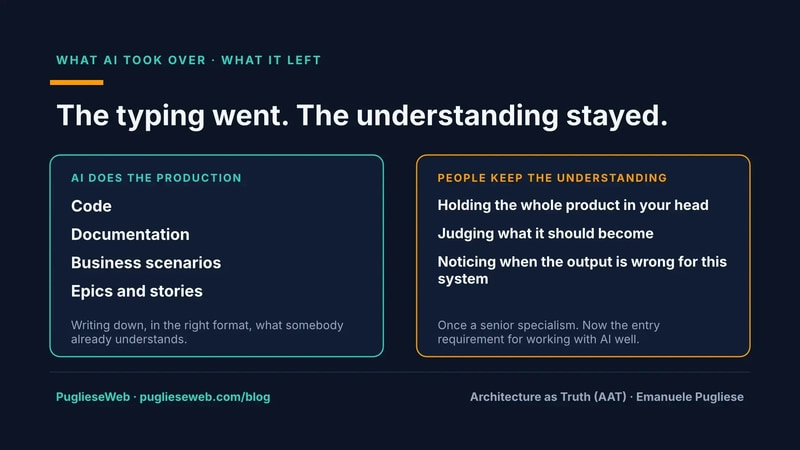
最后一件事尤其难。局部实现可以通过测试,却违反财务结算、历史合同或对客户作出的承诺。只给 AI 一张功能工单,这些约束就很容易消失。
生成速度越快,遗漏的业务前提越需要被明确记录。
不过,「所有人都要理解整个产品」是作者的主张。原文没有证明,每个岗位都需要掌握同样深度的全局知识。
AAT 要让文档拥有决定权
AAT 把架构文档设为产品的单一事实来源(single source of truth)。这里的「架构」包括决策、契约、行为和计划:为什么这样做、各部分如何配合、产品承诺什么,以及准备如何变化。
它的工作顺序是:人先修改并批准文档,AI 按批准内容实现,上线结果再与文档核对。
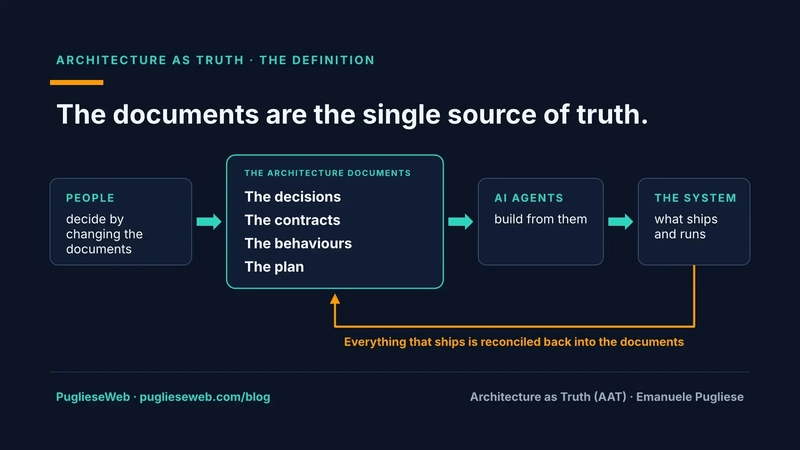
作者列出的五条原则,可以归为一条持续循环:
先把约定写进代码旁边的版本库,用全团队能读懂的语言表达。产品变化先改文档,再开始实现;人批准的文件,就是 agent 写代码时读取的文件,避免 wiki、私有提示词各存一套。交付时,用可执行场景和契约测试核对真实代码,并逐项记录相关文档已更新,或说明为什么无需更新。所有人都可以阅读和纠正。
运行中的系统是实际发生的事实,文档记录的是系统应该怎样、为什么这样。两者冲突时,要查清哪一边有问题,不能默认文档永远正确。
作者给出的规模数据是:决策库有 226 条决策记录,自 9 月 8 日以来有 2,975 条带日期的变更记录,每条都注明核对过哪些文档。其流程分四个阶段,包含两次人工批准。
这些数据说明他们确实在维护记录,尚不能证明流程降低了多少缺陷或审查成本。
AAT 与规格驱动开发最接近,但强调长期维护整个产品的约定。作者也承认 OpenSpec 等工具保留持续有效的规格。DDD 提供业务语言和建模方法,docs-as-code 解决文档如何存储与评审,architecture as code 则承载可自动检查的规则,AAT 可以组合使用它们。
真正难执行的是「不确定就停下来」
AAT 不要求购买产品。Git 仓库、纯文本文件、测试运行器和现有 AI agent 就能起步。作者建议将四条规则写进 AGENTS.md:
- 修改前,读取相关决策、契约和行为。
- 按批准内容实现,不能为通过测试而修改契约或场景。
- 约定错误或缺失时,提出修订,等待人决定。
- 交付时列出依据,并更新已经失效的文档。
作者认为,流水线目前可以拒绝擅改已批准文件的变更,也可以拒绝没有注明文档依据的变更;「先读再写」和「遇到空白就停」仍主要依靠 agent 遵守指令。
他们为跨仓库分发上下文开发了 SystemDox。它从团队自己的 Git 仓库读取文档,通过 MCP 向 agent 提供同样的文件;其工作区已有超过 5,700 份文档。原文称它处于 private preview,尚未公开。
下面这段调用解决的是:写提醒功能前,先发现已有的决策和接口约定。
get_context
  task_description: "add a text reminder that goes out 24 hours before a
    booking, with a reply of CANCEL cancelling the booking"

## Project Rules (18)
[...]

## Also Indexed (3)
- Reminders before the appointment, in Booking's settings
  [...]/features/appointment_reminders.feature
- ADR-214: Booking sends one or more reminders before an appointment [...]
- Booking API — reminders before an appointment (ADR-214)
  specs/changes/appointment-reminders/openapi.yaml
要留意 ADR-214 和 openapi.yaml:返回结果告诉 agent,提醒功能已经有约定,接下来应读取这些文件。仅仅检索到索引,还不能证明它正确遵守了约定。
真实失误发生在 10 月 30 日提出、10 月 31 日发布的预约提醒功能中。负责人批准了默认关闭、商家主动开启,以及只在早上 8 点到晚上 9 点发送等规则。
但文档只说提醒末尾附上商家的电话号码,没有指定哪个号码。agent 自行选择了商家接收预约通知的号码,小商家那里可能就是老板的私人手机。
测试全部通过,因为没有场景规定号码来源。agent 在记录中写出了选择,负责人当晚读到后才发现问题,随后修订决策、修改实现并批准重新发布。当时尚无客户收到提醒。
这次案例证明了记录有助于追查,也暴露出第三条规则没有被执行。文档能提供边界,无法自动消除猜测。
我的判断
我认可 AAT 对「业务理由」的重视。代码能告诉新人一个分支怎么运行,却很难解释这个分支背后的客户承诺。把理由、契约和场景一起维护,对频繁使用 AI 编程的团队有直接价值。
但作者没有提供采用前后的对照数据,也没有报告维护文档、等待批准和人工核对的成本。因此,它目前更适合被看作一套有实际运行记录的经验方法。
团队规模也有明确局限:上述案例的业务判断和批准实际由一位负责人完成。分析师、开发、测试分工阅读、由指定人员批准的十人团队流程,只是作者的预期,尚未验证。作者同时开发 SystemDox,并提供 AAT 落地服务,原文披露了这一商业利益。
相比在 AGENTS.md 填一份通用规范,AAT 多了产品级约定和交付核对;相比已经长期维护规格、ADR 和契约测试的团队,它的新意更多体现在统一这些材料的权威与流程。
我也不会直接照搬案例中的「没人需要读代码」。文档批准回答的是产品应该做什么,代码审查仍可能发现权限、并发、性能和依赖使用问题。原文没有证明前者能够覆盖后者。
能拿来做什么
- 从一个业务边界清楚的功能开始,把默认行为、例外规则和理由写进仓库。例如预约提醒,要明确开启条件、发送时段和号码来源,再让 AI 修改。
- 给前端与 Node 接口共用同一份契约和业务场景。页面交互与服务端实现都引用它,减少各自根据工单补全细节的机会。
- 在 AGENTS.md 中写入四条行为要求,并要求 AI 在变更说明里列出所依据的文档、待决定的问题和自行采用的假设,方便人集中检查。
- 保留现有测试和代码审查,在交付时增加一次文档核对。先观察一个功能的维护负担与收益,再决定是否扩展到多个仓库。