静默回退如何污染智能体实验结果
作者发现模型配额耗尽触发静默回退,导致记忆智能体实验数据受到污染;随后标注旧数据、更换模型并从头重跑。无回退的新实验中,两组平均 F1 接近,试验次数有限,且不能与旧模型结果直接比较。
AI 深度解读
给 AI Agent 接上记忆后,第三轮实验里的过拟合和报错次数降到了零,看起来像是记忆发挥了作用。但作者继续检查才发现:部分配置根本不是模型提出的,而是调用失败后随机生成的。
这篇记录最有价值的地方,是拆穿了一次看似漂亮的实验结论。它提醒做 AI 编程和 Agent 评测的程序员:先确认每条结果由谁产生,再讨论能力有没有提升。
看起来在比较记忆,实际混进了随机决策
作者开发的 Ninaivu 是一个机器学习实验笔记 Agent。它在 Kaggle 的 Telco Customer Churn 数据集上训练真实的 scikit-learn 模型,保存实验历史,再据此提出下一组配置。记忆层使用开源系统 Hindsight。
实验安排很明确:两个 Agent 使用相同的模型和提示词,每次试验分 3 个 session,每个 session 执行 10 次运行,session 之间清空上下文。只有记忆组能通过 Hindsight 找回此前的实验。
问题出在配置生成环节。语言模型调用连续失败两次后,程序会返回随机配置,并附带一个标记:
return random_config(), True
这里需要盯住的是 True:它表示本次配置来自降级路径。作者把它写进结果文件的 fallback 列,却最初只把它当作记账字段。
于是,同一组统计里混入了两种来源:模型根据实验信息提出的配置,以及调用失败后生成的随机配置。程序继续运行,比较条件却已经变了。
为什么增加试验次数,反而推翻了好结果
最初每组做了 3 次试验,记忆组在第 3 个 session 的「坏运行」降到零。这里的坏运行,是指过拟合或报错。
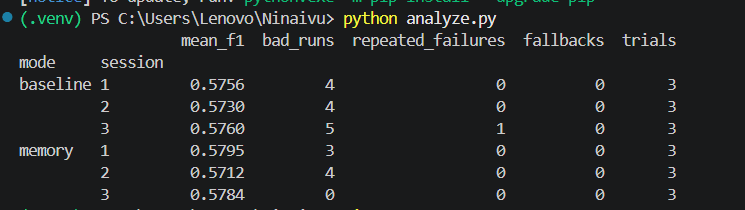
作者随后把每组试验增加到 6 次。此时每组每个 session 有 60 次运行,原先的优势没有站稳:第 3 个 session 的平均测试 F1,记忆组为 0.545,基线为 0.574。
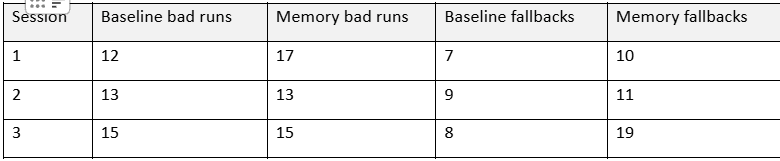
真正揭开问题的是 fallback 列。全部 360 次运行中,有 64 次使用了随机配置。仅记忆组第 3 个 session,就有 19/60 次,接近三分之一。
作者指出,随机生成的深树森林配置容易过拟合。因此,这些坏运行不能直接解释成「记忆让 Agent 学坏了」,因为其中不少配置根本没有经过模型决策。同样,早期的零坏运行也不能证明记忆有效。
增加样本量,无法自动修复数据来源混杂的问题。
修好调用链后,记忆还剩多少优势
最初的失败原因没有日志。作者补上异常输出后重跑,才看到 RateLimitError,错误码为 429:openai/gpt-oss-120b 的每日 token 配额(TPD)上限是 200000,已使用 199537,本次请求还需要 1093。
每次请求约消耗 1,100 tokens,数百次调用很容易耗尽免费额度。不过,作者没有旧运行的异常记录,因此只能说限流很可能是此前降级的原因,不能说已经证实。
他们随后调整了处理方式:遇到 RateLimitError 就终止运行;其他异常打印类型和信息,等待 2 秒。受污染的数据保留在仓库里,通过重命名和 README 标注问题。
模型也换成了拥有独立 token 配额的 openai/gpt-oss-20b。新实验从头执行,先检查 fallback,确认每行都是 0,再看效果。由于模型变了,新旧两批数字不能直接比较。
清理后的实验每组只有 2 次试验:
- 平均测试 F1,基线为 0.573,记忆组为 0.574。
- 第 2、3 个 session 合计,记忆组坏运行是 4/40,基线是 9/40。
- 第 1 个 session 两组都没有历史记忆,坏运行分别为 4 次和 5 次。
F1 几乎持平,后续 session 的坏运行出现了减少的迹象。但作者明确把它称为一种模式,而非已经成立的结果。少量试验还不足以支持更强的结论。
我的判断
我认同作者对降级路径的处理:无法恢复的基础设施故障,应当让实验停下来。随机配置适合用来测试流程是否能跑通;一旦混入能力评测,就必须单独识别,否则统计回答的问题会发生变化。
但这篇文章不能用来证明 Hindsight 提升了 Agent 能力。新实验规模小,F1 差异也很小,原文没有提供统计显著性分析。坏运行减少可以作为继续验证的线索。
还要区分实验和线上服务。线上为了保持可用性,可以重试或切换模型;评测里采用这些做法,则需要记录实际执行路径。相比「任何失败都立刻停」,按错误类型处理更灵活,但维护成本也更高。
这篇记录支持得最充分的结论,是静默降级会污染评测。关于记忆效果,目前仍是有限观察。
能拿来做什么
- 给日常 AI 编程或 Node Agent 的每次调用记录实际模型、失败原因、重试次数和
fallback。生成成功不等于预定模型完成了任务。 - 比较提示词或记忆方案时,先核对降级数量,再看成功率和质量指标。随机输出、备用模型输出应当能够单独筛选。
- 批量运行前,按单次 token 消耗估算总额度,并明确 429 的处理策略。对于无法恢复的配额耗尽,及时终止可以减少无效运行。
- 保留被排除的数据并标注原因。切换模型后重新建立比较,不把新旧结果拼成一条改善曲线。