八款 OCR 模型实测:成本下降靠什么
同一 GPU 上的 850 页历史文档测试显示,LightOnOCR-3-0.8B 每千页 GPU 成本低于 0.1 美元,任务调度和图像尺寸优化也能显著节省成本。部分模型存在空白页幻觉和重复输出,低成本仍需结合识别质量评估。
AI 深度解读
古籍数字化的文字识别费用,已经低到每 1000 页不到 0.1 美元,但这里计算的是 GPU 租赁费,不是一套数字化工程的全部开销。IT之家转述的一项测试显示,新模型降低了成本,任务调度、图像尺寸和运行环境的优化也同样重要。
对需要批量处理扫描件的程序员,这项测试值得关注的有两点:识别费用还能压到多低,以及低价输出离可交付的文本还有多远。
每千页不到 0.1 美元,是怎么算出来的
Hugging Face 的 Daniel van Strien 对比了 8 款图像文字识别模型,测试材料共 850 页,涵盖旧版自然历史书籍、1771 年版《大英百科全书》,以及打字和印刷的历史档案。
所有模型都运行在同一款 Nvidia RTX PRO 6000 上。这块 GPU 通过 Hugging Face 租用,每小时收费 2.75 美元,报道折算约为人民币 18.4 元。在租价固定时,完成同样页数所需的运行时间越短,GPU 费用就越低。
相同图像尺寸下,2025 年 4 月发布的 RolmOCR 每识别 1000 页约花费 0.51 美元,约合人民币 3.4 元;2026 年 10 月发布的 LightOnOCR-3-0.8B 则降到了不到 0.1 美元,约合人民币 0.67 元。
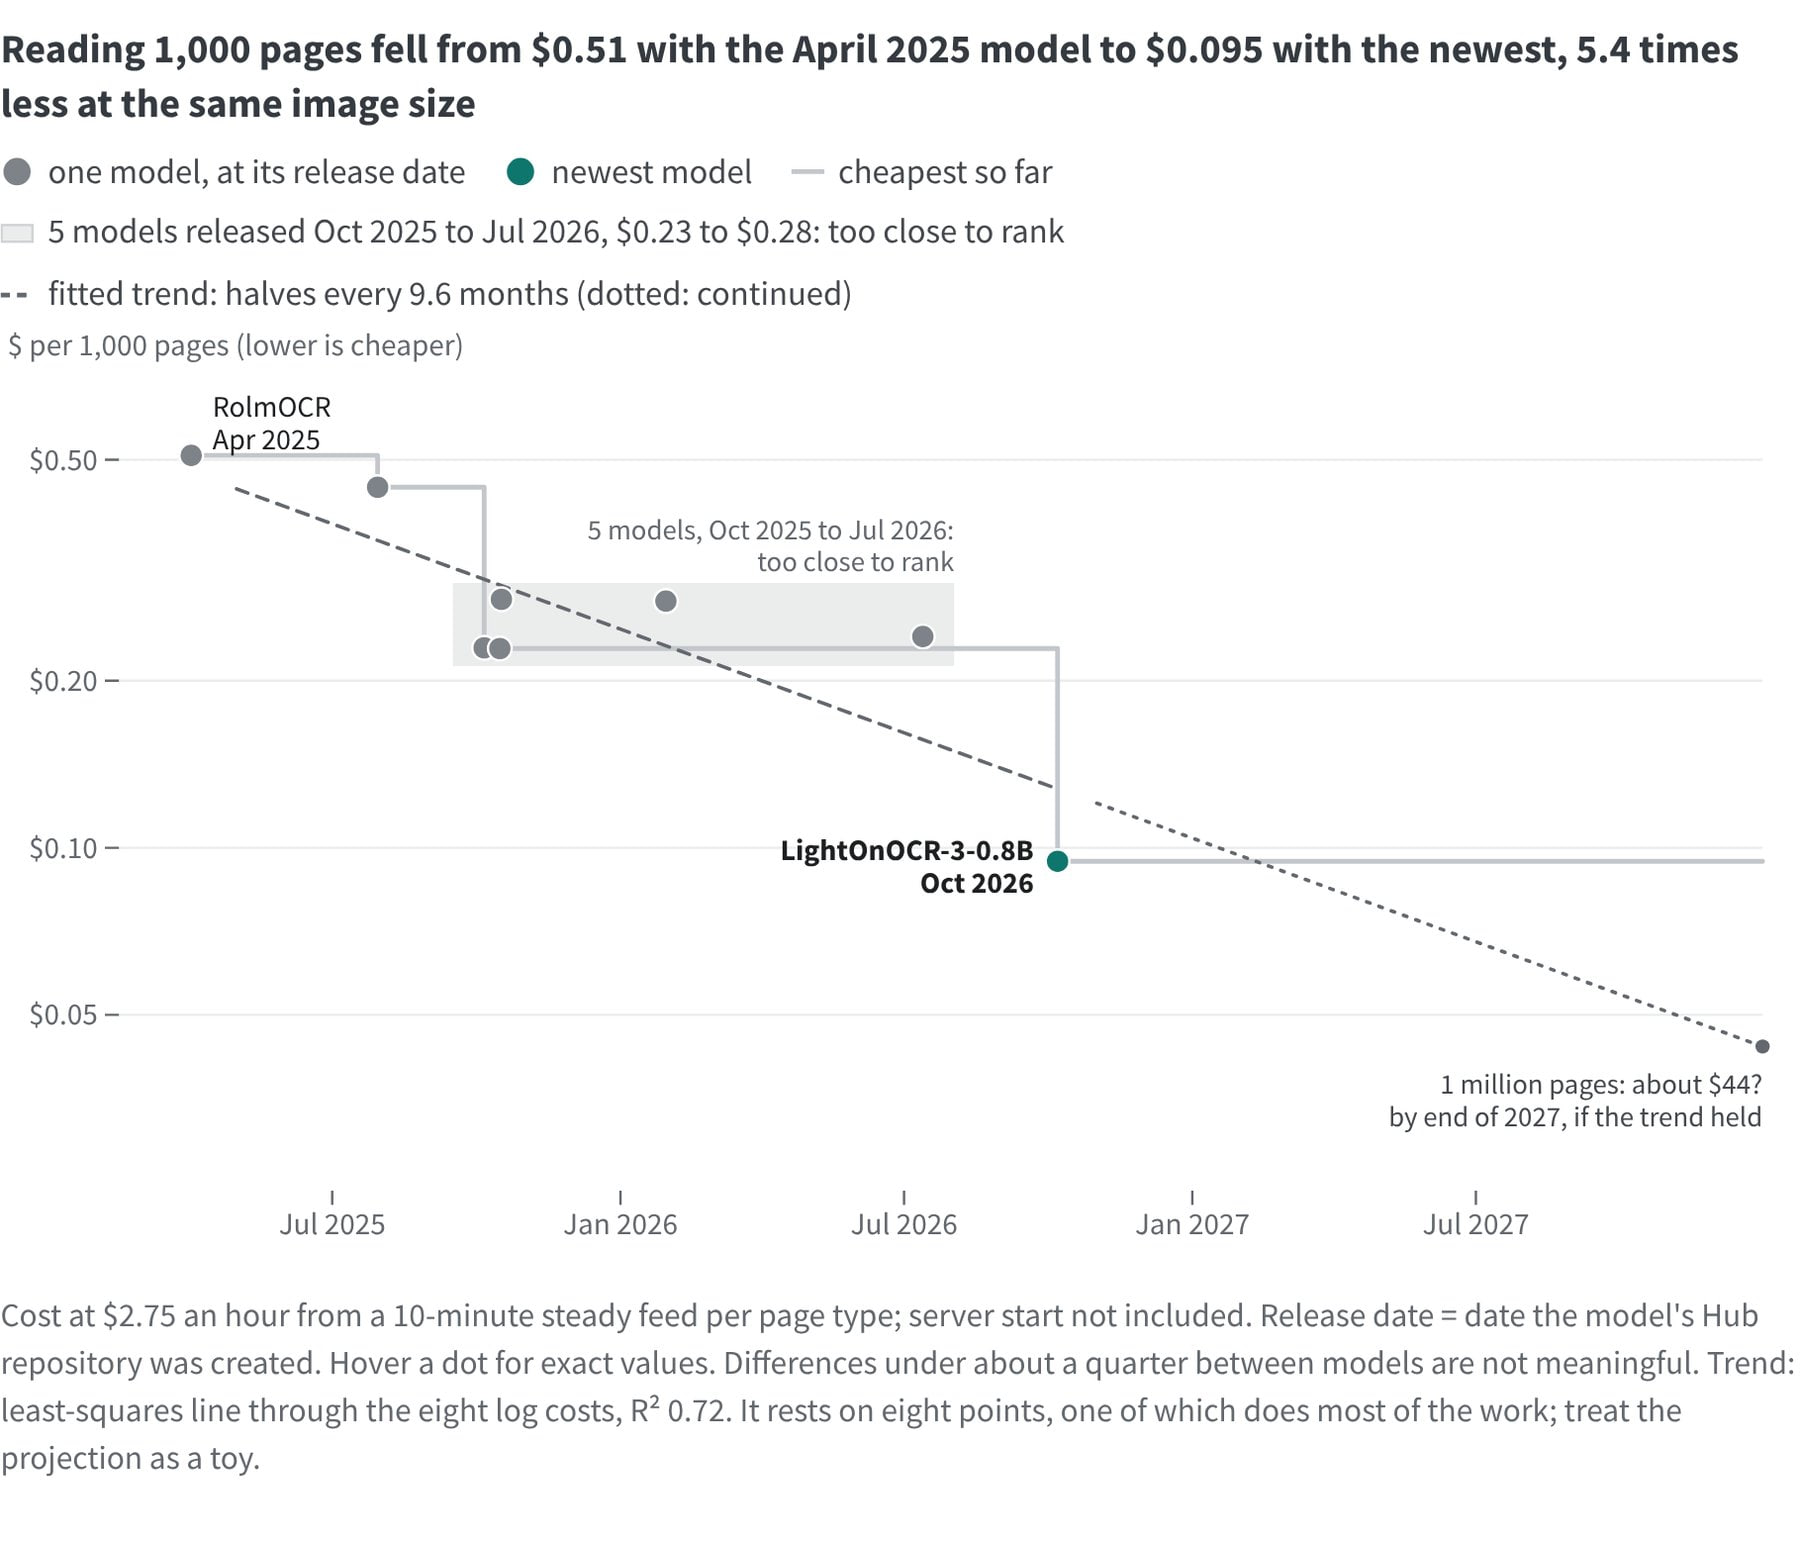
报道还给出了百万页规模的估算:GPU 租赁费约为 65 至 130 美元,约合人民币 434.3 至 868.5 元,具体取决于材料类型。
这里有两个口径要分清。实际测试材料是 850 页,百万页数字属于估算;免费开放的模型也需要计算资源,不能把模型免费理解成处理过程免费。扫描、存储、人工校对等费用,都没有包含在上述 GPU 租金中。
降成本,为什么不能只盯着新模型
作者指出,优化运行方式带来的节省,可以与换用新一代模型相当,甚至更多。他列出的办法包括:均衡分配页面任务、缩小扫描图像、更新软件,以及使用速度更快的 GPU。
这些办法处理的是不同环节。任务分配更均衡,可以减少处理资源等待;缩小图像,可以减少模型需要处理的输入。但图像缩小后是否丢失细字、模糊字的辨识信息,还需要单独检查。
每页成本由模型和运行方式共同决定。
对批量处理文档的 Node 服务,这个思路很实用:不要只比较模型名字,也要记录输入尺寸、处理耗时和最终可用页数。否则,模型换了,任务分配依然低效,成本未必按预期下降。
不过,原文没有给出各项优化的独立收益,也没有说明软件版本、图像尺寸和具体调度方式。因此,可以借鉴优化方向,不能直接照搬收益预期。更快的 GPU 是否更省钱,也要结合租价计算。
我的判断
这项测试支持一个明确结论:在给定硬件和测试材料下,较新的文字识别模型已经能以很低的 GPU 成本处理扫描页面。对积压了大量扫描件的项目,重新评估处理成本是有价值的。
但识别质量的证据还不够完整。报道只说,最新模型在书籍页面上的准确率至少不逊于最早模型,没有提供具体指标、逐类结果或人工评测方法。测试材料里有旧书,也不能据此认定模型同样适合中文古籍、竖排繁体或手写文献。
另一个实际问题是异常输出:部分模型会在空白页上生成文字,也会反复输出相同内容。这会增加后续校对成本,甚至污染检索内容。
更该比较的是每页可用文本的总成本,而不只是每页推理费。
原文比较的是这些 AI 模型,没有给出传统 OCR 或商业 API 的对照数据。哪种方案更适合一般团队,目前还不能仅凭这篇报道下结论。
能拿来做什么
- 如果项目积压了扫描书籍或档案,可以先选一批有代表性的页面试跑,分别记录 GPU 费用、处理耗时和人工修订量,再估算整体预算。
- 如果用 Node 编排批量识别任务,可以先检查页面任务是否分配均衡,并对不同图像尺寸做小规模对比,同时抽查细字和模糊页面。
- 如果识别结果要进入站内搜索,应在入库前检查空白页生成文字、异常重复和输出过长的问题,并保留原始页图,方便复核。
- 如果目标是中文古籍,应先用自己的竖排、繁体和特殊版式样本验证,不能直接套用这批历史书籍的费用与质量结论。