AI 精灵图导入引擎前要修哪些问题
文章拆解 AI 生成精灵图的常见缺陷,包括背景颜色不均、帧间距混乱、基线漂移、游离像素和烘焙阴影,并围绕修复顺序展开。核心问题是图片外观像精灵图,却不满足游戏引擎对切帧和透明背景的要求。
AI 深度解读
让图像模型生成「像素风史莱姆、跳跃动画、6 帧精灵图」,30 秒后,你可能拿到一张看起来很像素材的图片。可一放进游戏引擎,问题就来了:背景不透明、帧间距不一致,角色还会莫名抖动。
作者开发了一款精灵图切割工具,并专门拼出一张集齐常见问题的样图,演示如何补救。文章最有用的地方,是把「能切出来播放」和「动画素材合格」分开讨论:前者可以靠算法修,后者往往还得重画。
背景看着是纯色,为什么就是删不干净
样图里有 6 只绿色史莱姆,背景也是绿色。它同时包含间距不均、落脚高度漂移、悬空火花和画死在背景里的阴影。
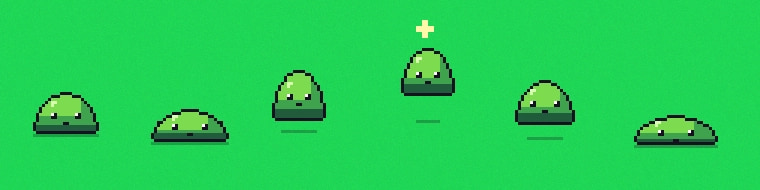
第一步必须去背景,因为后续识别角色,要靠透明区域把不同对象分开。
传统色键抠除(color keying)会取一个背景色,删除所有与它相等的像素。但生成图片里的背景通常带着细微纹理。样图角落的颜色是 #20d455,周围像素肉眼看着一样,RGB 数值却略有偏差,用 === 比较几乎删不掉。
作者改用颜色距离,允许像素颜色在一定范围内浮动:
const dr = r - keyR, dg = g - keyG, db = b - keyB;
const close = dr * dr + dg * dg + db * db <= tolerance * tolerance * 3;
要看第二行:它把 RGB 三个通道的差值平方相加,再与容差阈值比较,并非逐个判断通道是否相等。作者给出的样图中,tolerance 为 12 就能清掉背景;为 0 时则几乎保留原样。
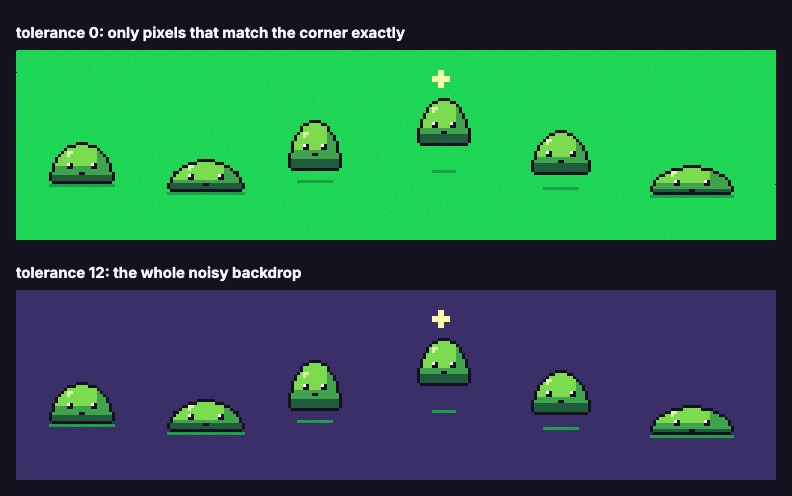
但绿色角色站在绿色背景上,容差一大,也可能把角色吃掉。因此,更关键的限制是:只删除与图片边缘连通的背景像素。
算法从边界出发,沿着颜色符合条件的像素向内扩散,碰到史莱姆的深色轮廓就停下来。角色内部的绿色没有被访问,自然不会被删。
这依赖轮廓能挡住扩散。人物两腿之间那种封闭背景区域,也无法从边缘抵达,需要切换到全图处理的 everywhere 模式,再谨慎调整容差。
没有网格,就按像素岛寻找每一帧
真实的规则精灵图,可以指定「6 列」直接切。样图相邻帧的间隔却分别是 28、13、33、21、35 像素,平均切成 6 列会切穿角色。
去背景后,作者把每片连通的不透明像素当作一个「岛」。从尚未访问过的实心像素开始做泛洪填充(flood fill),一边遍历,一边记录包围盒,就能找到各个对象的位置。
问题是,一个角色未必只有一片连通区域。
火花悬在身体上方,角色腾空时,阴影也与身体分开。直接检测会得到 10 个碎片,而不是预期的 6 帧。工具不知道火花属于谁,只知道它是一片独立像素。
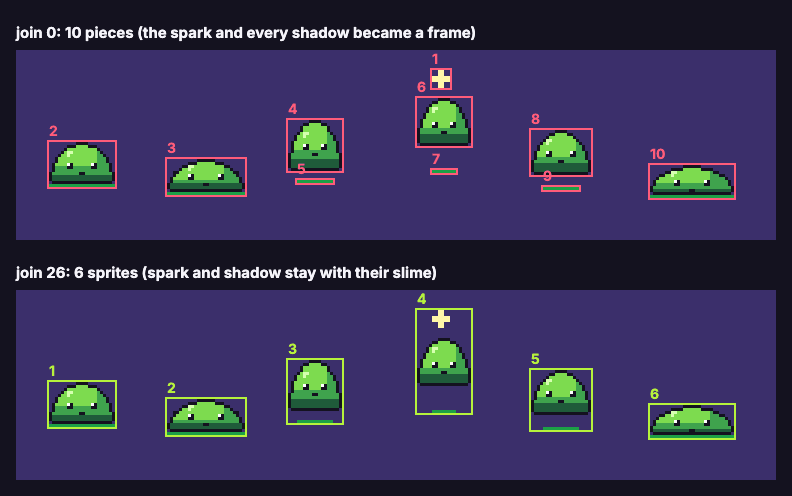
补救方法是增加一次合并:两个包围盒的距离在 N 像素以内,就将它们合并,重复执行直到没有新的合并发生。样图使用 26 像素的合并距离,把火花和阴影收回对应角色,最终得到 6 帧。
这个数没有通用答案。它必须大于角色内部零件之间的最大间隔,同时小于不同角色之间的最小间隔。
如果这两个范围发生重叠,调参就无法兼顾:阈值小了,武器和身体分家;阈值大了,相邻角色被并成一帧。作者也明确承认,这时只能手动画框。
统一尺寸还不够,锚点决定角色怎么动
检测出来的包围盒大小不同:压扁的史莱姆宽而矮,拉伸的史莱姆窄而高。引擎通常需要统一尺寸的单元格,因此要按最大尺寸给每帧补透明边距。
接下来才是容易漏掉的问题:角色放在单元格哪里?
如果每帧都居中,角色变高时,上下两边会一起扩展,脚底可能探到地面以下。改用底部中心作为锚点,形变就主要向上发生,脚底位置更稳定。
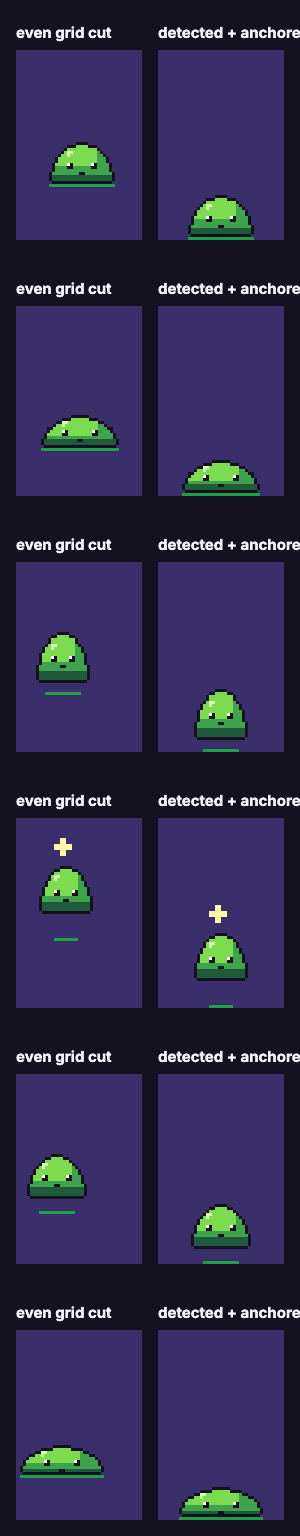
这能消除由切割和对齐方式引入的抖动,但不能替动画设计决定运动轨迹。对于真正需要腾空、下落的角色,仍要保留有意设计的位移。底部对齐是一个适合样图的处理选择,不能直接套给所有动作。
作者也划清了工具的边界。生成的「像素画」可能没有统一像素网格,像素块大小不一;不同帧的眼睛、反光和角色高度也可能变化。切割只能整理已有像素,无法让这些画面自动保持一致。
画进背景的阴影同样无法恢复。抠完后留下的是不透明的深绿色像素,可以保留或擦掉,却不能直接变回真正的半透明阴影。
我的判断
这套流程最合理的地方,是先处理数据依赖:去背景,才能识别像素岛;合并碎片,才能确定每帧范围;统一尺寸与锚点,才能稳定播放。对于前端 Canvas 或游戏素材预处理,这个顺序很容易迁移。
但文章展示的是作者主动拼出的演示样图。容差 12、合并距离 26,以及从 10 个碎片恢复成 6 帧,都是这张图上的结果。作者没有提供多组素材的成功率、耗时,或与手工切割的对照数据,不能据此认定工具普遍可靠。
相比直接要求模型输出规则网格,这种后处理方法可以处理已经生成的素材;相比手动画框,它能减少边界清楚、间隔明确时的重复劳动。可一旦角色零件和相邻帧挤在一起,人工判断仍然更直接。
我更赞同作者把生成精灵图当作动画分镜的建议。 先切出来播放,判断 6 帧跳跃的节奏是否成立,再重画值得保留的帧。它适合验证动作想法,离可直接交付的素材还有距离。
能拿来做什么
- 如果你在做 Canvas 动画或小游戏,先用生成图验证动作节奏,确认播放效果后再投入逐帧修图,避免只看静态图片就决定采用。
- 如果你要写浏览器端或 Node 图片处理脚本,可以按「边缘连通去背景、连通区域检测、邻近包围盒合并、统一画布」组织流程,并把容差和合并距离做成可调整参数。
- 给日常 AI 编程助手安排这类任务时,要明确背景封闭区域、独立火花和腾空阴影等边界情况,并要求输出检测框预览,方便发现误合并。
- 导入素材后实际播放一遍,分别检查切割抖动、锚点偏移和角色画法变化;前两类可以调整处理流程,最后一类需要修图或重画。