16GB 显卡跑通义 9B:长上下文代价实测
作者使用 llama.cpp 在 RTX 5060 Ti 上测试 Qwen3.5-9B,短提示生成速度为每秒 71 token,260k 上下文占用约 15GB 显存。满上下文时生成速度降至每秒 28 token,首字等待约 2.7 分钟,展示了容量与交互延迟的取舍。
AI 深度解读
16 GB 显存能装下多长的上下文?作者把 Qwen3.5-9B 跑在 RTX 5060 Ti 上,测到了 260k tokens,同时短提示词下能达到每秒 71 tokens。但「装得下」和「用起来顺」是两回事:上下文拉满后,首字要等约 2.7 分钟。
这组测试更有用的地方,是把本地推理拆成了三个问题:生成有多快、开始回答要等多久、多人共用时能撑多少吞吐。读完可以判断自己的需求更适合 llama.cpp、Ollama,还是 vLLM。
260k 上下文装得下,为什么还要等这么久
Qwen3.5-9B 是一个 90 亿参数模型。作者在 NVIDIA GeForce RTX 5060 Ti 上,用约 15 GB 显存容纳了 260k tokens 的上下文,显卡总显存为 16 GB。
这里要区分两个指标:首字延迟,是提交请求后多久开始输出;生成速度,是开始输出后每秒能写多少 tokens。
作者用 llama.cpp 测得:
| 上下文长度 | 生成速度 | 首字延迟 |
|---|---|---|
| 512 tokens | 71 tokens/s | 短提示词下为 164 ms |
| 32k tokens | 60 tokens/s | 10 s |
| 260k tokens | 28 tokens/s | 约 2.7 分钟 |
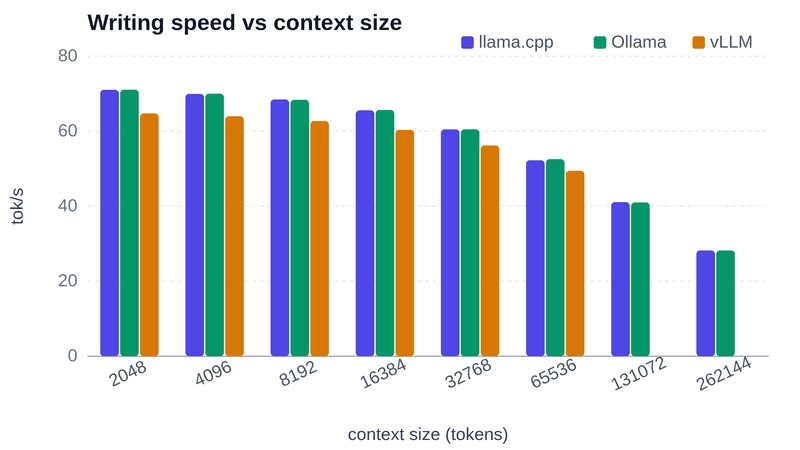
长输入需要先被模型处理,之后才能逐步生成答案。因此,即使输出速度还能接受,前面的等待也可能已经打断工作节奏。
原文用一本 100 页的书举例:约等 10 s 开始回答,随后输出速度达到其所称阅读速度的 13 倍。不过,页数如何换算成 tokens、阅读速度采用什么标准,文中没有交代,实际判断应优先参考 token 数和实测时间。
260k tokens 证明了这套配置的容量,尚不能证明它适合实时交互,也不能证明模型能准确利用全部内容。
单人和多人使用,为什么会选出不同工具
作者比较了 llama.cpp、Ollama 和 vLLM,三者都按安装后的原样运行。
单人使用时,llama.cpp 的生成速度略占优势,首字等待和启动时间也更好;Ollama 在各个已测上下文长度上的生成速度与它相当,两者都能容纳最长上下文。作者因此倾向单人选 llama.cpp,希望安装更省事则考虑 Ollama。
vLLM 在共同测试的上下文长度上略慢:短提示词约 65 tokens/s,32k 时约 56 tokens/s,而且这次配置的上下文上限为 66k tokens,无法参加更长输入的测试。
但切换到并发负载,结果就不同了。
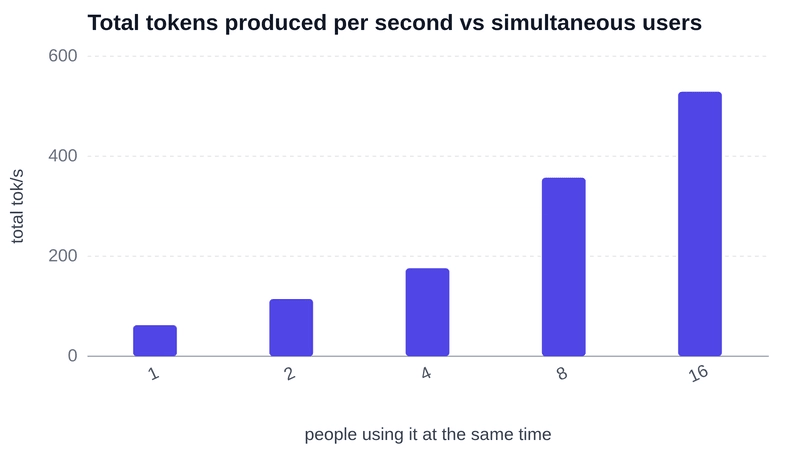
vLLM 单人测试的总吞吐为 62 tokens/s,16 人同时使用时达到 529 tokens/s,每人的首字等待约 2.2 s。这里的 529 是所有用户合计,不能理解成每个人都有这个速度。并发测试中的 62,也不宜直接与前面短提示词测试的 65 混为同一条件下的结果。
多人请求让推理服务有机会把计算集中处理,提高整张卡的利用率。于是,个人电脑上看重的单次响应速度,与团队服务看重的总吞吐,会导向不同选择。
能耗方面,作者报告每生成 1M tokens 消耗约 1.0 kWh,按其电价约为 €0.26;三种程序中 vLLM 最省电。这个费用是生成阶段的电费估算,不能直接当成服务总成本。
我的判断
这篇最有价值的结论,是选本地推理工具之前,先确定负载:自己偶尔问问题,还是多人持续发请求。只比较一个 tokens/s 数字,很容易选错。
但工具排名有一个明确限制:llama.cpp 和 Ollama 使用 gguf-Q4_K_M,vLLM 使用 awq-AWQ-4bit。它们是不同的模型量化版本,也就是用不同方式压缩模型参数。压缩方案可能影响速度、显存和回答质量,因此这组结果比较的是三套实际配置,不能把差异全部归因于推理程序。
作者保持整个系列的硬件不变,有助于后续比较;不过,输入材料没有给出完整的软件版本、启动参数和并发请求长度,读者暂时无法严格复现。
另外,原文没有回答质量、代码正确率或长文检索准确率的对照数据。「一台预算电脑能服务整个团队或小产品」有吞吐实测支撑,但业务是否可用,还要验证任务质量和真实请求负载。Ollama 安装更容易的建议,也属于使用取舍,并非这组性能数据直接证明的结论。
能拿来做什么
- 如果你准备搭个人本地 AI 助手,可以先用 llama.cpp 跑自己的常用请求,同时记录首字延迟和生成速度,再决定是否采用作者这套选择。
- 如果要做团队共享的 AI 服务,可以优先验证 vLLM,并用实际输入长度和输出长度压测;把 16 人、529 tokens/s 当作参考结果。
- 给 AI 提交长文档时,先裁掉无关内容,再比较完整输入与精简输入的等待时间和答案质量。显存能容纳全部材料,不代表每次都值得塞满。
- 估算运行费用时,可以拿 1.0 kWh/1M generated tokens 作起点,再按本地电价补算,并另计待机、硬件和维护成本。