
8.0
热点
AI SCORE
编程提效2026-09-17 02:17
Agent 循环的瓶颈不是 Token,是反馈机制
dev.to · AI#Agent#LLM工程#成本优化
Editor brief · 编辑速览
Loop 式开发中 Agent 长时间并行运行,成本取决于验证层质量而非 Token 价格,交互式编程的计费模式不适用于此。
基于 Loop 的开发意味着 Agent 运行时间更长、并行度更高,而且没有人盯着每次尝试。其成本取决于 Agent 下面的验证层,而不是 Token 价格。
AI 编程圈最近流行一句话:"写 Loop,不写 Prompt。"在基于 Loop 的开发中,Agent 不再需要等人介入。一个小程序把目标交给它,运行它产生的任何结果,用一组检查来验证,把失败反馈回去,然后重复直到检查通过或达到限制。Loop 会一直运行,多个 Loop 同时运行,没有人去读中间的尝试结果。这就是这个模式的意义,也是它比人一步步操控 Agent 更快的原因。
但这恰恰构成了一个成本问题的形状。过去一年,业界已经迎来了对 Agent Token 消耗的第一次收缩:固定费率座位让位给按量计费,Agent 产品加了用量上限,工程负责人被要求解释一个合并的 PR 实际花了多少钱。这些账单都来自交互式会话——有人在旁边,可以合上笔记本。Loop 则是有意地把这个人拿掉。不管一个 Agent 有人在旁边看一小时能花多少,Loop 可以整晚花、十几个并行跑、没有任何人看着。
两个跑相同代码的 Loop 针对同一个仓库,仍然可能产生截然不同的账单。区分它们的不是 Loop 本身,而是 Loop 能观察到它正在修改的系统的哪些部分。对于在 Kubernetes 上跑分布式服务的团队来说,这个差距就是整个成本结构,而且其中大部分在 Loop 运行之前就已经被决定了。
Loop 把人从计量器旁边移开了
Agent 开发中的每一步都在把人类从每次尝试的决策中往外推一步。基于 Prompt 的工作把开发者留在每次迭代里,读输出、打字修正,所以消耗被人自己的注意力和耐心封了顶。基于 Spec 的工作——Spec Kit、Kiro 和 OpenSpec 属于这一波——把开发者的投入提前到了规格说明和仓库约定上,人回来审查完成的任务。Loop 驱动的开发让 Loop 本身成了开发者写的产物。他们不再写代码,而且越来越不写单个任务。他们写的是那个生成工作、检查工作、重试的东西。
让一个 Loop 值得写的三个特性,同时也正是让它昂贵的三个特性。它无人值守,所以一个在错误修复上打转的 Loop 没有人会注意到。它长时间运行,所以消耗时钟不会自己停下来。它是并行的,所以不管一个 Loop 花多少,你同时在为很多个付钱。这些都不是反对 Loop 的理由。这是说明工程已经从前端的 Prompt 转移到了 Wrapper 上:Loop 运行哪些检查、失败时得到什么返回、以及在什么条件下停止。
Loop 成本是乘积,不是求和
一个常见的假设是:便宜的生成能解决成本问题。不能。生成速度快、单价比开发者工时便宜,但 Token 是真实且在增长的项目,而 Loop 是有意让 Agent 持续运行的。那些在交互式会话中存活下来的预算,不会默认在 Loop 中存活下来。
大多数团队第一个想到的应对是护栏:迭代次数上限、无进展检测、花费上限。这些是必要的,但还不够。上限只能限制一个浪费的 Loop 能浪费多少。它不会让 Loop 少浪费。
真正决定账单的是两个数字相乘:Loop 在得到经验证的结果之前需要多少次迭代,以及每次迭代的成本是多少。因为是相乘关系,把两项各减半不会让账单减半,而是降到四分之一。任意一项的底价就是总价的底价,没有任何护栏能抬高它。
Loop 的总成本是乘积,不是求和。把高保真反馈拉进内层 Loop 同时压缩两项。
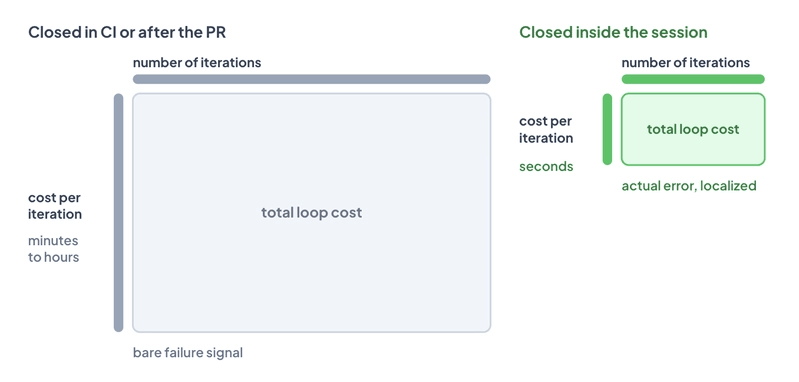
一个只收到裸失败信号的 Loop 只能猜测原因。它改动一个看似合理的部分然后再跑,下一个裸失败几乎不能说明猜测是否接近。一个收到实际错误的 Loop——由实际系统产生,有足够的上下文来定位故障——修复的是真正的问题然后继续。
反馈质量也限制了最终变更能达到的质量,这比迭代次数更重要。Loop 只能修复它的反馈能看到的部分。给它单元测试和 Mock,它就会在单元测试和 Mock 通过时停下来,这与变更实际可用是两码事。
Token 价格和上下文大小是每次迭代成本的一部分,Loop 作者可以调优这部分。平台决定的是每次迭代等待答案的时间,以及它背后的环境成本。
在 CI 中闭合 Loop,即代码已经离开 Agent 会话之后,每个周期买的是一次流水线运行加上在别人队列里的一个位置。节奏落在分钟到小时级。在会话内部闭合,针对 Agent 可以直接调用的运行时,节奏落在秒级。
这两项也不是独立的。把高保真反馈推到 CI 不只是让每个周期变贵,它还让 Agent 在中间继续用部分信号迭代,这也会推高迭代次数。把高保真反馈拉进内层 Loop 同时压缩两项。这是唯一能同时改变两项的招。
Loop 总成本是迭代次数乘以每次迭代的成本。护栏限制损失。只有更好的反馈、更快地触达,才能改变乘积本身。
分布式系统把两个数字都往错误方向推
对于一个自包含的程序,两个数字都接近于零。测试套件在笔记本上几秒跑完,它报告的是完整答案,因为完整系统在笔记本上。这也是最有说服力的 Loop 演示往往是单一仓库项目的原因。
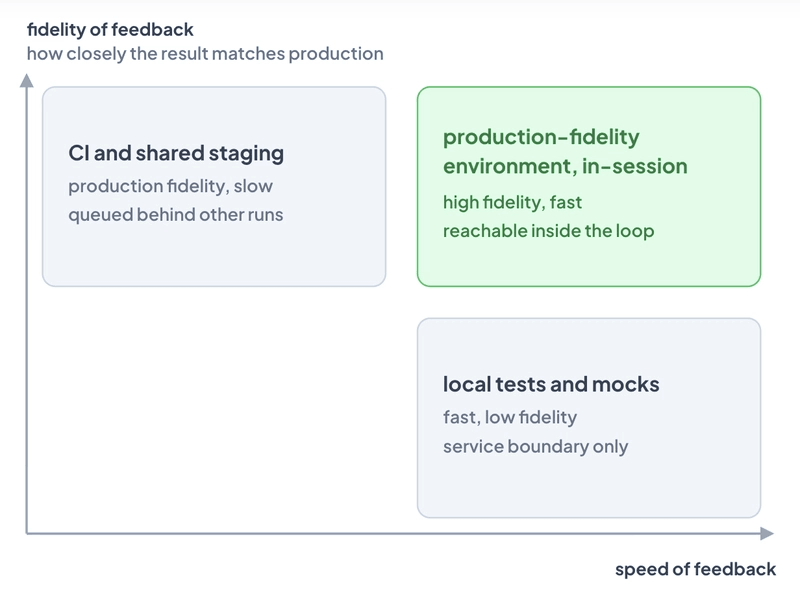
一个微服务变更不能这样判断。它是否正确取决于它的被调用方返回什么、它写入的队列和数据存储如何表现、以及它前面的路由和策略层对它的流量做了什么。Agent 能在秒级触达的反馈——本地测试和 Mock——是低保真的:它只覆盖了服务边界内部的代码。集成测试通过而预发环境挂掉,恰恰就是这个原因。能捕获问题的反馈具有生产级保真,而传统上它住在 CI 和共享预发环境里,每次运行都要排在别人后面等。
所以云原生团队已有的两个选项直接相互对抗:快而低保真,或者高保真而慢。Loop 为两项付钱,所以这两种权衡都不够好。传统环境选项在 Agent 并发面前由于结构性原因而走到尽头,而不是调优原因。Loop 需要的是那个不权衡的选项:一个具有生产级保真、Loop 可以从会话内部触达的环境。
本地测试和 CI 在保真度和速度之间权衡。Loop 能从会话内部触达的生产级保真环境,是那个不权衡的选项。
你构建的是验证层
一个 Loop 是否用实际能用的变更结束、以及到达那里花了多少成本,由平台团队构建的四个要素决定。Loop 在每次迭代中都穿过这四层。
每次迭代都穿过四层。运行时决定每次迭代花多长时间,反馈决定需要多少次迭代,done 的定义决定何时停止,控制项对总数设上限。
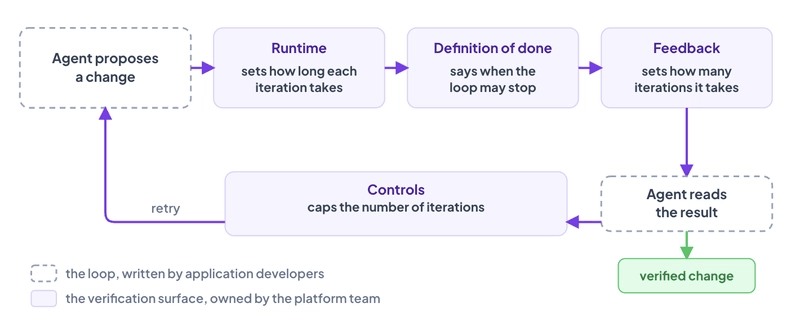
每次迭代需要一个表现得像生产环境但不像生产环境那样花钱的环境。共享集群上的轻量级临时环境能做到:只部署变更触及的服务,然后用请求路由把 Loop 的流量导流经那些服务以及其余一切的稳定共享部署。环境几秒启动,边际成本追踪的是你改动的 Pod 而不是完整栈。这是平台团队控制每次迭代成本的杠杆,也是保真度的来源。
Agent 不会点着仪表盘走,也不应该自己发明通过的判定标准。变更必须满足的检查属于声明式验证工作流,由平台团队编写、版本化,然后作为 Agent 证明变更的官方方式交给它。组织来决定什么意味着"通过",审查者得到的是哪些检查运行过的记录,而不是 Agent 说它完成了的话。这就是告诉 Loop 什么时候可以停的东西。
这是控制迭代次数的杠杆。一个简单的通过或失败告诉 Loop 重试,但不告诉它改什么。运行时应该返回结构化结果:哪个检查失败了、日志和追踪被限定在这次 Loop 自己发出的请求范围内、以及在边界上导致失败的行为变化。每增加一点精度就消除一个猜测,而每消除一个猜测就省下一笔永远不会发生的消耗。
预算、迭代上限、停滞检测,以及每个 Loop 运行过的每次检查和每个结果的持久记录。这些不会缩小任意一项,但给乘积设了硬上限,这样你就能跑数百个 Loop、在计划里写一个数字,而不是紧张地守着这一个 Loop。
这现在是一个平台团队的问题
角色分工源于成本结构。应用开发者决定做什么,并用一种 Loop 可以自我检查的形式陈述目标。平台工程师拥有 Loop 穿过的所有东西:哪些检查运行、在哪里运行、Loop 被允许花多少、以及输出附带什么证据。这些必须在组织中的每个 Loop 上保持一致,而不是在每个 Loop 内部重新发明。
平台团队以前跑过这个剧本。CI/CD 从每个团队自己布线变成了一个共享系统,有所有者和契约。Loop 的验证层是同样的转变,只有一个新要求:它必须在编写期间工作,在 PR 存在之前,以 Loop 产生的任意并发度工作。
从运行时开始,因为其他三项都立在它上面。验证工作流继承它们执行所在地方的保真度,反馈继承产生它的东西的准确性。那一层是我们在 Signadot 构建的东西:一个 Kubernetes 原生的验证平台,具有轻量级临时环境和受治理的验证工作流,这样 Agent Loop 可以在秒级针对实时系统证明变更。文档里有各部分如何组合的说明。如果你的 Agent 已经比你的团队能验证的更快地产生变更,你下一张账单的大小是由反馈层决定的,而不是 Token 价格。