
8.0
热点
AI SCORE
模型发布2026-09-16 22:30
Gemini 3.8 Live 支持异步工具调用,3.5 Transcribe WER 低至 2.6%
Google AI · DEV#Google#Gemini#语音 AI
Editor brief · 编辑速览
Google 发布 Gemini 3.8 Live 和 3.8 Live Extended Thinking,原生语音到语音模型支持异步函数调用和视觉上下文,语音转写 3.5 Transcribe 在 85+ 语言上 WRE 仅 2.6%。
我们发布了全新的 Gemini Live 模型,登陆 Gemini API 和 Google AI Studio,为开发者提供了构建实时、语音优先产品体验的开发套件:
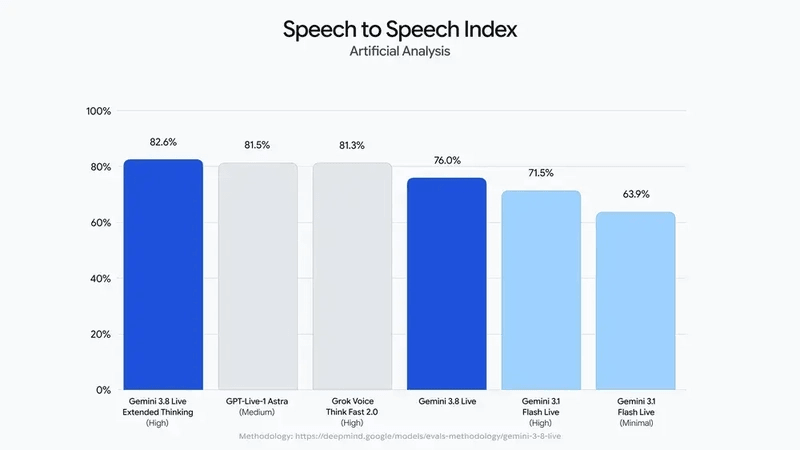
Gemini 3.8 Live 和 Gemini 3.8 Live Extended Thinking:Gemini 3.8 Live 为原生语音到语音模型带来了重大飞跃,能够在保持对话连贯性的同时执行任务。针对复杂请求,3.8 Live Extended Thinking 提供更深入的推理能力,在 Artificial Analysis 的语音到语音排行榜上位列第一。
Gemini 3.5 Transcribe:这款专用语音转文本模型在 85+ 种语言中实现了高精度的转录。该模型于上月发布,流式转录平均词错误率(WER)达到 4.0%,非流式转录为 2.6%。
我们的新模型——Gemini 3.8 Live 和 Gemini 3.8 Live Extended Thinking——使开发者能够构建在保持对话流畅的同时进行推理和执行任务的语音代理。核心能力包括:
异步函数调用:在后台执行 API 和工具调用,同时持续向用户流式传输音频响应。
视觉上下文:将对话建立在实时视觉输入之上,帮助代理理解用户所说的和所看到的内容。
字母数字精度:准确解析确认码、理赔号和技术数据。
多语言支持:覆盖 97+ 种语言及口音一致性,触达全球用户。
增量内容更新:将实时音频与结构化数据无缝合并,返回上下文感知的响应。
3.8 Live Extended Thinking 还支持可配置思考能力,帮助在后台处理复杂多步骤推理,同时在主对话中响应或叙述其进度。这些模型代表了我们此前 Live 模型的重大飞跃,提供了比级联架构更精简的替代方案。
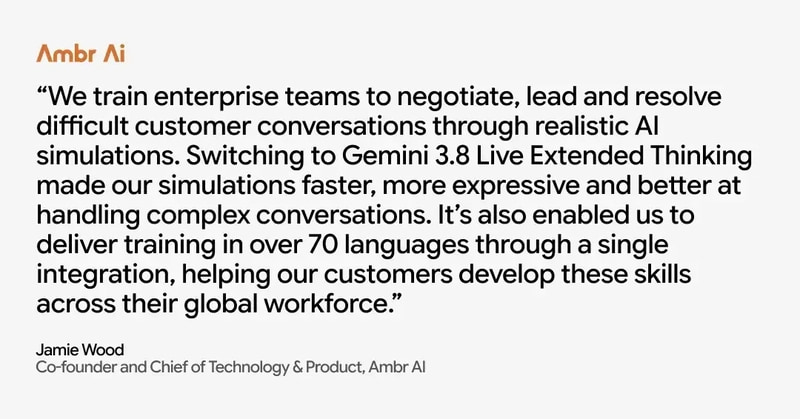
Gemini 3.8 Live 和 Gemini 3.8 Live Extended Thinking 通过 Live API 提供。极具竞争力的定价:音频输入 $0.005/分钟,音频输出 $0.018/分钟,开发者可以行业领先的性能规模扩展语音应用。
开发者还可以通过 Live API 集成合作伙伴访问这些模型——它们负责处理真实部署场景中的媒体流基础设施,包括 Agora、Fishjam、LangChain、LiveKit、Pipecat、Vercel 和 Vision Agents。
实时语音理解对于语音优先界面至关重要。上月我们发布了 Gemini 3.5 Transcribe,实现低延迟、高精度的转录,WER 达到 4.0%,并具备以下实用功能:
自动码转:无需手动配置即可处理句内和句间的代码及语言切换。
自定义词汇偏置:通过传递最多 1,000 个术语的自定义词汇表(custom_vocabulary),引导语音识别适配特定领域的术语、生僻行业用语、公司名称和专有名词。
智能转录模式:提供可直接阅读的精炼转录稿,包含结构化格式、自动纠错及消除填充词的去流畅处理。
3.5 Transcribe 支持 85+ 种语言,为语音体验和亚秒级字幕、呼叫中心代理、实时音频分析等无状态任务提供强大的语音引擎。开发者还可以通过 Interactions API 访问该模型,转录长达 1 小时的音频文件,并获得带结构化时间戳和说话人标注的结果。详情参阅开发者指南。
快速上手:在 ai.studio/live 试用模型,从 GitHub 克隆示例应用,或使用我们的 Live API 技能为代理赋能。
你还可以通过 Gemini API 中提供的语音和音乐生成模型创建音频体验:
Gemini 3.5 Live Translate:覆盖 70+ 种语言的语音到语音翻译。
Gemini 3.1 Flash TTS:高度可配置的语音生成(更多更新即将推出)。
Lyria 3.5:生产级音乐生成。
麦克风交给你了,期待看到你们的作品!