Claude 长会话闲置后可能触发缓存重写费
文章以 API 密钥计费的 Claude Code 长会话为例,说明提示缓存过期后,短追问也可能触发整段上下文重新写入缓存,示例费用从约 0.04 美元升至 1 美元。文中称新版客户端加入闲置压缩,以减少这类开销。
AI 深度解读
同一句「顺便把测试文件改个名」,为什么休息前只花约 $0.04,回来后却要 $1.00?作者给出的解释是:长会话的提示词缓存过期了,下一次请求需要重新写入整段历史。消息虽然短,参与计费的上下文却可能有 200,000 tokens。
这篇文章真正有用的地方,是把缓存账单、Claude Code 的空闲压缩和上下文丢失连在了一起。不过,文中的价格来自标价计算,压缩收益也包含假设,不能直接当成每个团队的实测结果。
为什么只发一句话,也会重新买下整段历史
按原文的解释,Claude Code 每一轮都会发起新的 API 请求,重新发送会话历史。提示词缓存(prompt caching)复用的是请求开头没有变化的部分,也就是前缀,并不是模型在两次请求之间记住了整个项目。
同一批历史 tokens,缓存命中时按读取价收费,过期后则可能重新按写入价收费。原文列出的倍率是:5 分钟有效期(TTL)的写入价为基础输入价的 1.25 倍,1 小时为 2 倍;读取价通常为 0.1 倍,但 Opus 5.5、Sonnet 5.5 为 0.05 倍,Fable 5.1 为 0.025 倍。
每次命中都会刷新计时,时间从读取或写入请求开始时算起。持续工作时缓存可以一直有效,离开超过 TTL,下一轮就可能重新写入。
以 Opus 5.5 的 200K tokens 前缀为例,原文算出的读取费用约为 $0.04,5 分钟缓存写入为 $1.00,1 小时缓存写入为 $1.60。这里只比较历史前缀,新消息和回复的费用另算。冷写入相对热读取分别贵 25 倍、40 倍;Fable 5.1 对应为 50 倍、80 倍。原文还称,Claude 4.6 及之后的模型除 Haiku 5.5 外,完整 1M 窗口按标准价格计费,没有额外长上下文附加费。
决定这一轮费用的,不只是你新输入了多少字,还有旧上下文是否仍在缓存里。
付款方式也影响默认值。原文称,Claude 订阅在套餐包含用量内,主会话请求 1 小时 TTL;API key、usage credits 或云服务商默认使用 5 分钟。订阅用户看不到逐笔美元账单,但缓存重建仍会消耗套餐额度。
把 TTL 调到一小时,一定更省吗
不一定。更长的缓存有效期,需要更高的写入价。
作者假设一个会话逐轮追加,累计向缓存写入约 200K tokens。Opus 5.5 从 5 分钟切到 1 小时,额外写入成本约为:
200K ×($8 − $5)/ 百万 tokens = $0.60。
如果随后有一次超过 5 分钟、少于 1 小时的休息,回来时就可能用 $0.04 的读取替代 $1.00 的重写,抵掉这笔溢价。可如果离开超过 1 小时,两种 TTL 都会过期,而长 TTL 的重写要花 $1.60。
Claude Code v2.1.242 及之后可以在 settings.json 中配置:
{
  "promptCacheTtl": "1h"
}
要看清的是 "1h":它提高了缓存保存时间,也提高了写入单价。
实际判断应该看 usage。API 返回的 cache_creation_input_tokens 是缓存写入量,cache_read_input_tokens 是读取量,input_tokens 是最后一个缓存断点之后、没有参与缓存的输入量,三者相加才是总输入。cache_creation 还会用 ephemeral_5m_input_tokens、ephemeral_1h_input_tokens 区分写入期限。
在 Claude Code 中,可以运行 claude -p "hello" --output-format json,检查 usage.cache_creation。v2.1.251 及之后的 /usage 会显示 Prompt cache (main),包括命中比例、miss 次数、重新缓存量和 TTL;2.1.311 修复后,大型缓存 miss 也会出现在 What's contributing to your limits usage? 下。历史会话记录位于 ~/.claude/projects/<project>/<session>.jsonl。
作者还提供了 Python SDK 的复现脚本:使用 client.messages.create,指定 model="claude-opus-5-5"、max_tokens=256,给大型 system 文本设置 cache_control: {"type": "ephemeral"}。原文称 Opus 5.5 至少需要 512 tokens 才能缓存,过短会静默跳过;5 分钟内重跑应看到读取,等待 6 分钟后重跑应看到写入。不过,文章没有展示这组实验的实际输出。
空闲压缩省下的钱,用什么交换
Claude Code 2.1.299 在 10 月 14 日把空闲压缩带到终端,2.1.314 在 10 月 30 日扩展到 VS Code 和 Claude Desktop 的 Code tab。
它趁缓存还有效,先把长历史读出来生成摘要。用户回来后,如果原缓存已经过期,下一轮写入摘要和重新读取的文件,避免重写全部历史。
但触发条件不少:交互终端、VS Code 聊天面板或 Desktop Code tab,本地或 SSH 会话;开启自动压缩;使用 1 小时 TTL;能够获取 Anthropic feature flags;上下文默认达到 200,000 tokens;距上次请求约 1 小时,而且电脑保持唤醒。
这里有个容易漏掉的限制:200K 窗口通常会在达到 200,000 tokens 前自动压缩,因此默认阈值主要适用于更大窗口。可以在 settings.json 的 env 中设置 CLAUDE_CODE_IDLE_COMPACT_MIN_TOKENS,最低为 100,000;设置 "idleCompaction": false 则关闭这项功能。
摘要也有账单。作者假设摘要为 10,000 tokens,按 Opus 5.5 输出价 $20/百万 tokens 计算:读取约 $0.04,生成摘要约 $0.20,写入 1 小时缓存约 $0.08,合计 $0.32。这个数还没包括 thinking tokens 和重新读取文件的费用。原文称 Opus 5.5 无法关闭 thinking,且 thinking 按输出计费,所以 $0.32 只能作为该假设下的费用下限,对比的是完整冷重写的 $1.60。
更大的交换是细节。项目根目录 CLAUDE.md、auto memory 和计划会从磁盘重新注入;最多重新读取 5 个近期修改文件,超过 5,000 tokens 的文件只恢复路径。路径规则、嵌套 CLAUDE.md、精确错误信息和已经排除的思路,可能随历史一起被概括,未必完整保留。
压缩缩小了下一轮输入,也改变了下一轮可用的证据。
我的判断
作者把「缓存读取」和「缓存写入」分开看,这一点很有价值。只记录总 tokens 或会话累计费用,很难解释为什么休息后的第一条消息突然变贵。
但「长 TTL 更省」「空闲压缩更划算」都带条件。前者依赖休息时长、前缀稳定性和累计写入量;后者依赖摘要长度、thinking 消耗、文件重读量,以及压缩后是否需要重新调查。文章没有给出多会话对照数据,也没有衡量丢失细节后的返工成本,因此更适合作为机制解释和估算方法。
对还在排查偶发问题的前端或 Node 项目,我会更看重证据保留。报错原文、复现步骤和失败尝试如果丢了,即使缓存账单下降,任务总成本也可能上升。手动指定重点的 /compact 比完全交给空闲摘要更可控;任务已经无关时,/clear 更直接。原文提到的 /rewind 可以回到已有缓存前缀,但仍应结合缓存是否过期理解。
作者推广的 Hermes 也要按边界看。Hermes 2.3.4 于 10 月 15 日加入会话上下文仪表,支持并排运行 Claude Code、Codex 等代理,费用可能来自代理报告,也可能是标注过的估算。它不知道缓存冷热和 TTL,也不会主动压缩。
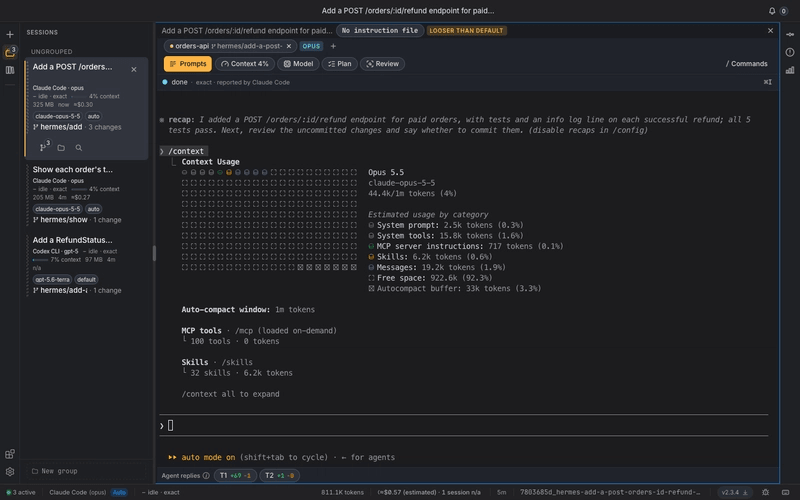
原文称它可免费下载,采用 BSL 1.1,支持 macOS、Windows、Linux,与 Anthropic、Nous Research 或代理厂商没有关联。是否需要这个界面,取决于你是否管理多个长会话,单纯诊断缓存账单可以先用 /usage。
能拿来做什么
- 用 API key 做长时间 AI 编程时,先比较休息前后的
/usage,确认费用增加是否来自大规模缓存重写,再决定是否设置"promptCacheTtl": "1h"。 - 离开正在排查问题的前端或 Node 会话前,使用
/compact focus on the failing auth test这类指令明确摘要重点,并把关键报错、复现步骤和已排除方案保存下来。 - 下一项任务与当前工作无关时,使用
/clear,避免继续携带整段历史;需要回退已有探索时,再考虑/rewind。 - 自己开发 LLM 功能时,分别记录缓存读取、缓存写入和普通输入量,并区分 5 分钟与 1 小时写入,才能查清单次请求成本为何跳涨。