语音 Agent 如何通过回放筛选自修复方案
Rewire 将错误追溯到工作流节点,生成多个修复候选,再回放历史通话过滤引入回归的修改,并将通过验证的方案存入向量库。文中展示记忆提交代码及跨领域修复案例,33 个候选中有 27 个被验证器拒绝。
AI 深度解读
Rewire 想解决的,是语音 Agent 答错之后,怎样把一次纠错变成可复用的流程修复。它会定位出错节点、生成多个补丁、回放历史通话,再把通过验证的修复存起来。重点不是让模型再反思一遍,而是检查工作流里哪一步没有执行。
原文最有意思的例子是:汽车维修 Agent 编造刹车价格后得到的修复,被医疗 Agent 找到,用来纠正保险自付金额。这个案例展示了跨业务复用的可能性,但距离证明系统能可靠地持续自我改进,还有一段距离。
答错价格,为什么要改工作流
作者给出的刹车报价案例里,Agent 已经有知识库工具,却没有调用,直接报出了价格。问题出在「该查资料时没查」,单纯补充资料并不能解决它。
RAG(检索增强生成)改善的是检索回来的内容;Rewire 盯住的是更前面的一步:指令和路由有没有触发检索。手动给提示词补一句「报价前必须查询」,也未必能保证每次执行,而且另一个业务流程可能还要再补一次。
Rewire 因此把修复对象放在工作流上。刹车案例中,胜出的操作是 add_tool_requirement,要求 pricing_lookup 在报出具体价格前调用知识库。
可复用的经验是「给出具体数值前必须验证」,而不是某个刹车产品应该卖多少钱。
不过,原文没有展开这个要求如何被执行引擎强制落实。因此,不能直接把它理解为代码层面已经杜绝了跳过工具的可能。
自动修复靠什么筛掉坏补丁
这套系统把对话执行、答案核验和补丁验证拆开了。
Dograh 负责编排对话流程并管理版本。Pioneer 通过 OpenAI-compatible endpoint 提供 gpt-5.4-mini 推理,每次调用返回节点、指令、工具、工具调用和跳转信息。Senso 提供带引用的已核实答案;SensoOracle 再对比 Agent 的回答,返回正确性评分、依据充分程度、真实值、失败类型、诊断理由及升级处理结果。
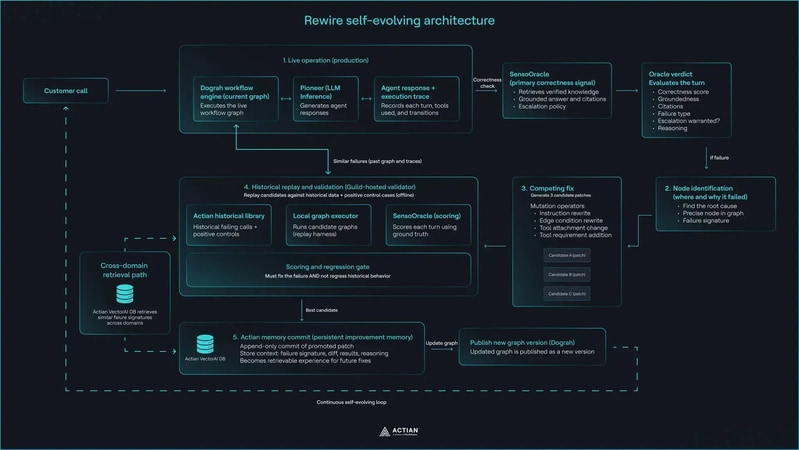
修复先要找对位置。Rewire 沿着 Dograh 的 node_transition 事件和执行历史追踪根因。最后说出错误答案的节点,未必是最早做错决策的节点;只修改输出位置,可能留下前面的错误路由。
找到根因后,系统从四种有边界的变更操作中选择,每一轮生成三个结构不同的候选补丁。原文只具体介绍了 add_tool_requirement,其余三种没有说明。
接着,由 Guild 托管的验证器把补丁应用到工作流的本地副本,回放历史通话。候选既要修复当前错误,也不能破坏过去已经正确的行为。存活者中,验证置信度最高的补丁才会更新到线上流程。
这次运行中,33 个候选有 27 个被淘汰。这个数字说明筛选环节确实排除了大量候选,但不能据此推导准确率提高了多少。原文没有给出历史通话规模、覆盖范围和置信度算法。
刹车报价的修复,怎样匹配到保险金额
跨业务复用依赖的是「失败签名」,即用结构化描述记录错误是怎样发生的。
to_embedding_text() 只保留节点角色、失败类型、检索工具是否可用、是否调用,以及是否断言了具体事实值。用户原话、真实答案、业务领域、节点 ID 和产品名都不进入 signature_vector。
这样设计,是为了让向量检索比较行为上的相似性。汽车和医疗的词汇差别很大,但「有验证工具却没用,随后编造具体数值」是同一种失败形状。
原文用下面这段代码展示补丁如何写入 Actian VectorAI DB:
def store(self, patch: WorkflowPatch) -> str:
    """嵌入补丁的失败签名,并连同扁平载荷执行 upsert。

    返回 Actian point ID,它是 patch.patch_id 对应的 uuid5。
    同一补丁验证后再次存储,会原地更新而不会产生重复记录。
    """
    self._require_ready()
    vector = embed(patch.signature.to_embedding_text())
    pid = point_id_for(patch.patch_id)
    self.client.points.upsert(
        self.collection,
        [PointStruct(id=pid, vector=vector, payload=patch.to_actian_payload())],
    )
    return pid
要看的是 embed(patch.signature.to_embedding_text()) 这一行:嵌入的是失败签名,补丁内容放在 payload 中。签名被转换为 384 维向量;point_id_for() 根据补丁 ID 用 uuid5 生成稳定 ID,让同一补丁从 candidate 更新为 promoted 时执行原地 upsert,不重复新增。
医疗案例中,Agent 编造了 $40 的保险自付金额,而核实值是 $47。它检索到刹车报价的修复,并在第一次尝试中纠正了金额。检索出来的补丁仍然经过验证,才进入医疗工作流。
本地体验入口也很直接:运行 docker pull actian/vectorai:latest,尝试 VectorAI DB Community Edition。但这只是数据库镜像的拉取命令,不能据此认为整个 Rewire 已经完成部署。
我的判断
我认同它把重点放在根因定位和历史回放上。让模型生成补丁并不稀奇,真正影响工程可用性的,是能否识别改错位置,以及能否发现修复带来的回归。
但这仍是一个黑客松项目展示,文章最初发布于 Actian 博客。跨业务成功案例很有启发,却没有与人工改提示词、固定工具路由或规则引擎做对照。关于维护成本更低、泛化能力更强的判断,目前只能当作经验之谈。
去掉领域词汇也有代价:相似的失败形状,不保证适用同一种修复。不同业务对验证来源、权限和异常处理的要求可能不同。原文保留了再次验证这一步,是合理的,但没有说明如何适配不同工作流的工具和节点。
如果团队已经明确知道「报价必须查库」,先把它写成确定的执行规则,通常比等待 Agent 答错后再修复更直接。
Rewire 更值得借鉴的场景,是工作流较多、错误反复出现,而且团队已有可信答案和历史样本。缺少这两个条件,自我修复很容易变成用不充分的证据批准下一次修改。
能拿来做什么
- 在 Node Agent 中记录节点跳转、工具是否可用及实际调用结果,让错误答案能沿执行路径追到根因,而不是只留下最终聊天文本。
- 把已经确认正确的历史对话整理成回放样本,每次修改指令或工具路由,都同时检查当前问题和已有行为。
- 建立修复记录时,将失败签名与业务内容分开保存;先用明确字段描述错误,再评估是否需要向量检索来支持跨流程复用。
- 对价格、费用等必须核实的数值,优先要求工具返回结果后再回答,并为查询失败设计明确分支,不让模型自行填补金额。