
HTTP性能优化上|HTTP协议篇
# HTTP性能优化上
30 秒速记
- HTTP 性能不是单一指标,应从请求方、服务方和两者之间的网络链路分别评估。
- 服务器侧关注单位时间处理量、同时承载能力和单次请求耗时。
- 客户端侧的核心体验指标是等待时间,需要拆解请求各阶段才能定位来源。
- 传输链路会同时受到距离、带宽、网络互通和接入条件影响,不能把慢请求全部归因于前端或服务端。
- 优化前必须明确观测对象和瓶颈位置;只改善其中一段,不保证端到端性能同步提升。
HTTP 性能要从客户端、服务器和传输链路一起看,本质上是定位端到端耗时到底花在哪一段。 一次请求会经历域名解析、连接建立、服务端排队与处理、首字节返回和响应体下载,只看总耗时很难判断根因。服务器更关心吞吐量、并发能力和响应时间,客户端更在意实际等待多久。比如 TTFB 偏高只能说明首字节前较慢,还要结合服务端日志和网络情况继续拆分,不能直接认定是后端代码问题。
“性能”其实是一个复杂的概念。不同的人、不同的应用场景都会对它有不同的定义。对于 HTTP 来说,它又是一个非常复杂的系统,里面有非常多的角色,所以很难用一两个简单的词就能把性能描述清楚。
还是从 HTTP 最基本的“请求 - 应答”模型来着手吧。在这个模型里有两个角色:客户端和服务器,还有中间的传输链路,考查性能就可以看这三个部分。
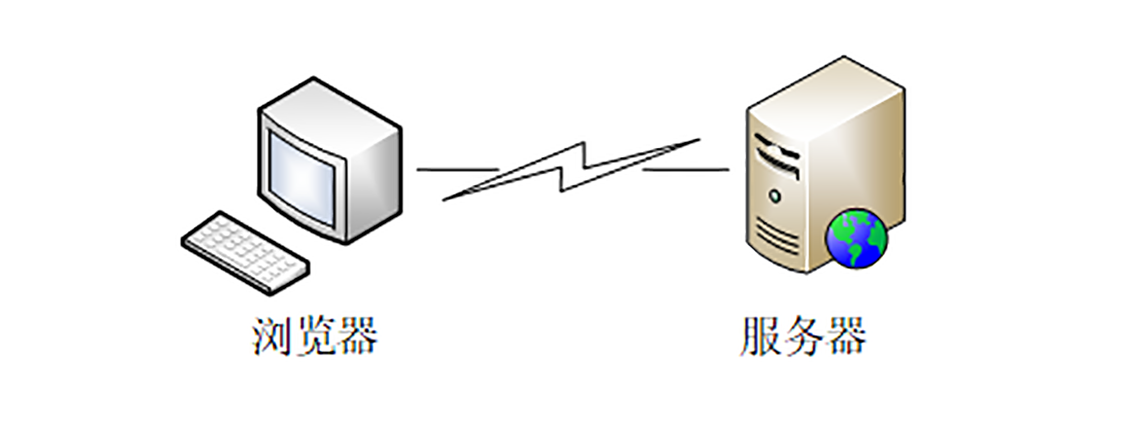
原理拆解: 一次请求的端到端耗时由多个阶段累积而成,包括域名解析、连接建立、发送请求、服务器排队与处理、首字节返回以及响应体下载。服务器的吞吐量、并发承载能力和单请求处理时间会互相影响;客户端看到的总等待时间还叠加了网络距离、带宽、丢包和连接复用情况。因此,只有拆分阶段指标,才能判断瓶颈位于客户端、服务端还是传输链路。
最小验证: 输入一个可访问的 HTTP 或 HTTPS 地址,使用 Node.js 18+ 运行以下脚本;它通过 PerformanceResourceTiming 不容易在纯脚本中跨环境稳定获取的连接细节,改用原生请求事件测量首字节与总耗时,验证“大部分时间发生在首字节之前还是响应体下载阶段”。
const http = require('node:http');
const https = require('node:https');
const { performance } = require('node:perf_hooks');

const target = new URL(process.argv[2] || 'https://example.com/');
const transport = target.protocol === 'https:' ? https : http;
const start = performance.now();
let firstByte;
let bytes = 0;

const req = transport.get(target, (res) => {
  res.once('data', (chunk) => {
    firstByte = performance.now();
    bytes += chunk.length;
  });
  res.on('data', (chunk) => {
    if (firstByte !== undefined) bytes += chunk.length;
  });
  res.on('end', () => {
    const end = performance.now();
    console.log({
      status: res.statusCode,
      ttfbMs: Number(((firstByte || end) - start).toFixed(1)),
      downloadMs: Number((end - (firstByte || end)).toFixed(1)),
      totalMs: Number((end - start).toFixed(1)),
      bytes
    });
  });
});
req.on('error', (error) => {
  console.error(error.message);
  process.exitCode = 1;
});
关键事件 data 首次触发时记录 TTFB,end 用于计算完整下载时间。预期输出包含状态码、首字节耗时、下载耗时和字节数;若 ttfbMs 高,问题可能位于连接、网络往返、服务端排队或处理阶段,不能仅凭该值继续细分。若 downloadMs 随响应大小显著增长,则应优先核查带宽、压缩和响应体体积。脚本中的首个数据块会被两个监听器观察,因此字节统计可能重复首块,不适合做精确流量计费,但不影响耗时分段结论。
边界与排查: 单次测量容易受到 DNS 缓存、连接复用、服务端冷启动和临时拥塞影响,应在相同网络条件下重复采样,并区分首次连接与复用连接。服务端指标正常也不能证明用户体验正常,例如跨地域访问可能被高往返时延限制;客户端总耗时下降也不代表服务器容量提高。工程验证应把客户端时间线、服务端访问日志与资源监控按请求标识和时间窗口关联,避免只优化某一段后误判整体收益。
面试官追问
追问 1监控显示接口服务端处理只用了很短时间,但上海用户看到总耗时明显更长;项目经理要求立刻扩容应用服务器,你会怎么回应?
暂不能据此扩容,服务端处理时间只是端到端链路的一段,用户等待还包含解析、建连、网络往返、排队、首字节和下载。应先把客户端时间线与服务端日志按请求标识关联;跨地域高时延或连接未复用时,扩容未必改善体验。
追问 2一个 HTTPS 下载接口返回大响应体,运维只给出“总耗时高”;你会采集哪些最小指标来判断首字节前慢还是下载慢?
至少记录请求开始、首次 data、响应结束和字节数,据此计算 TTFB、下载耗时与总耗时,并保留状态码。TTFB 高只能把范围缩到解析、建连、网络往返、排队或处理,不能继续武断归因;下载耗时随体积增长才优先检查带宽、压缩和响应体。
追问 3同一接口首次打开慢、连续刷新快,前端认为是服务端冷启动,后端认为是浏览器缓存;你会怎样设计对照采样?
应在相同网络条件下重复采样,并明确区分首次连接和复用连接,同时记录 DNS 缓存、服务端冷启动及临时拥塞可能造成的波动。再把客户端阶段指标与服务端日志对齐;只比较一次首次请求和一次刷新,无法排除连接复用等混杂因素。
追问 4线上告警显示 TTFB 突然升高,但应用处理耗时和机器资源都稳定;排查顺序怎么定?
先核对客户端与服务端时间窗口和请求标识,确认服务端记录是否覆盖排队时间,再检查解析、连接建立、网络往返、丢包及连接复用。应用指标稳定不能证明传输链路正常;仅凭高 TTFB 也无法区分连接、网络、排队和处理中的具体一项。
追问 5首页慢,前端主张压缩所有资源,网络团队主张升级带宽,后端主张加实例;在没有分段数据时你会批准哪个方案?
不会直接批准单一方案,应先把耗时拆为首字节前和响应体下载,并结合响应大小、吞吐、并发及服务端排队情况判断。下载阶段随体积增长才支持压缩或带宽方向,首字节前高则继续查连接与服务端;采集成本是必要代价。
追问 6压缩上线后客户端下载时间下降,但高峰期接口仍排队,团队宣称 HTTP 性能问题已经解决;这个结论为什么站不住?
下载阶段改善只说明响应体传输成本下降,不代表服务器吞吐、并发承载或排队能力同步提高。应继续关联客户端总耗时、服务端访问日志和资源监控;局部指标变好可能掩盖首字节前瓶颈,不能替代端到端验证。
# HTTP 服务器
30 秒速记
- 服务器性能主要看
RPS、并发数和单请求响应时间,分别反映处理产出、同时承载规模和处理速度。 - 响应时间下降通常有助于释放处理能力,从而改善吞吐量和并发承载,但三项指标不能互相替代。
- 压测必须同时观察
CPU、内存、磁盘和网卡,否则高RPS可能只是以资源耗尽为代价。 - 资源利用率并非越低越好:过高可能出现瓶颈,过低则可能说明容量闲置或压测没有施加有效负载。
- 在原文所述的
Linux环境中,可用ab -c 100 -n 10000施加固定并发和请求总量,并结合top、vmstat、sar等工具观察系统状态。
HTTP 服务器性能主要看 RPS、并发数和单请求响应时间,它们分别反映处理产出、承载规模和响应速度。 响应时间缩短通常能释放处理能力,但并不意味着吞吐量和并发数一定同步提高,所以这几个指标不能互相替代。压测时还要观察 CPU、内存、磁盘和网卡,否则较高的 RPS 可能只是资源接近耗尽的结果。在原文的 Linux 场景里,可以用 ab -c 100 -n 10000 施压,并结合 top、vmstat、sar 判断瓶颈。
我们先来看看服务器,它一般运行在 Linux 操作系统上,用 Apache、Nginx 等 Web 服务器软件对外提供服务,所以,性能的含义就是它的服务能力,也就是尽可能多、尽可能快地处理用户的请求。
衡量服务器性能的主要指标有三个:吞吐量(requests per second)、并发数(concurrency)和响应时间(time per request)。
吞吐量就是我们常说的 RPS,每秒的请求次数,也有叫 TPS、QPS,它是服务器最基本的性能指标,RPS 越高就说明服务器的性能越好。
并发数反映的是服务器的负载能力,也就是服务器能够同时支持的客户端数量,当然也是越多越好,能够服务更多的用户。
响应时间反映的是服务器的处理能力,也就是快慢程度,响应时间越短,单位时间内服务器就能够给越多的用户提供服务,提高吞吐量和并发数。
除了上面的三个基本性能指标,服务器还要考虑 CPU、内存、硬盘和网卡等系统资源的占用程度,利用率过高或者过低都可能有问题。
在 HTTP 多年的发展过程中,已经出现了很多成熟的工具来测量这些服务器的性能指标,开源的、商业的、命令行的、图形化的都有。
在 Linux 上,最常用的性能测试工具可能就是 ab(Apache Bench)了,比如,下面的命令指定了并发数 100,总共发送 10000 个请求
ab -c 100 -n 10000 'http://www.xxx.com'
系统资源监控方面,Linux 自带的工具也非常多,常用的有 uptime、top、vmstat、netstat、sar 等等,可能你比我还要熟悉,我就列几个简单的例子吧:
top             # 查看 CPU 和内存占用情况
vmstat  2       # 每 2 秒检查一次系统状态
sar -n DEV 2    # 看所有网卡的流量,定时 2 秒检查
理解了这些性能指标,我们就知道了服务器的性能优化方向:合理利用系统资源,提高服务器的吞吐量和并发数,降低响应时间。


