二叉搜索树是二叉树的特例,平衡二叉树则是二叉搜索树的特例。
# 什么是平衡二叉树
30 秒速记
- 高度平衡 = 每个结点左右子树高度差 ≤
1,是「每个」,不是只看根 AVL树 = 平衡 +BST;LeetCode 110只判平衡,不要求是BST- 高度从下往上汇总 → 用后序遍历,一边算高度一边判断
- 空树高度记
0,叶子记1,统一口径才不会差一
平衡二叉树就是每个结点的左右子树高度最多差 1,严格说带上 BST 性质的才叫 AVL 树。 重点在「每个结点」:根左右各有三层看着挺平衡,但下面某个结点一边三层一边空,整棵树就不算平衡。刷题时要分清两个概念,LeetCode 110 只判断高度条件,不检查大小顺序;真正讲 AVL 的时候,是在 BST 之上再加平衡约束,目的是把树高压在 O(log n)。
在上一节的末尾,我们已经通过一道真题和平衡二叉树打过交道。正如题目中所说,平衡二叉树(又称 AVL Tree)指的是任意结点的左右子树高度差绝对值都不大于1的二叉搜索树。
面试官追问
追问 1根结点左右子树高度一样,这棵树一定平衡吗?
不一定。比如左右各是一条长 3 的链,根是平衡的,但链上的结点一边高 2 一边是 0,已经不平衡了。
追问 2平衡二叉树和完全二叉树什么关系?
完全二叉树一定是平衡的,反过来不成立。平衡只限制高度差,最后一层可以不从左往右连续。
追问 3AVL 和红黑树都是平衡树,差在哪?
AVL 要求高度差 ≤ 1,更严格,查找更快,但插删时旋转更多。红黑树只保证最长路径不超过最短的两倍,插删调整少,所以 Java 的 TreeMap、C++ 的 std::map 都用红黑树。
追问 4n 个结点的 AVL 树最高有多高?
约 1.44 log2(n),还是 O(log n)。这就是它敢承诺查找最坏也是对数级的依据。
# 为什么要有平衡二叉树
30 秒速记
- 同一组数可以建出很多种
BST,形状决定效率 - 平衡时每比一次排除一半 →
O(log n);退化成链 →O(n) - 例子:
[1..5]平衡树找1要3次,右斜链要5次 - 有序或近乎有序的插入最容易退化,真实数据里很常见
- 平衡的代价:结点多存高度/颜色,插删时要旋转
平衡二叉树就是为了防止 BST 长歪,长歪了二分的优势就没了。 BST 快是因为每比较一次就能扔掉一半,但这有前提,就是两边差不多大。同样是 1 到 5,平衡的树找 1 比 3 次,一条往右斜的链要比 5 次,数据量上去差距就是 log n 和 n 的差别。偏偏现实里顺序插入很常见,比如按自增 id 插。所以平衡树多做一点旋转,换来最坏情况也稳在 O(log n)。
平衡二叉树的出现,是为了降低二叉搜索树的查找时间复杂度。
大家知道,对于同样一个遍历序列,二叉搜索树的造型可以有很多种。拿 [1,2,3,4,5]这个中序遍历序列来说,基于它可以构造出的二叉搜索树就包括以下两种造型:
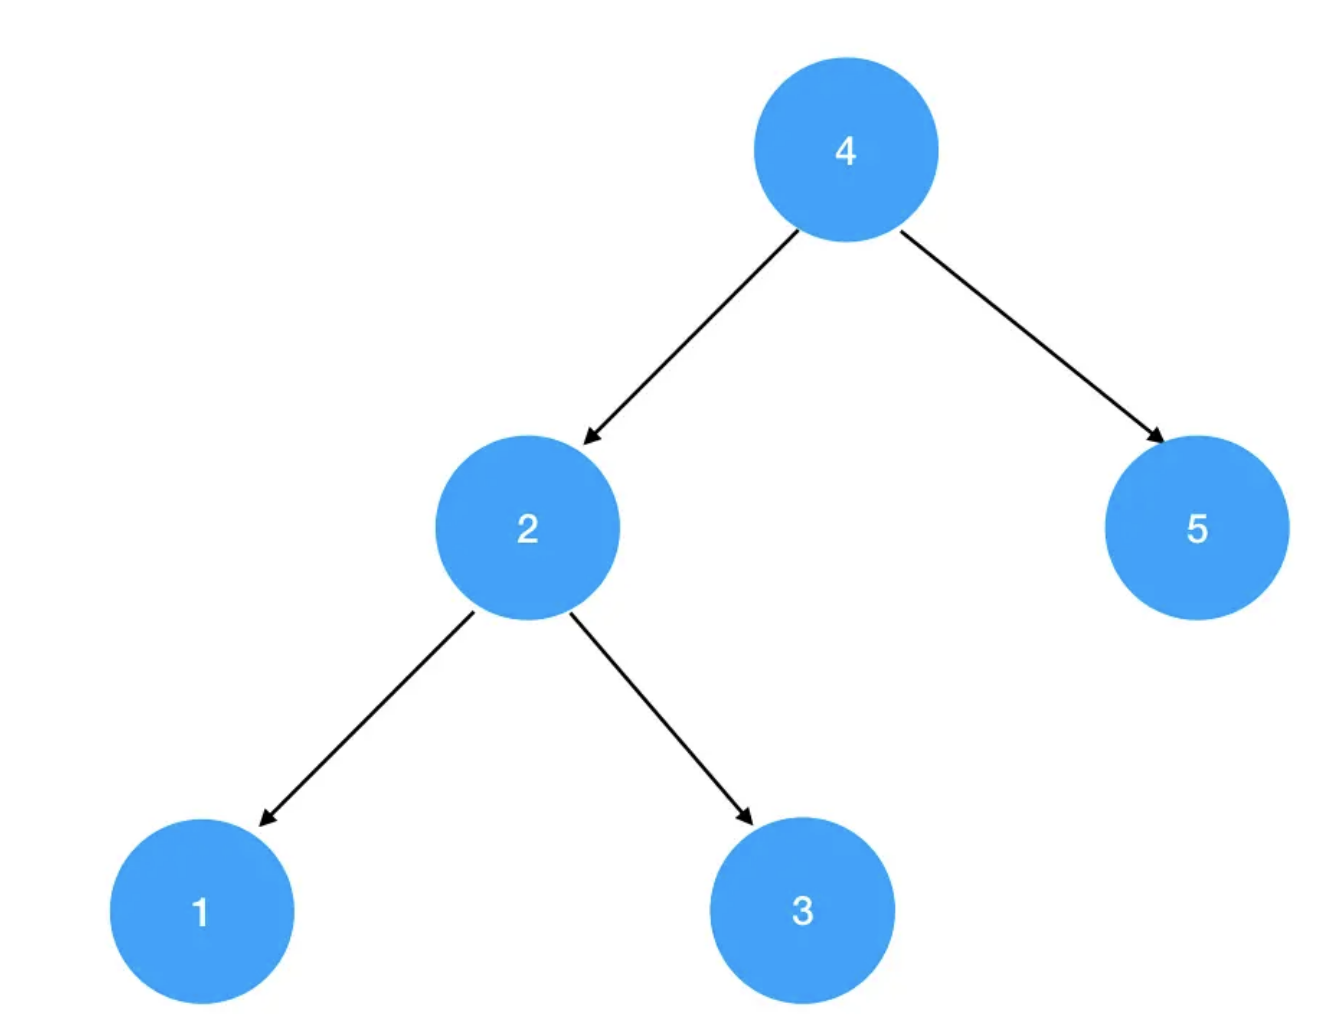
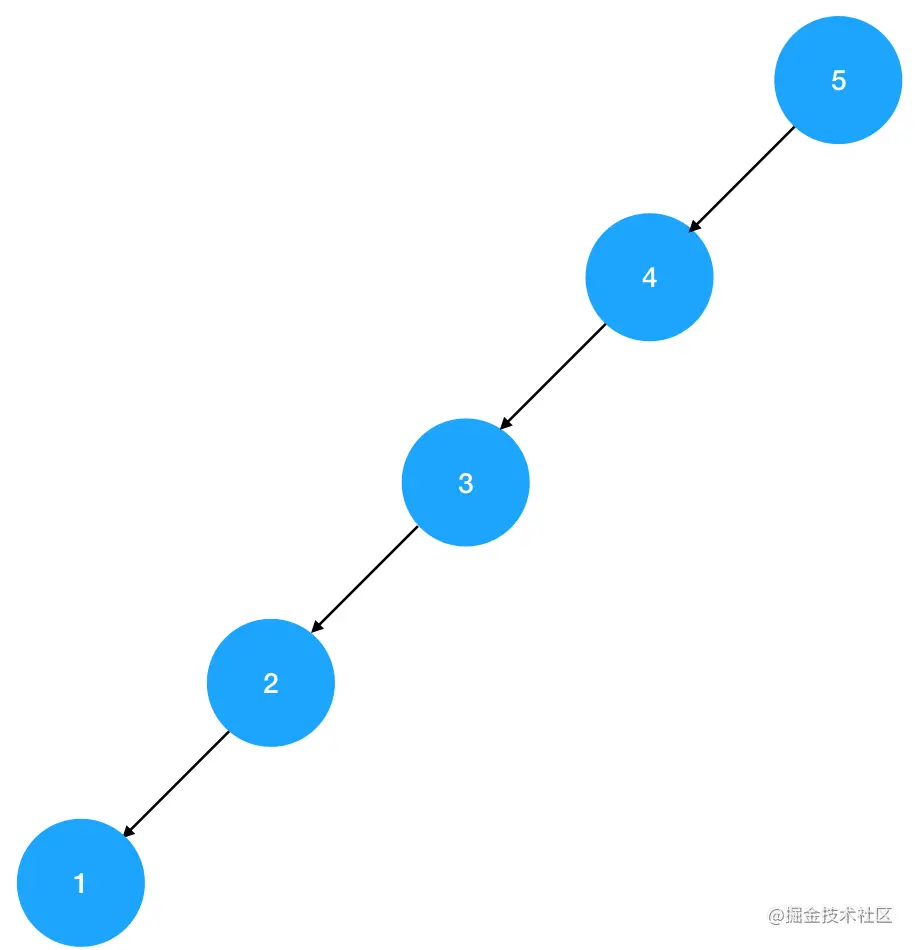
结合平衡二叉树的定义,我们可以看出,第一棵二叉树是平衡二叉树,第二棵二叉树是普通的二叉搜索树。
现在,如果要你基于上一节学过的二叉搜索树查找算法,在图上两棵树上分别找出值为1的结点,问你各需要查找几次?在1号二叉树中,包括根结点在内,只需要查找3次;而在2号二叉树中,包括根结点在内,一共需要查找5次。
我们发现,在这个例子里,对于同一个遍历序列来说,平衡二叉树比非平衡二叉树(图上的结构可以称为链式二叉树)的查找效率更高。这是为什么呢?
大家可以仔细想想,为什么科学家们会无中生有,给二叉树的左右子树和根结点之间强加上排序关系作为约束,进而创造出二叉搜索树这种东西呢?难道只是为了装x吗?当然不是啦。二叉搜索树的妙处就在于它把“二分”这种思想以数据结构的形式表达了出来。在一个构造合理的二叉搜索树里,我们可以通过对比当前结点和目标值之间的大小关系,缩小下一步的搜索范围(比如只搜索左子树或者只搜索右子树),进而规避掉不必要的查找步骤,降低搜索过程的时间复杂度。但是如果一个二叉搜索树严重不平衡,比如说上面这棵链式搜索树:
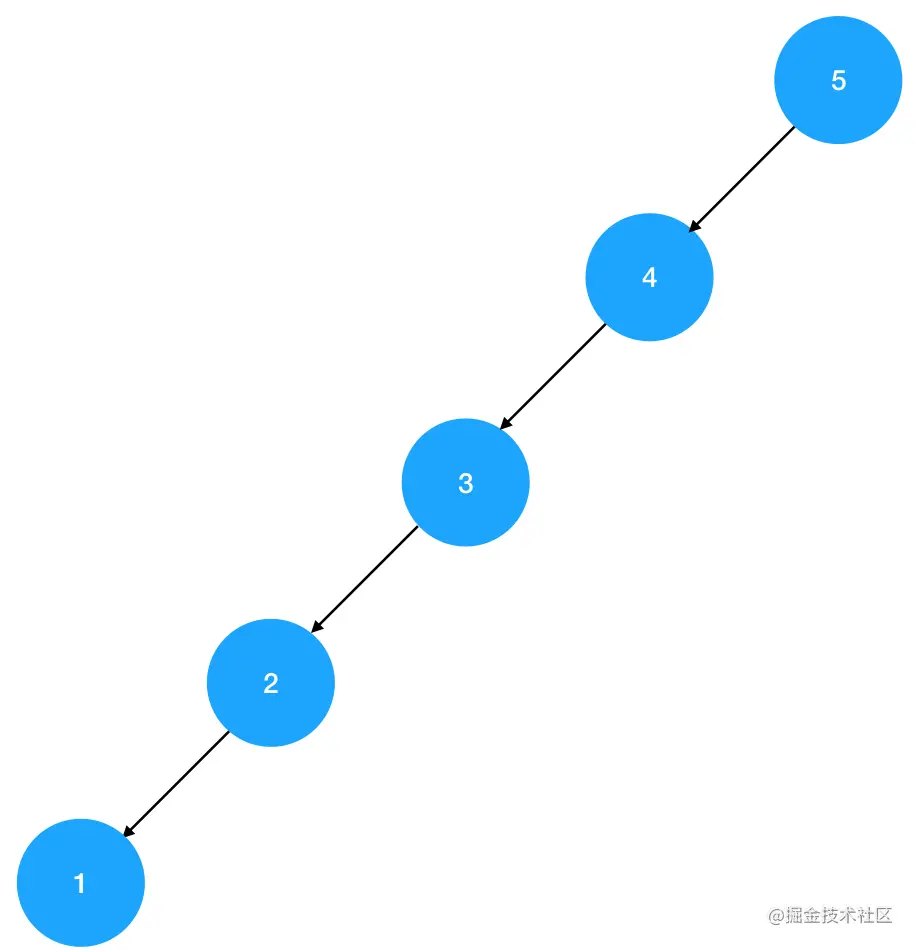
每一个结点的右子树都是空的,这样的结构非常不合理,它会带来高达O(N)的时间复杂度。而平衡二叉树由于利用了二分思想,查找操作的时间复杂度仅为 O(logN)。因此,为了保证二叉搜索树能够确实为查找操作带来效率上的提升,我们有必要在构造二叉搜索树的过程中维持其平衡度,这就是平衡二叉树的来由。
面试官追问
追问 1100 万条数据,平衡和退化各要比较多少次?
平衡约 20 次(2^20 ≈ 100 万),退化成链最坏 100 万次。差了五万倍,这就是为什么要平衡。
追问 2什么样的数据最容易把普通 BST 搞退化?
有序或接近有序的,比如按时间戳、自增 id 插入。每次都比前一个大,全挂到右边。
追问 3为了避免退化,把插入顺序打乱可以吗?
数据一次性给全时可以,随机打乱后期望高度是 O(log n)。但数据是一条条实时进来的就控制不了顺序,只能靠自平衡。
追问 4数据库索引为什么不用平衡二叉树?
二叉树太高,100 万条要 20 层,每层可能一次磁盘读。B+ 树一个结点存几百个键,三四层就够了,磁盘 IO 少得多。
# 命题思路解读
30 秒速记
- 平衡树真题两类:判断是否平衡(
LeetCode 110)、把BST变平衡(LeetCode 1382) - 判断:后序遍历,子树先返回高度,父结点再比较
- 自顶向下每个结点都重新算高度 → 最坏
O(n²);后序一次返回 →O(n) - 用
-1表示「已经不平衡」,一路往上透传,提前结束 - 用全局
flag也对,但-1写法不用外部状态
判断平衡要用后序遍历,因为父结点得先知道左右子树多高,才能判断自己平不平衡。 最容易写出来的是对每个结点调一次求高度的函数,结果下面的子树被反复算,最坏 O(n²)。后序就一遍:左右子树先把高度报上来,父结点比一比,差超过 1 就返回 -1,祖先收到 -1 直接往上传,不用再算。时间 O(n),空间是递归栈 O(h)。用一个外部 flag 也能写,思路一样,但我更喜欢 -1 这种写法,函数没有副作用。
回答参考:“我用后序遍历,因为父节点必须先知道左右子树高度。返回正常高度或 -1,把计算高度和判断平衡合并成一次遍历。”
function isBalanced(root) {
  function height(node) {
    if (!node) return 0
    const left = height(node.left)
    if (left === -1) return -1
    const right = height(node.right)
    if (right === -1 || Math.abs(left - right) > 1) return -1
    return Math.max(left, right) + 1
  }
  return height(root) !== -1
}
面试官追问
追问 1对每个结点都调 height(node.left) 和 height(node.right),为什么慢?
底层的结点会被每一个祖先重复算一遍。链状树上就是 n + (n-1) + ... = O(n²),后序一次汇总就只走一遍。
追问 2为什么用 -1 当不平衡的标记?
合法高度最小是 0,-1 不会和正常值冲突。父结点看到任意一边是 -1 就直接返回,相当于短路。
追问 3全局 flag 写法置成 false 之后 return 0,会不会算错?
结果不会错,flag 一旦是 false 就不会再变回来,返回的高度已经没人关心了。只是它后面还会继续递归其他分支,!flag 那个判断只能在进入时剪掉一部分。
追问 4这道题需要检查 BST 性质吗?
不需要,LeetCode 110 只看高度差。如果题目问的是「是不是 AVL 树」,就要再加一遍上下界验证。
平衡二叉树和二叉搜索树一样,都被归类为“特殊”的二叉树。对于这样的数据结构来说,其“特殊”之处也正是其考点所在,因此真题往往稳定地分布在以下两个方向:
- 对特性的考察(本节以平衡二叉树的判定为例)
- 对操作的考察(本节以平衡二叉树的构造为例)
平衡二叉树的判定 题目描述:给定一个二叉树,判断它是否是高度平衡的二叉树。
本题中,一棵高度平衡二叉树定义为: 一个二叉树每个节点 的左右两个子树的高度差的绝对值不超过1。
示例 1:
给定二叉树 [3,9,20,null,null,15,7]
    3
   / \
  9  20
    /  \
   15   7
返回 true 。
示例 2:
给定二叉树 [1,2,2,3,3,null,null,4,4]
       1
      / \
     2   2
    / \
   3   3
  / \
 4   4
返回 false 。
思路分析 来,我们复习一遍平衡二叉树的定义:
平衡二叉树是任意结点的左右子树高度差绝对值都不大于1的二叉搜索树。
抓住其中的三个关键字:
- 任意结点
- 左右子树高度差绝对值都不大于1
- 二叉搜索树
注意,结合题意,上面3个关键字中的3对这道题来说是不适用的,因此我们不必对二叉搜索树的性质进行校验。现在只看 1 和 2,先给自己一分钟思考一下——你可以提取出什么线索?