学 Python 的时候我记了一堆零散的笔记,后来发现真正卡住我的不是某个语法怎么写,而是脑子里没有一张地图。比如知道 list 能改、tuple 不能改,但说不清为什么字典的 key 必须用不可变类型;知道装饰器加个 @ 就能用,但换个带参数的场景就懵了。这篇是把当时画的一整套思维导图重新串了一遍,从初识 Python 一路走到并发和应用领域,每张图前面说清楚它在讲什么,后面补一句最容易记混的地方在哪。
这篇偏「结构」,配套的Python基础小结(一)偏「细节」,那篇里有可以直接跑的代码、内建函数表和标准库清单,两篇搭配着看效率会高一些。
在本篇文章中,我们将从浅入深,和大家一起学习以下知识:
- Python 是什么语言,它的执行方式和别的语言差在哪
- 变量、运算符这些语法地基,以及缩进为什么被写进语法
- 字符串的创建、拼接、转义和切片,为什么它是不可变类型
- 列表、元组、字典这三种容器分别适合什么场景
- 函数与流程控制的写法,以及 Python 里没有
switch这件事 - 类的定义、属性和方法,私有成员到底私有到什么程度
- 高级特性六件套:切片、迭代、生成器、
yield、闭包、装饰器 - 标准库里最常用的几个模块和它们的典型用途
- Python 并发的三条路和 GIL 带来的限制
- Python 在爬虫、数据分析这些方向上的实际落点
# 一、初识 Python
先从最外层说起。Python 是解释型语言,源码交给解释器逐行翻译执行,不像 C 那样先编译成机器码再跑。好处是改完就能跑、跨平台成本低,代价是执行速度比编译型语言慢一截。
这张图把 Python 的身世、特点和适用范围一次讲完。
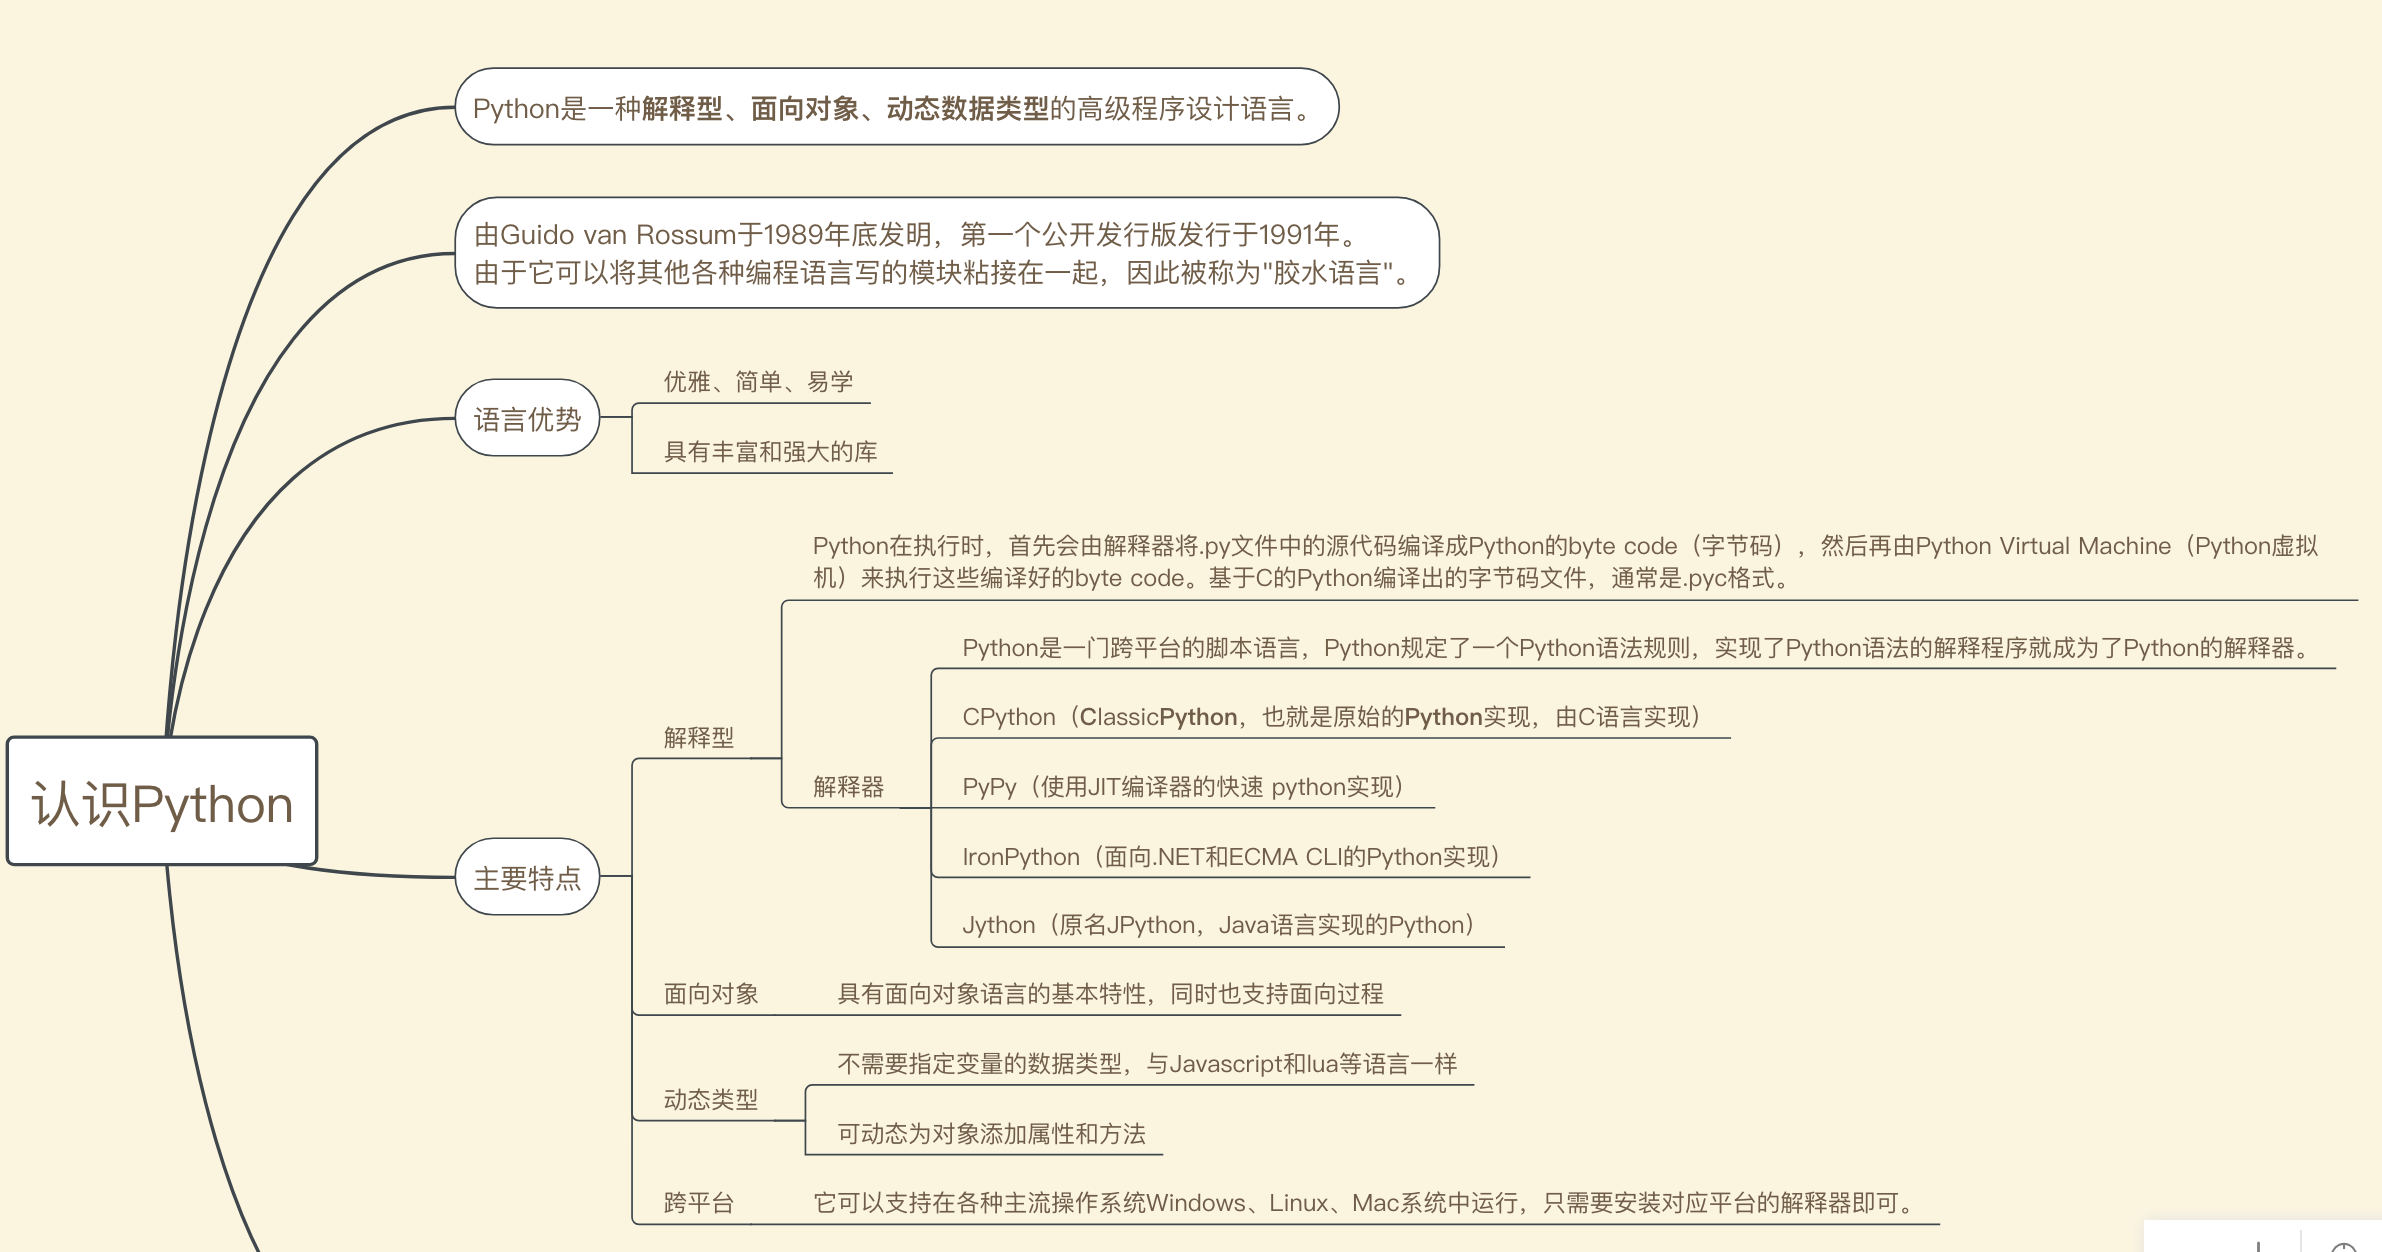
图里最该记住的是「胶水语言」这个定位。Python 自己跑得不快,但它能很轻松地把 C/C++ 写的高性能模块包起来调用,所以做数据分析时你写的是 Python,底下真正干活的是 NumPy 里的 C 代码。这也解释了一个初学者常见的困惑,既然 Python 慢,为什么机器学习都用它?因为慢的那部分早就被换掉了。
# 二、语法基础
# 2.1 变量与运算符
语法这一层没什么捷径,就是把地基铺平。先看整体轮廓。
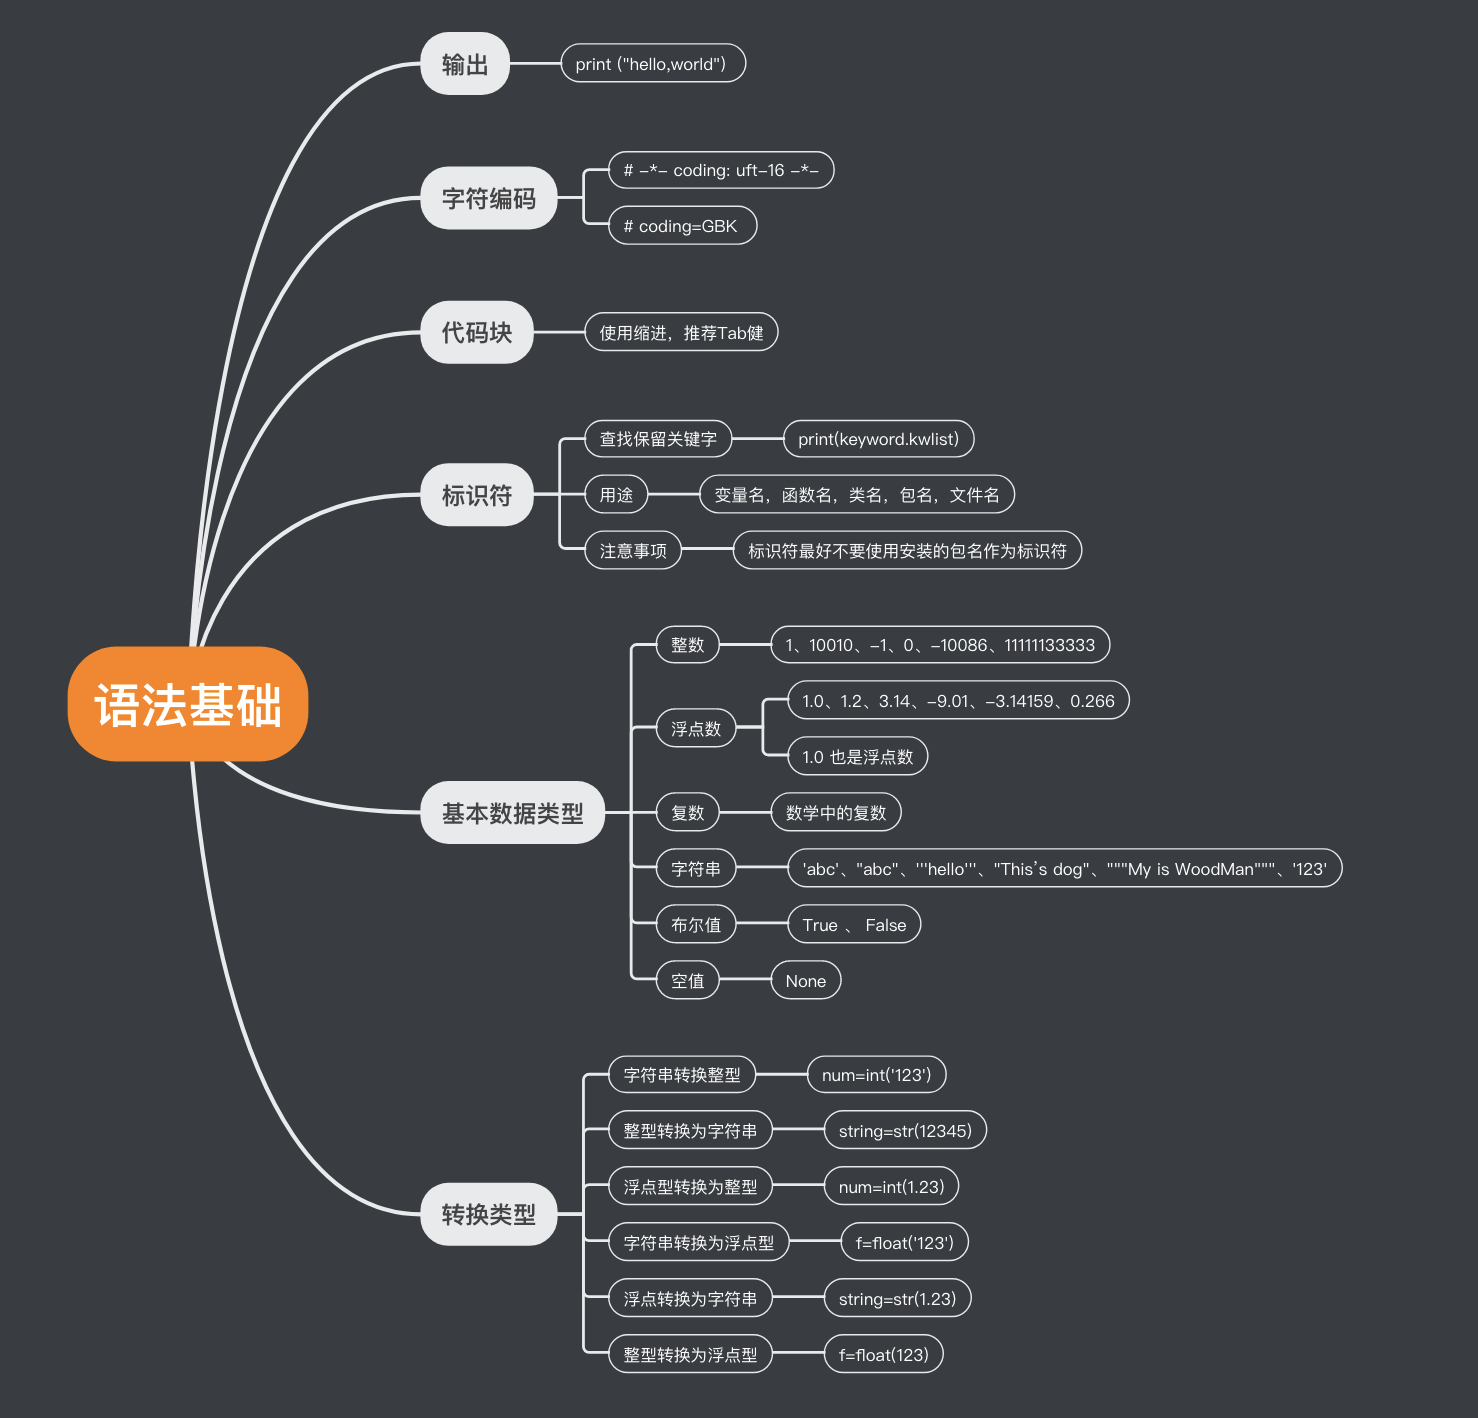
这张图里的缩进部分值得多看两眼。别的语言用花括号划分代码块,Python 直接把缩进写进了语法,缩进错了就是语法错误而不是风格问题。好处是所有人写出来的代码长得差不多,坏处是复制粘贴代码时特别容易踩到 Tab 和空格混用的坑,官方推荐统一用 4 个空格。
接下来是变量。
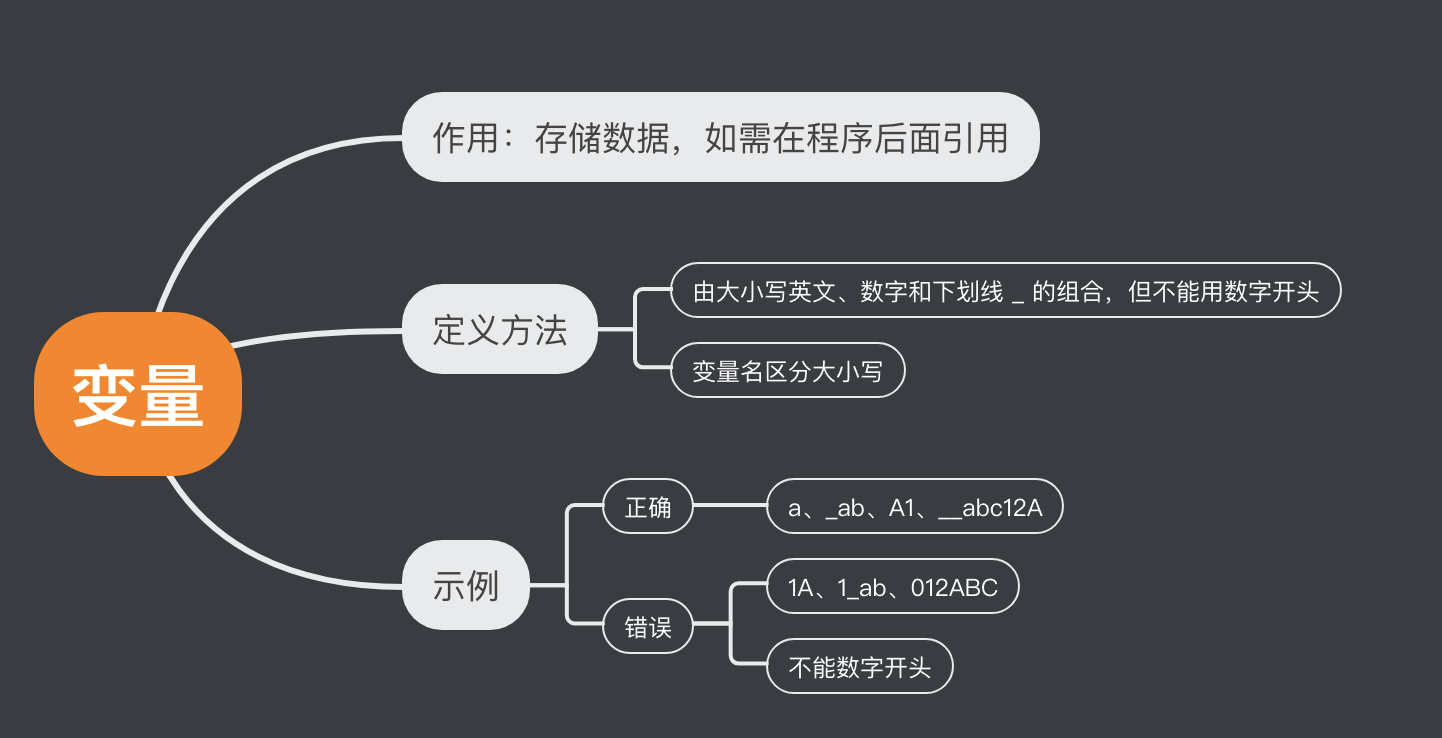
Python 的变量不用声明类型,a = 1 之后再写 a = 'hello' 也完全合法。这里有个坑要注意,Python 里的变量更像是贴在对象上的标签,而不是一块装着值的内存。所以 b = a 之后改 a 指向的可变对象,b 看到的也变了,很多人第一次被列表「莫名其妙」修改就是栽在这。
再看运算符。
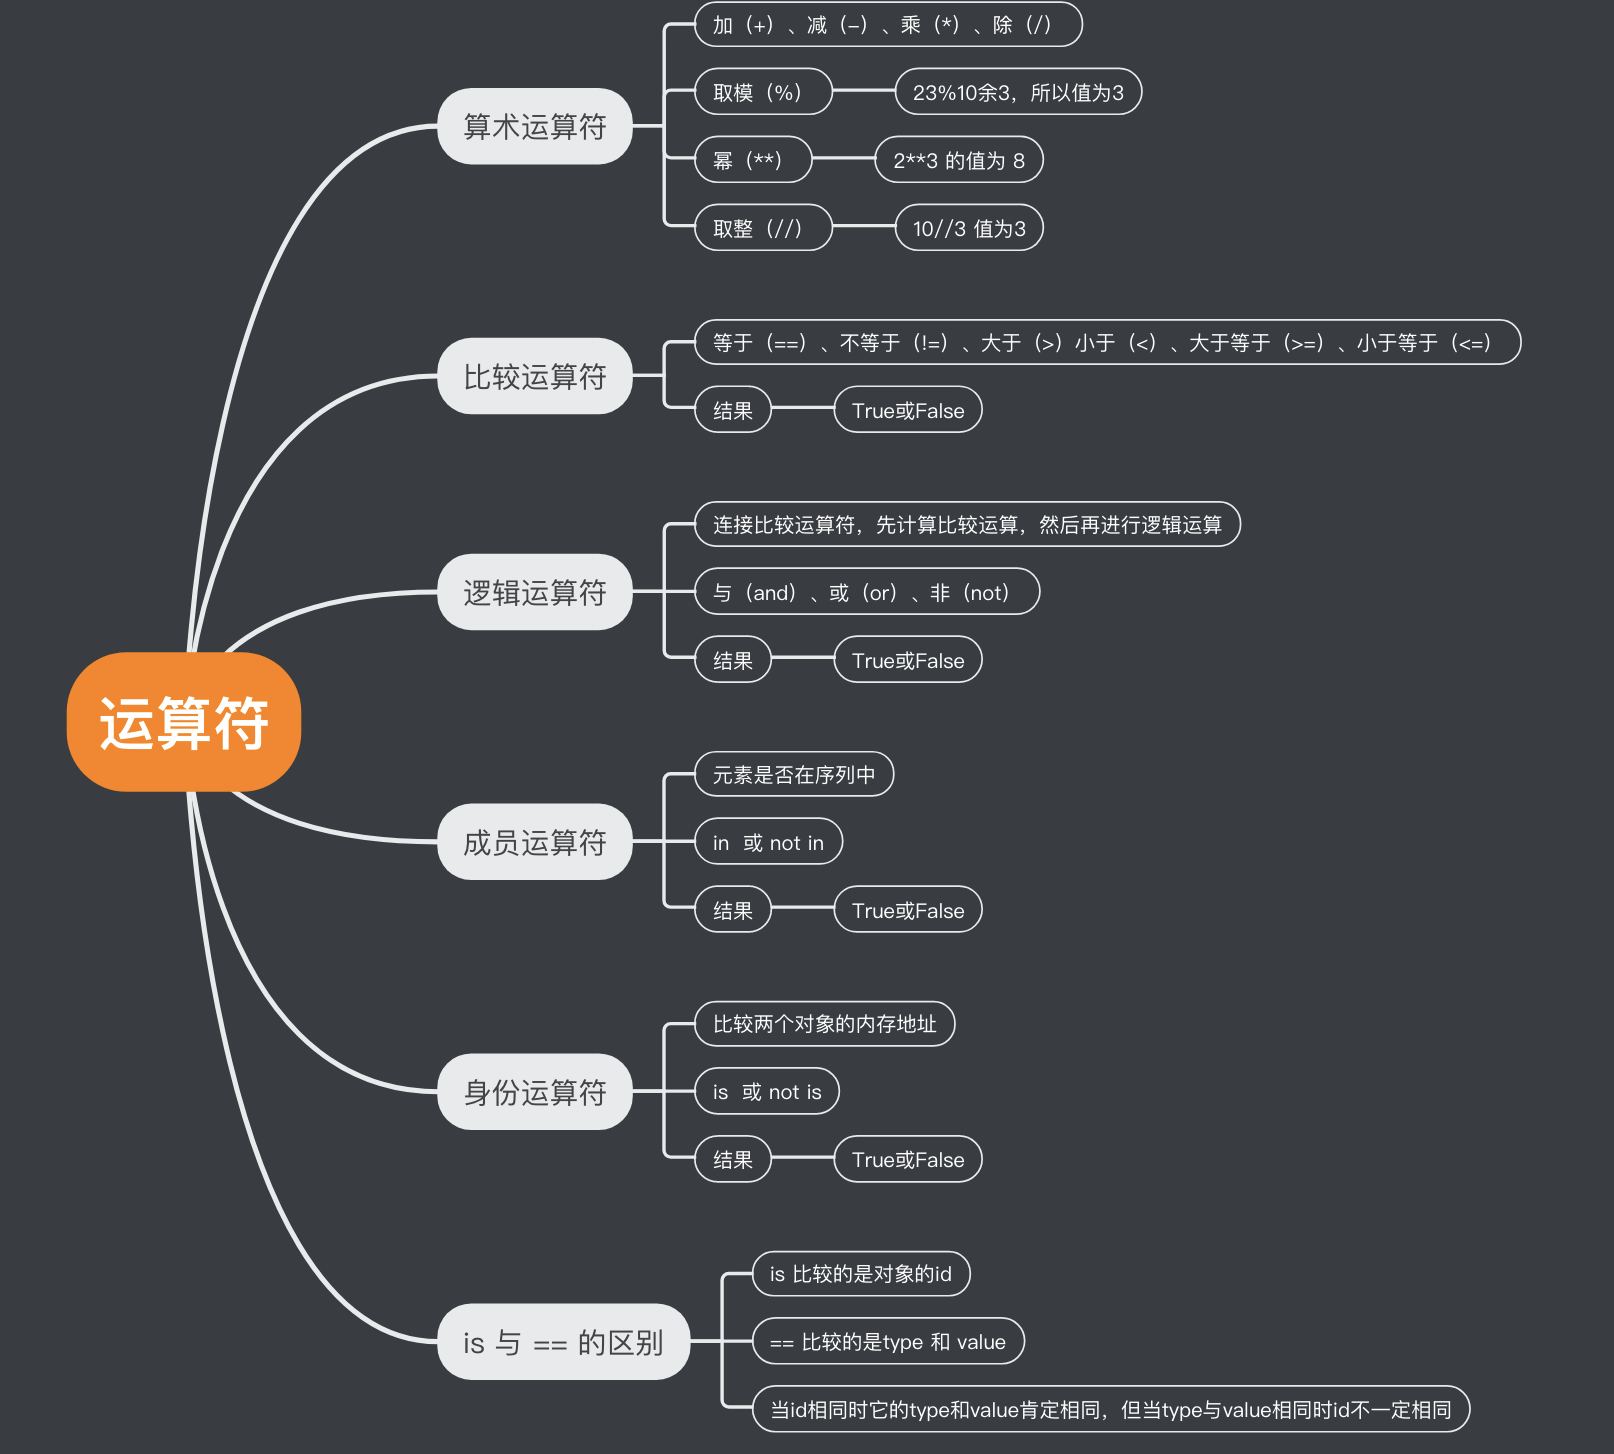
算术运算符里最容易记混的是 / 和 //。在 Python 3 里 1 / 2 得到的是 0.5,类型是 float,哪怕两边都是整数;要取整必须用 1 // 2,结果是 0。Python 2 的行为和这个不一样,网上老教程里抄来的代码在这一点上经常翻车。
# 2.2 字符串处理
字符串是用得最多的类型,图也最多,一张张过。
先是创建。
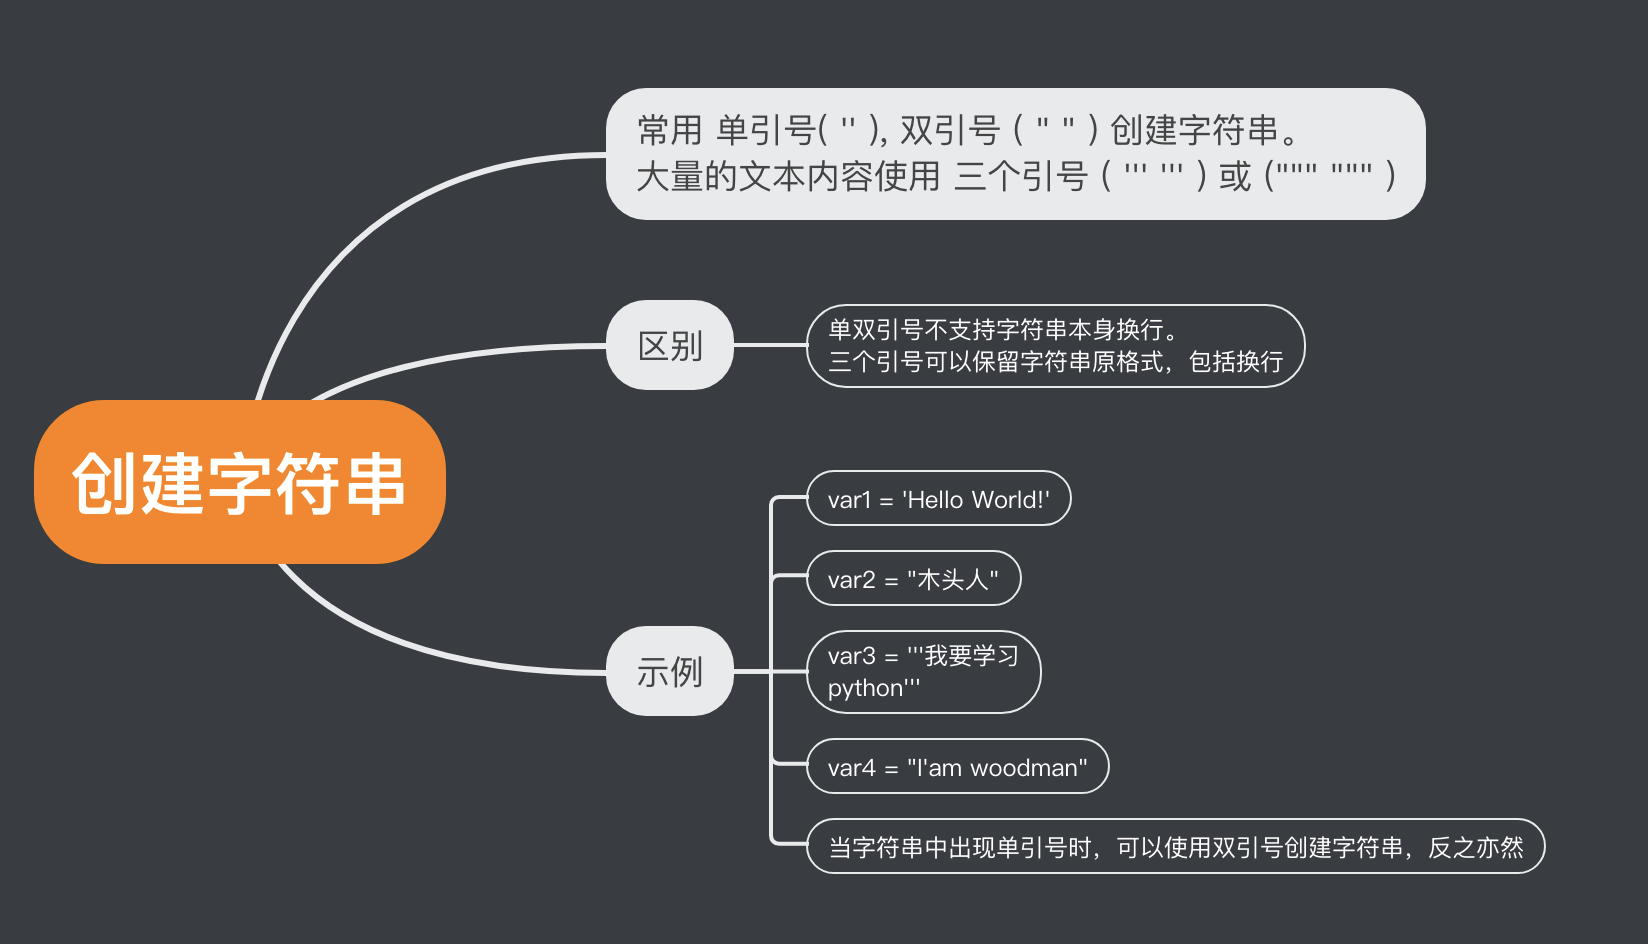
单引号和双引号在 Python 里没有区别,选哪个纯看内容里有没有引号需要躲开。三引号可以跨行,既能写长文本也常被当成多行注释用。
然后是拼接。
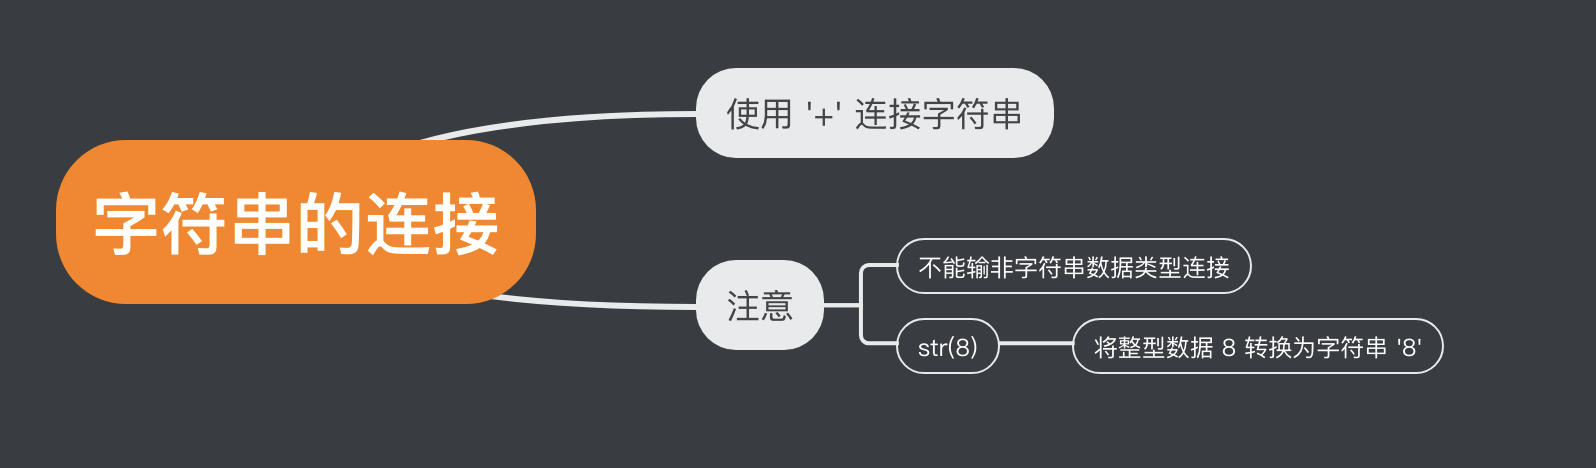
+ 拼接直观,但在循环里拼几万次会很慢。原因是字符串不可变,每次 + 都在生成一个新对象,旧的当垃圾扔掉。要拼大量片段就用 ''.join(列表),一次性分配。
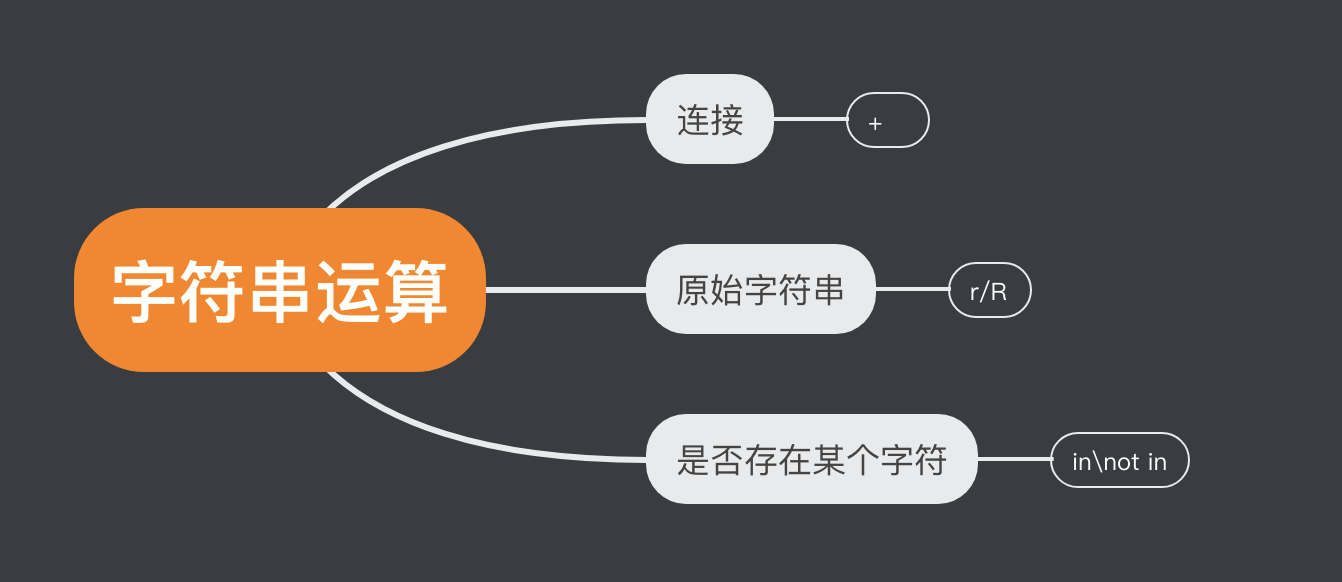
* 号重复这个写法挺舒服的,画分隔线时 '-' * 40 比循环干净多了。
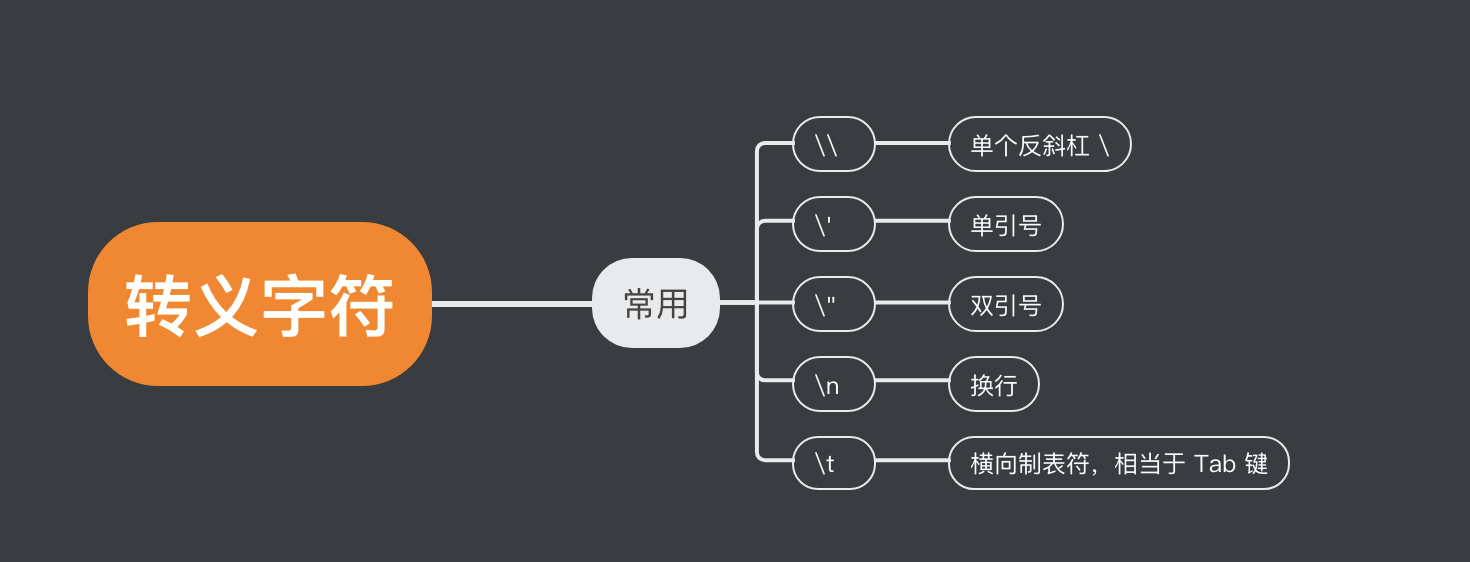
转义这块和正则一起用的时候最容易出问题。写正则时习惯性在字符串前加 r 变成原始字符串,r'\d+' 里的反斜杠就不会被当成转义符先吃掉一层。
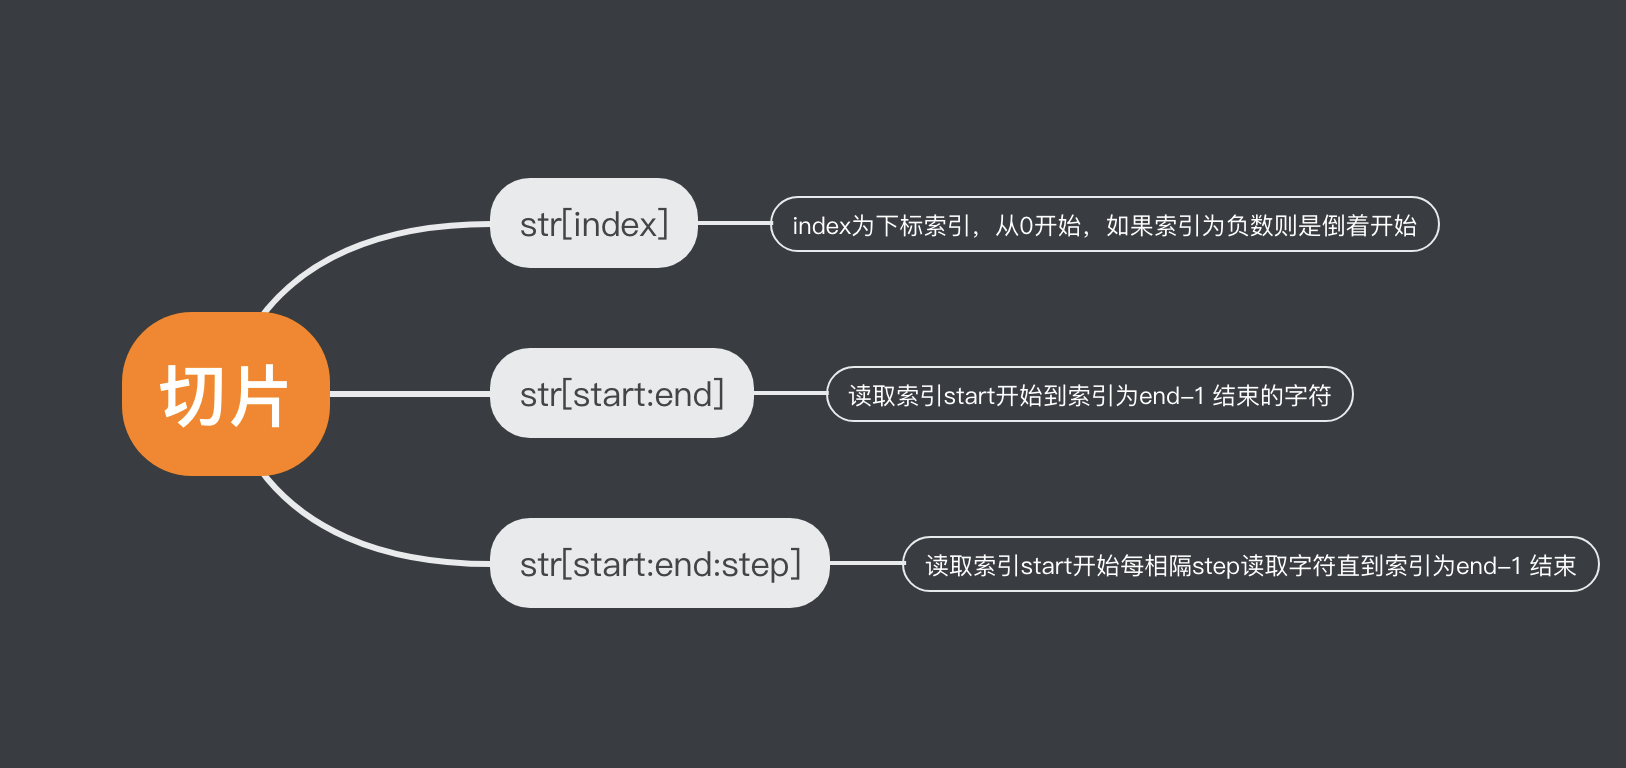
切片是 Python 里最舒服的设计之一,s[start:end:step] 三个参数都可以省。记住区间是左闭右开,s[0:3] 拿的是前三个字符不含下标 3。负数下标从右往左数,s[::-1] 是反转字符串的常见写法。
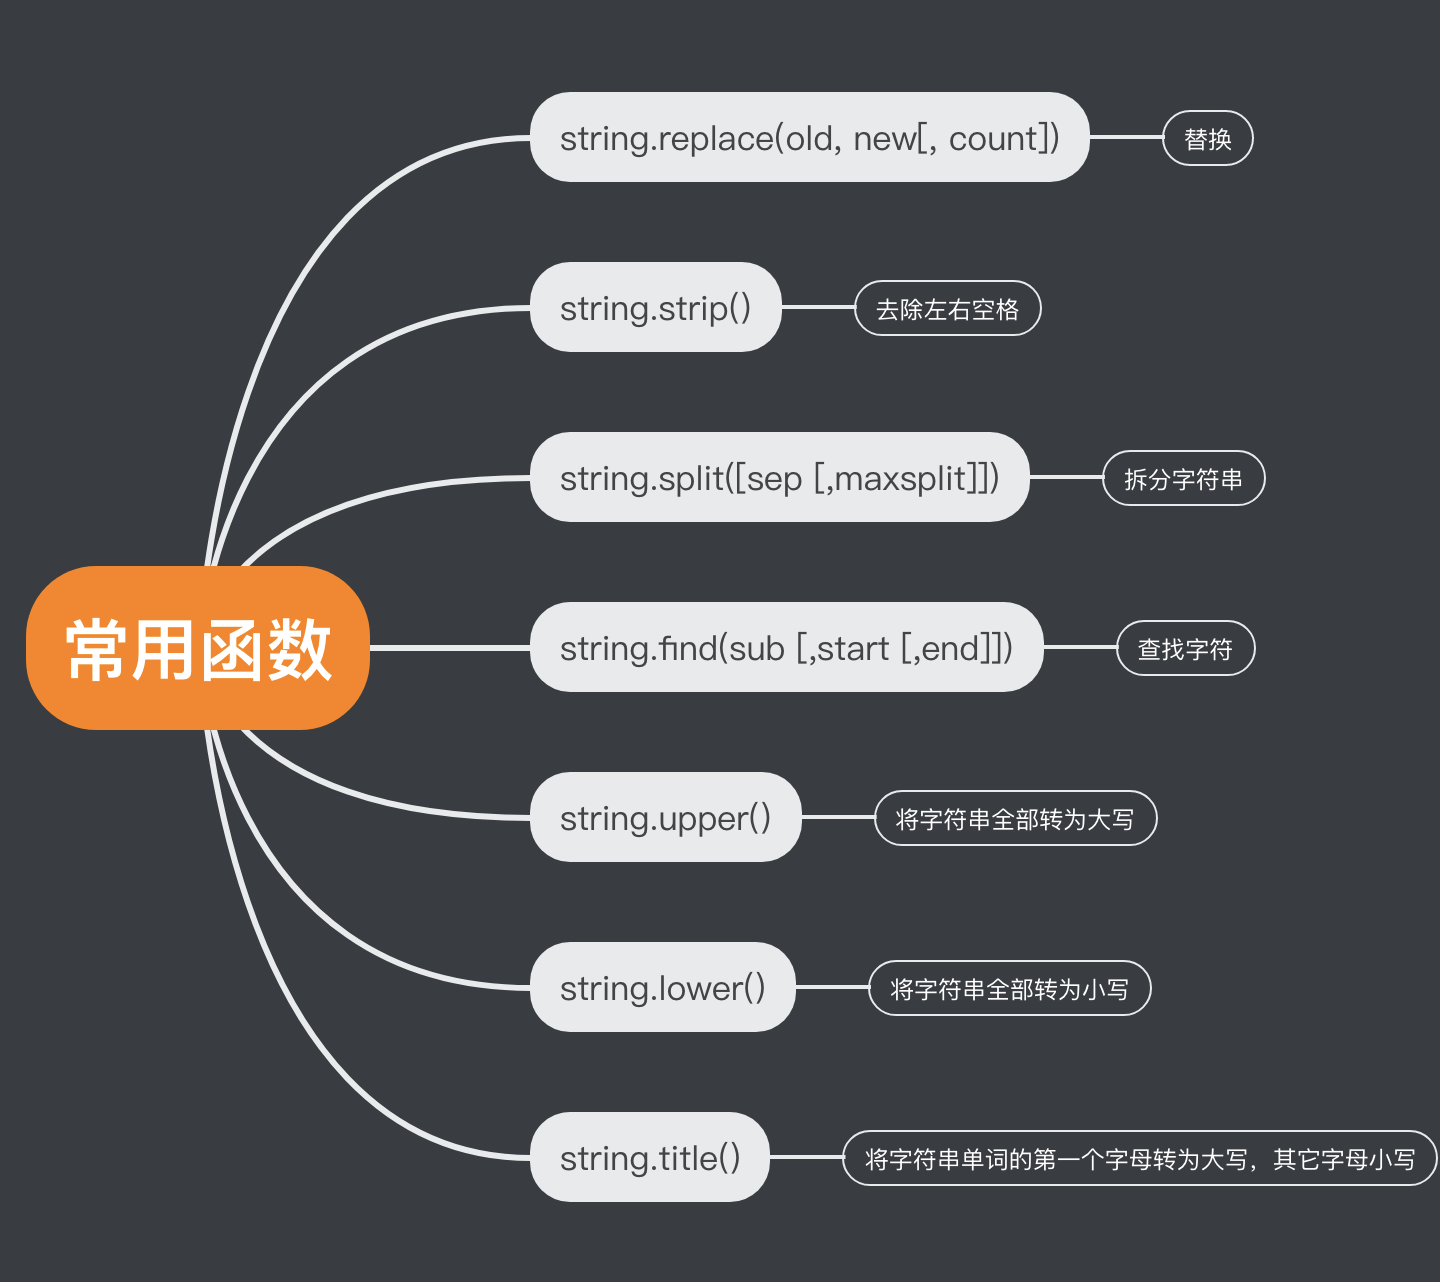
这些方法全都返回新字符串,不会在原地改。所以 s.upper() 单独写一行是没用的,必须接住返回值。这个我踩过,调试半天才发现是自己没赋值回去。
# 2.3 列表
列表是可变的有序容器,日常用得最多。
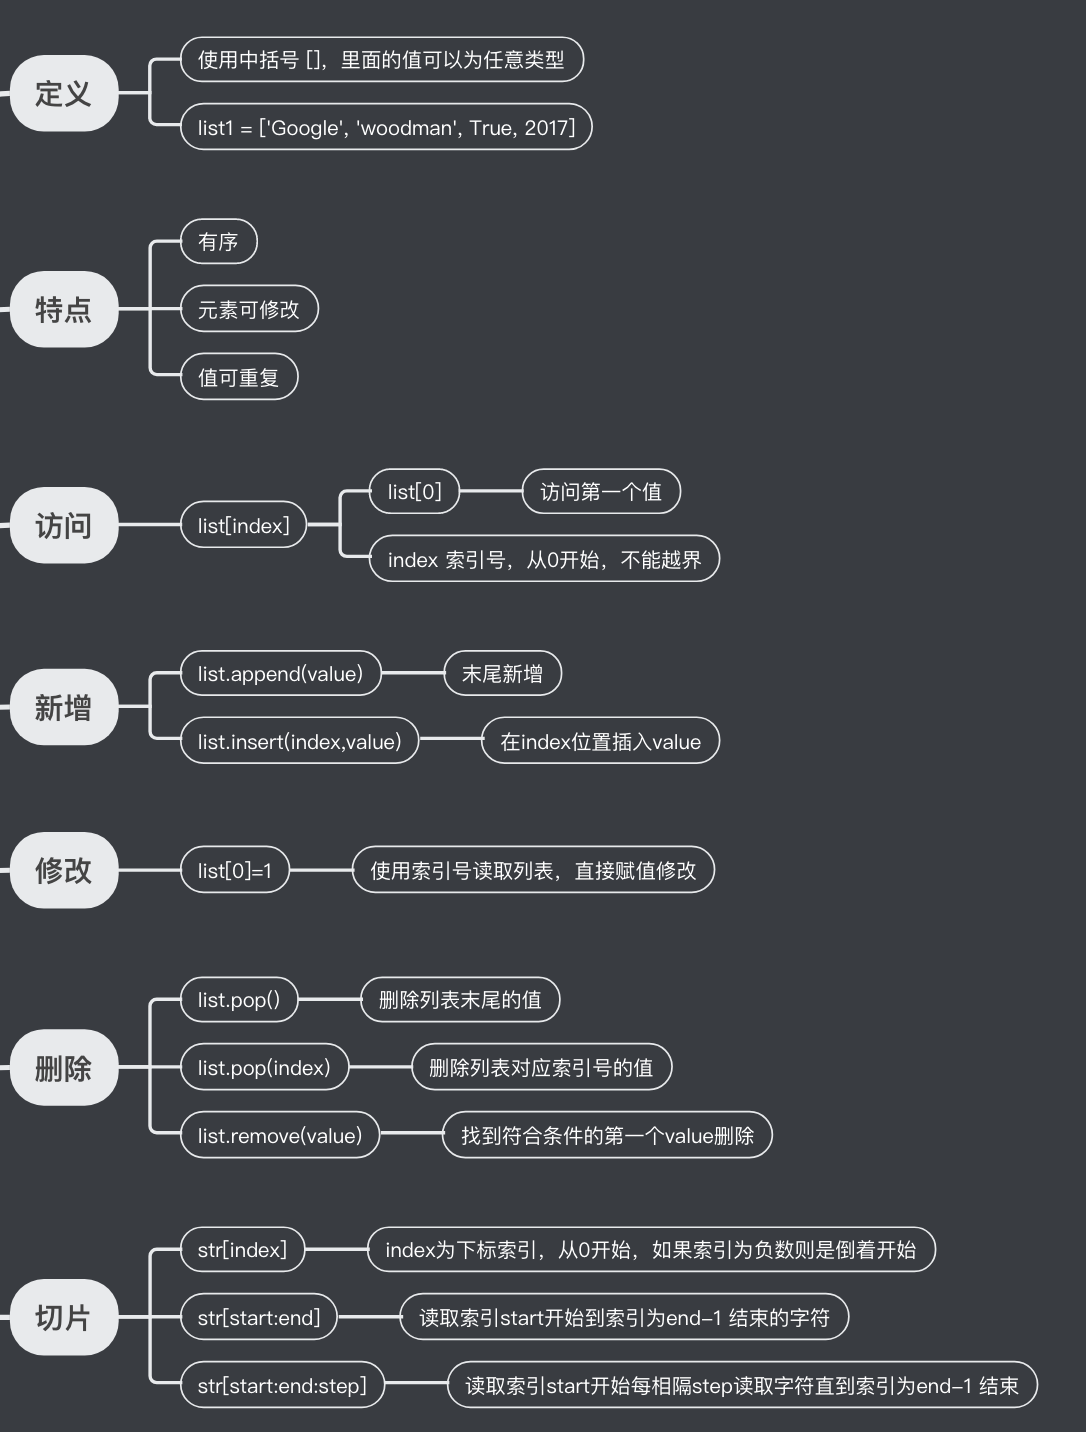
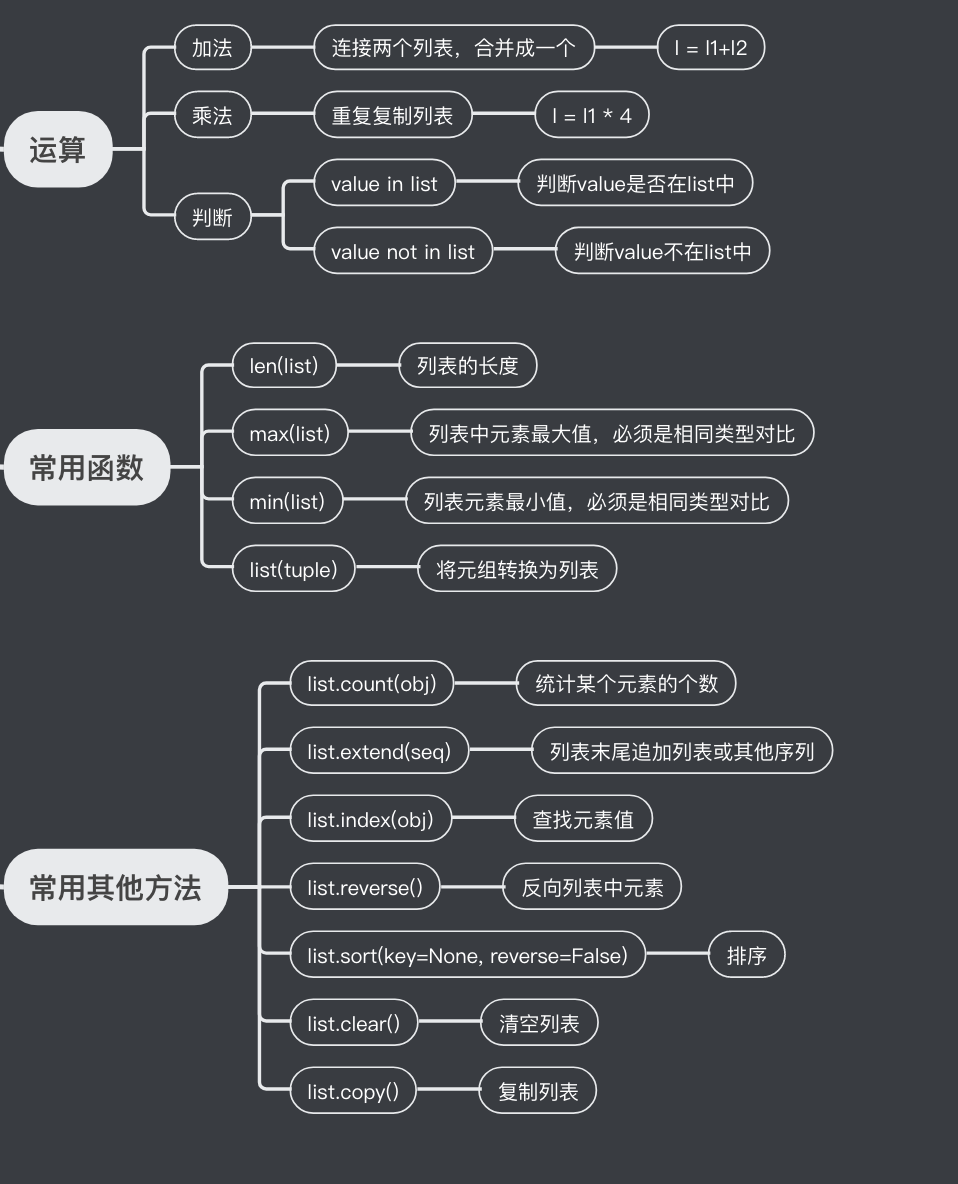
这两张图里的方法分两类要分清楚。append、insert、remove、sort 这些是原地修改,返回 None;sorted(列表) 才是返回新列表。写 a = a.sort() 之后发现 a 变成 None,是新手最经典的一次翻车。
另外一个坑是在遍历列表的同时删元素,下标会错乱,正确做法是新建一个列表装筛选结果,或者用列表推导式。
# 2.4 元组
元组和列表长得像,区别只有一个字:不可变。
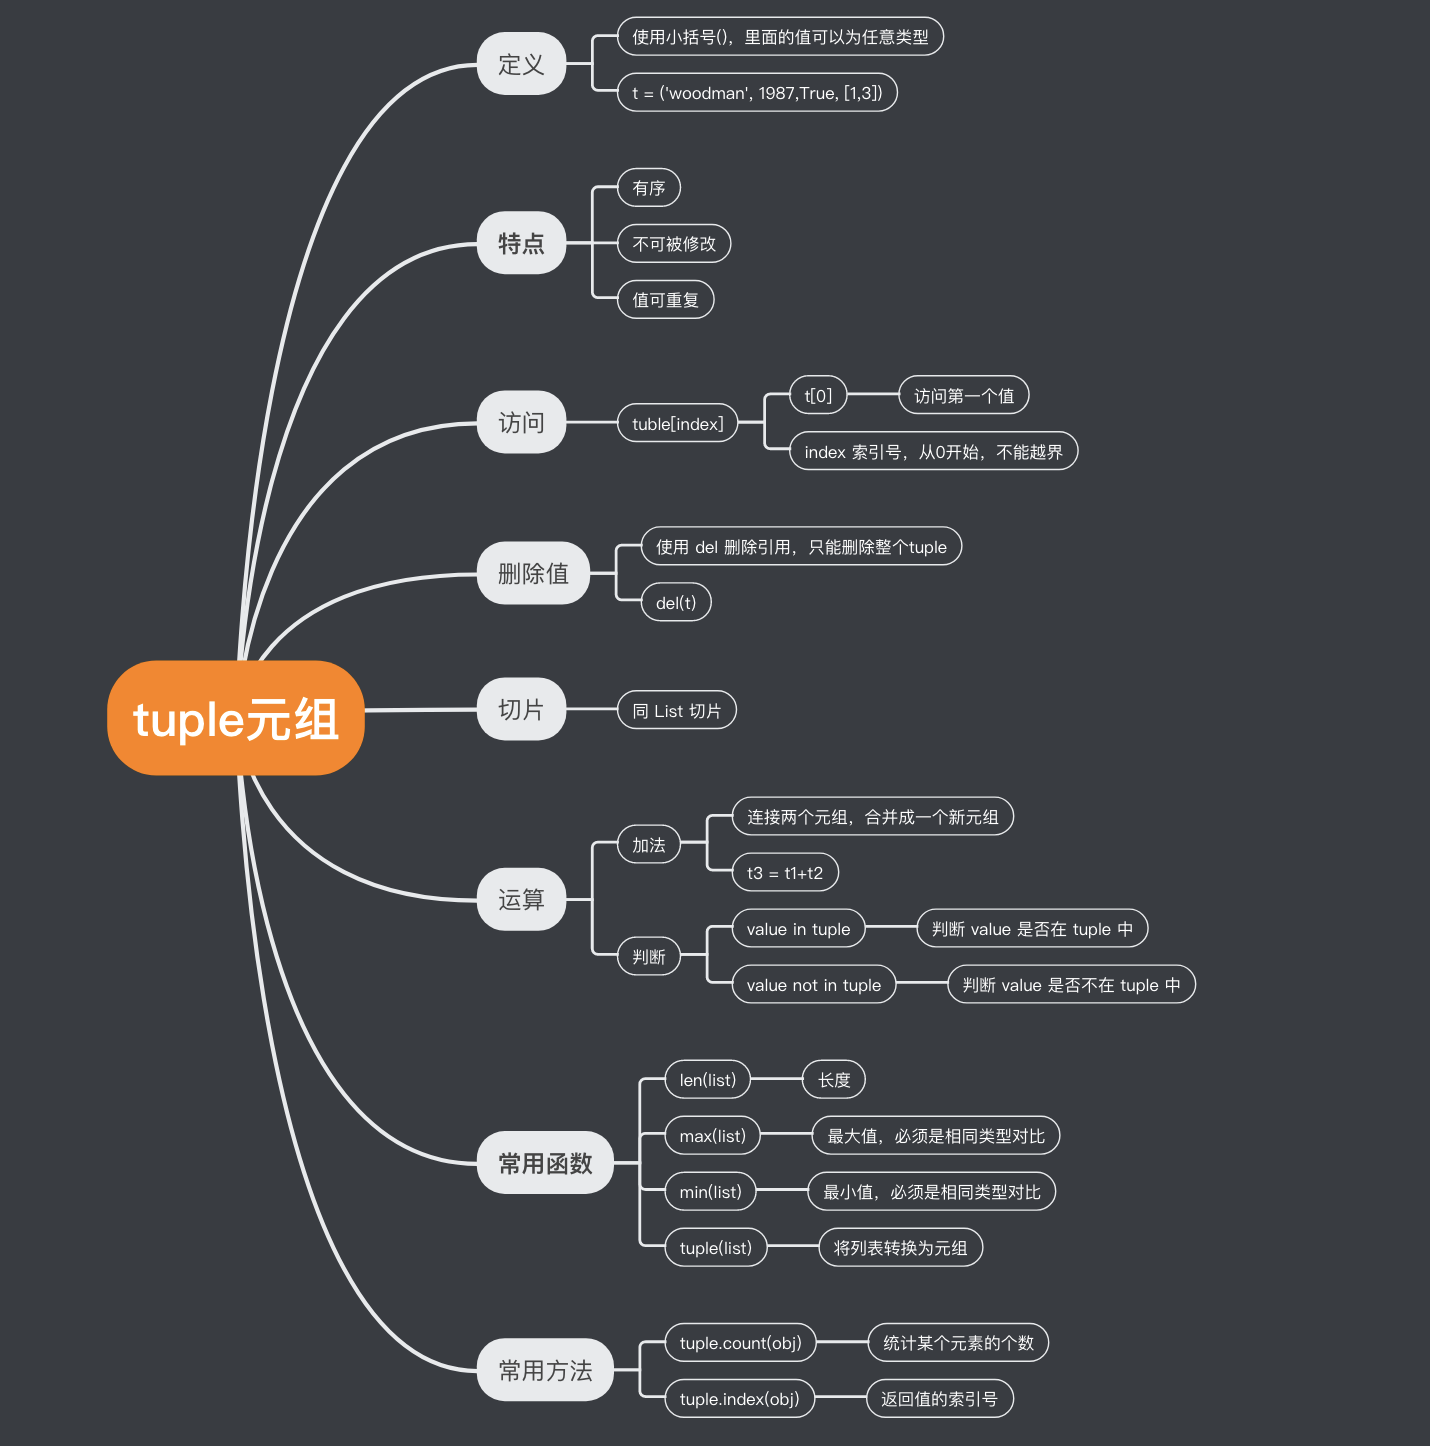
不可变带来两个实际好处。一是可以当字典的 key 和集合的元素,列表就不行;二是函数返回多个值时天然用元组打包,return x, y 拿到的就是一个元组。
写单元素元组必须带逗号,(1,) 才是元组,(1) 只是一个加了括号的整数。这个语法看着别扭,但确实没有更好的写法。
# 2.5 字典
字典是 key-value 结构,查找是哈希表,速度和数据量基本无关。
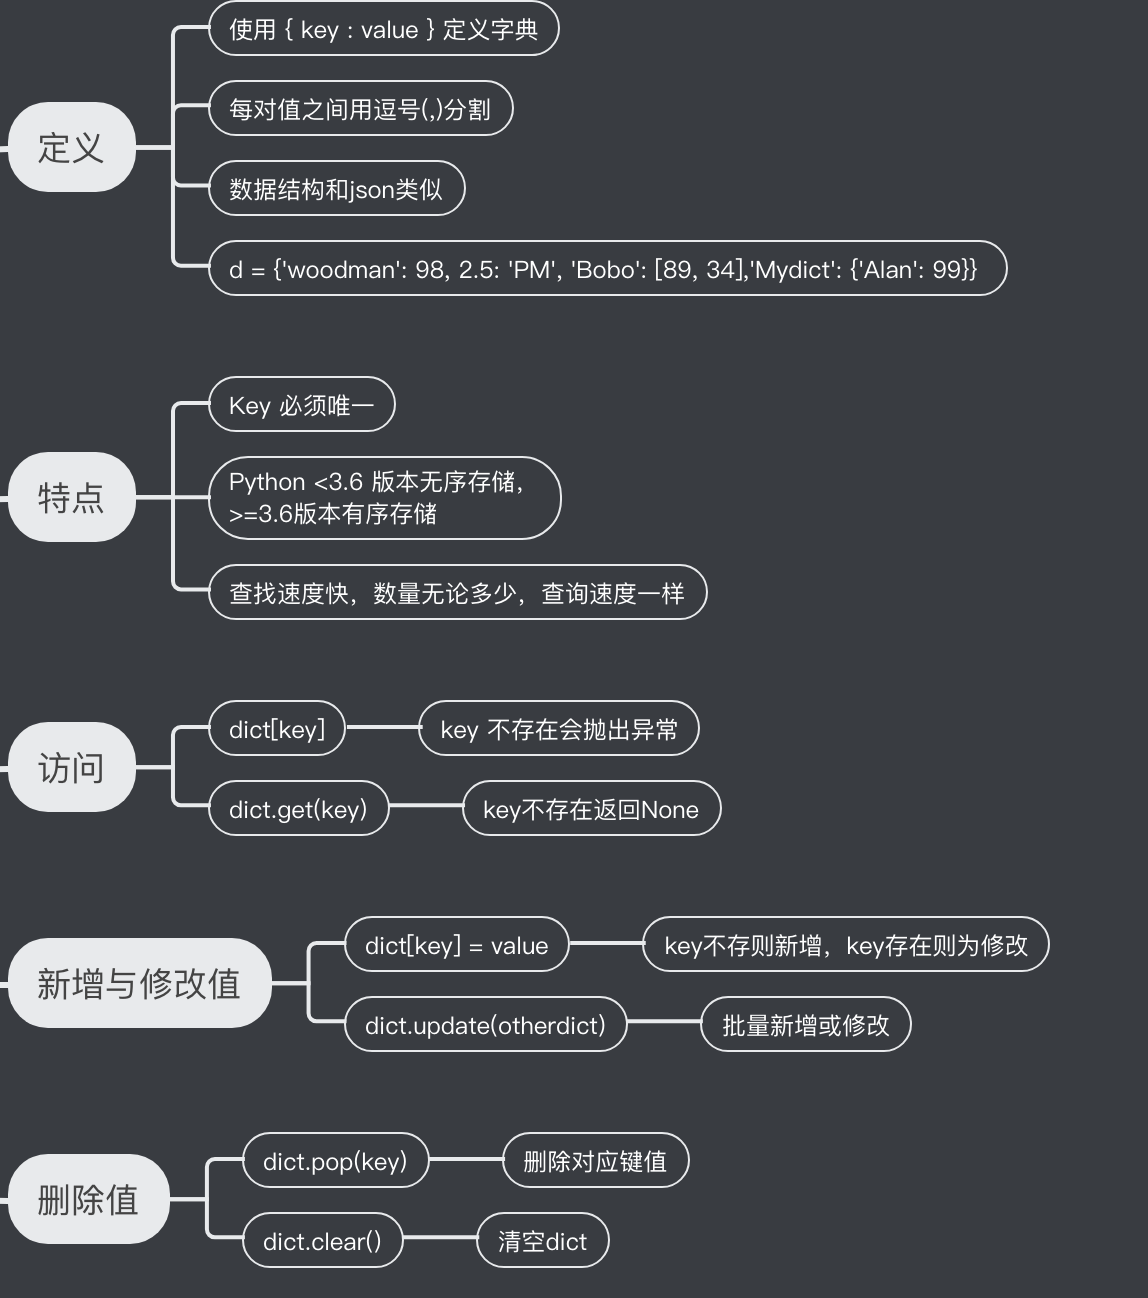
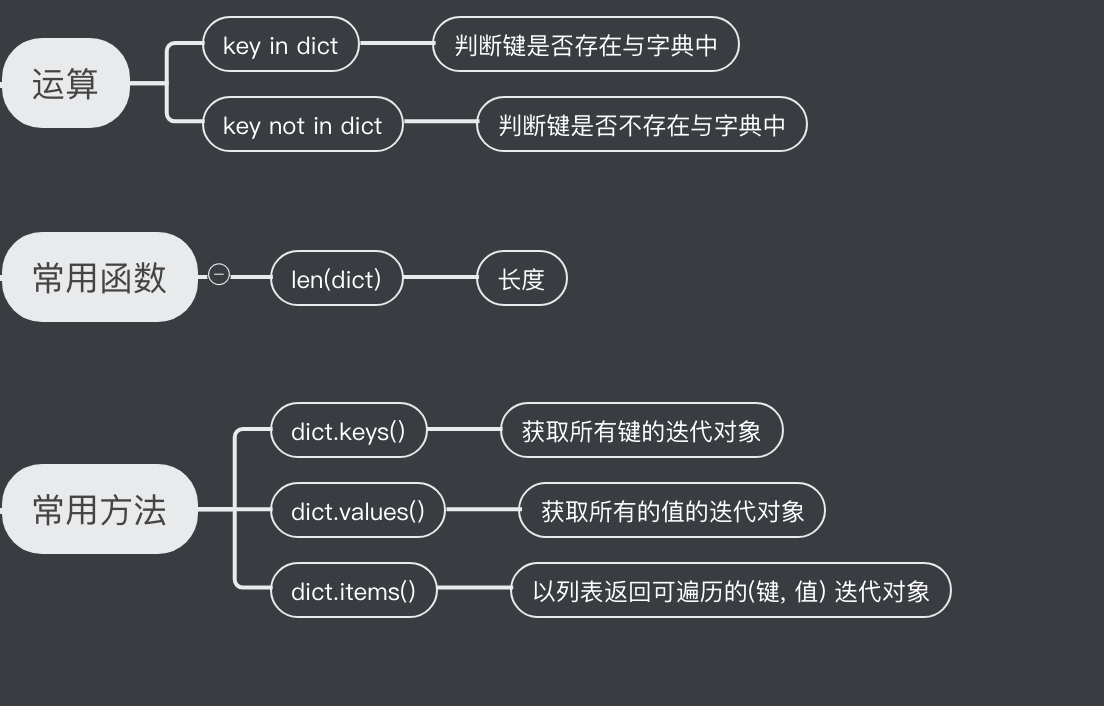
这两张图配合着看。取值的时候优先用 d.get('key') 而不是 d['key'],前者取不到返回 None,后者直接抛 KeyError,get 还能带一个默认值。
那为什么字典的 key 必须是不可变类型呢?因为字典靠 key 的哈希值定位存储位置,如果 key 存进去之后还能被改,哈希值就变了,之前存的那条数据再也找不回来。所以 str、int、tuple 能当 key,list、dict 不行。
顺带一提,从 Python 3.7 开始,字典正式保证按插入顺序遍历,这一点写进了语言规范。3.6 版本其实已经是这个行为了,但当时只算实现细节,不保证。
# 2.6 函数
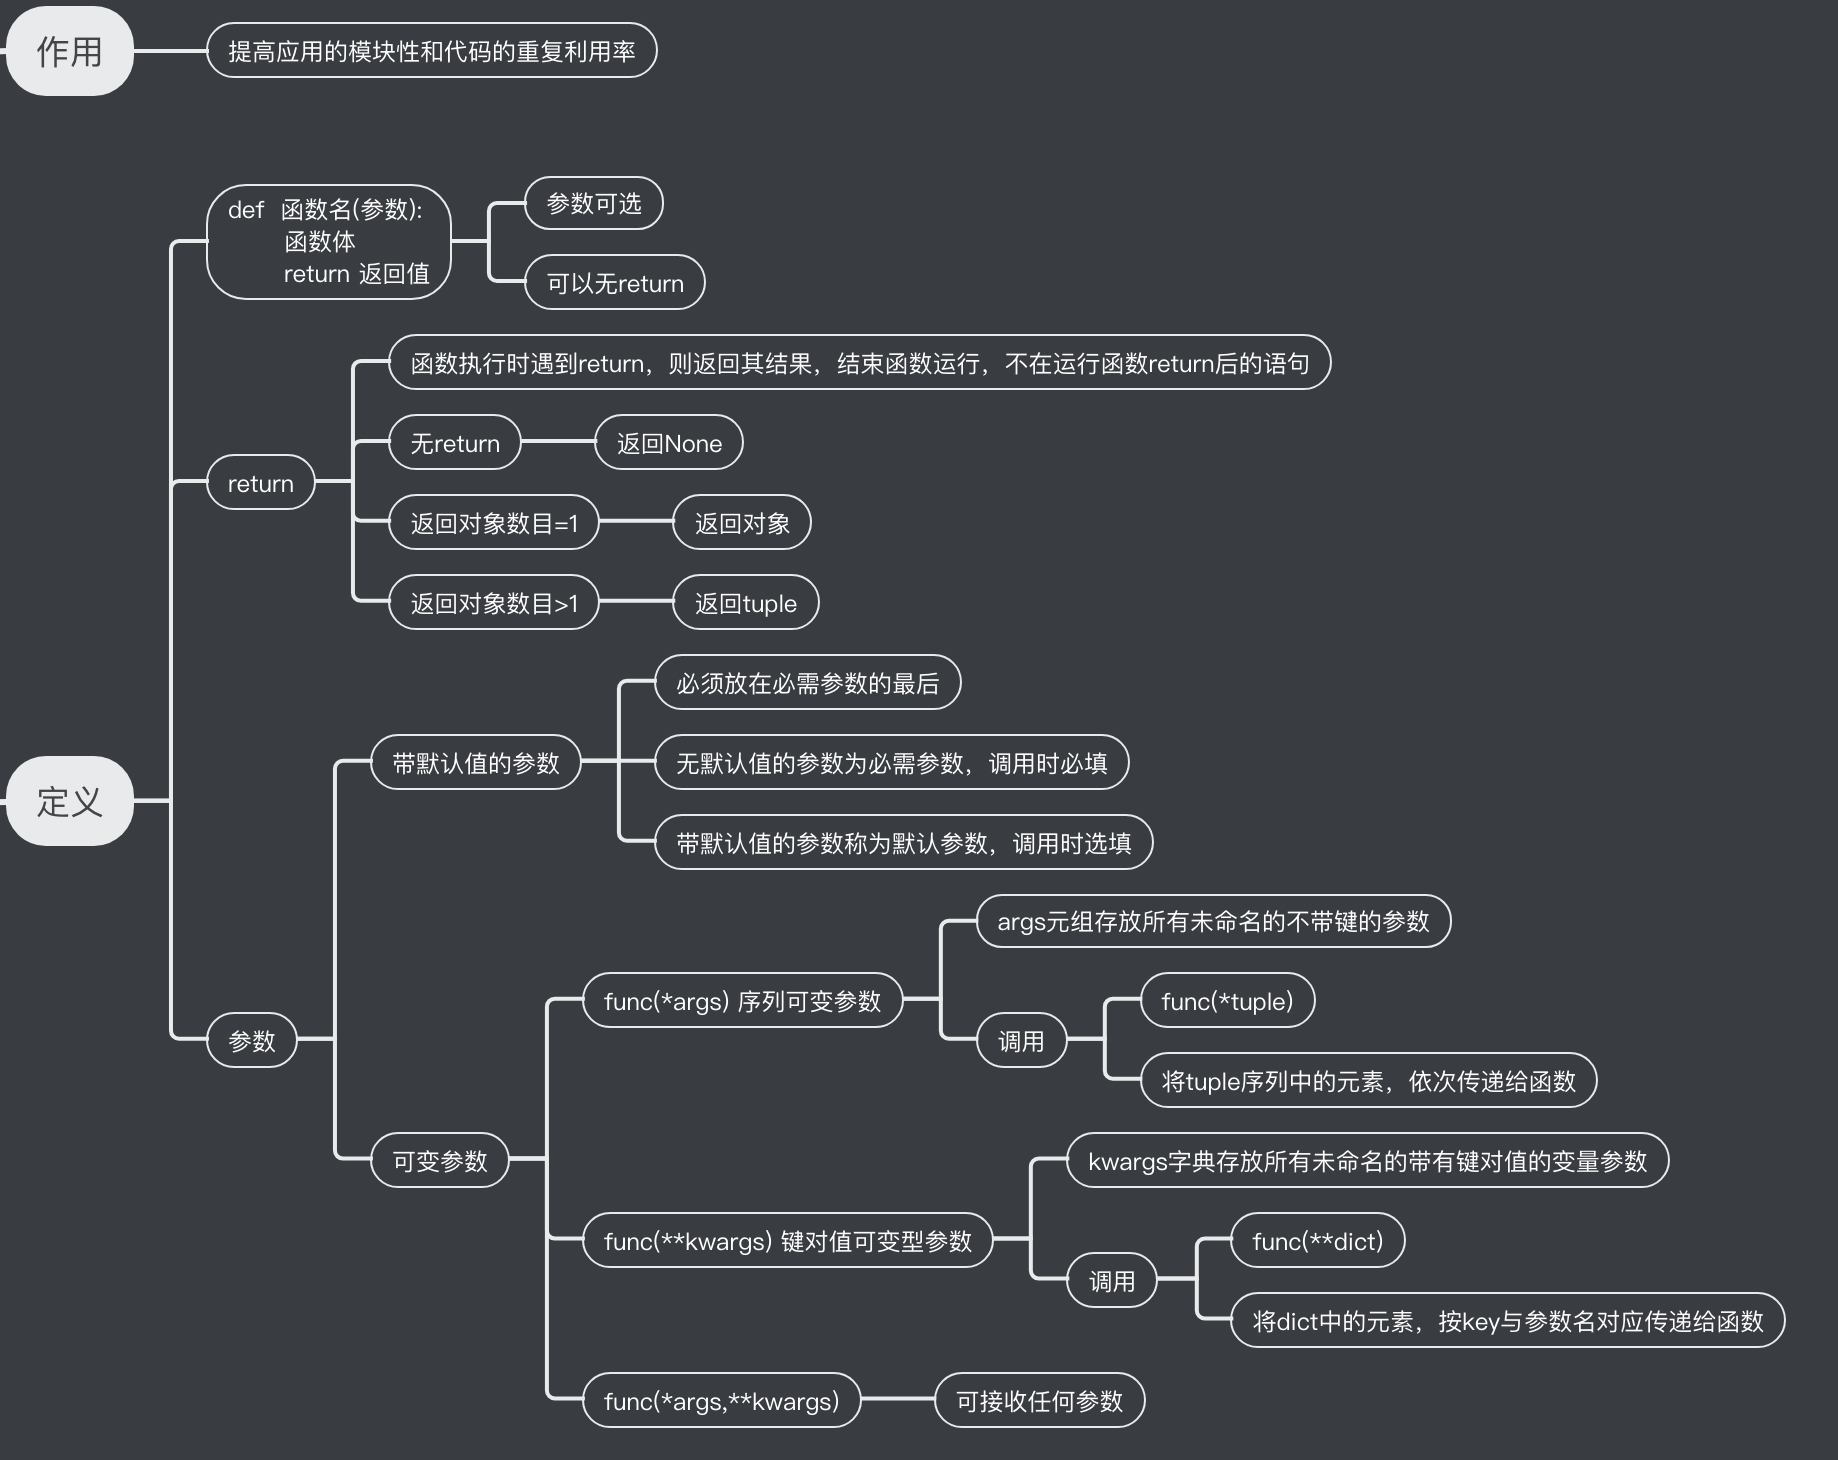
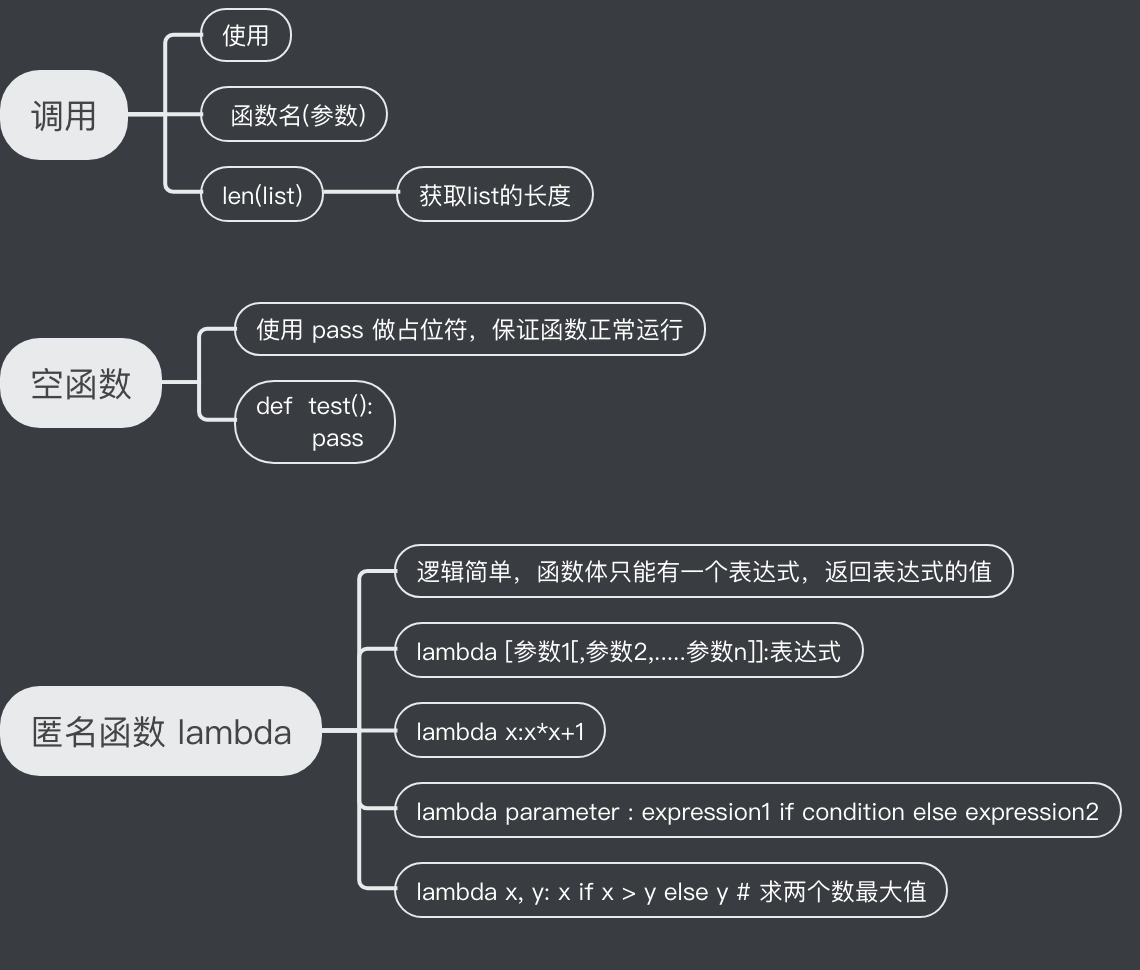
参数这张图信息量最大。位置参数、默认参数、*args、**kwargs 的顺序是固定的,写反了直接语法错误。
这里有个非常经典的陷阱:默认参数不要用可变对象。def f(items=[]) 这种写法,默认的空列表只在函数定义时创建一次,后续每次调用共享同一个列表,调三次就会发现里面的元素在累加。正确写法是默认值给 None,进函数体再判断赋值。
# 2.7 流程控制
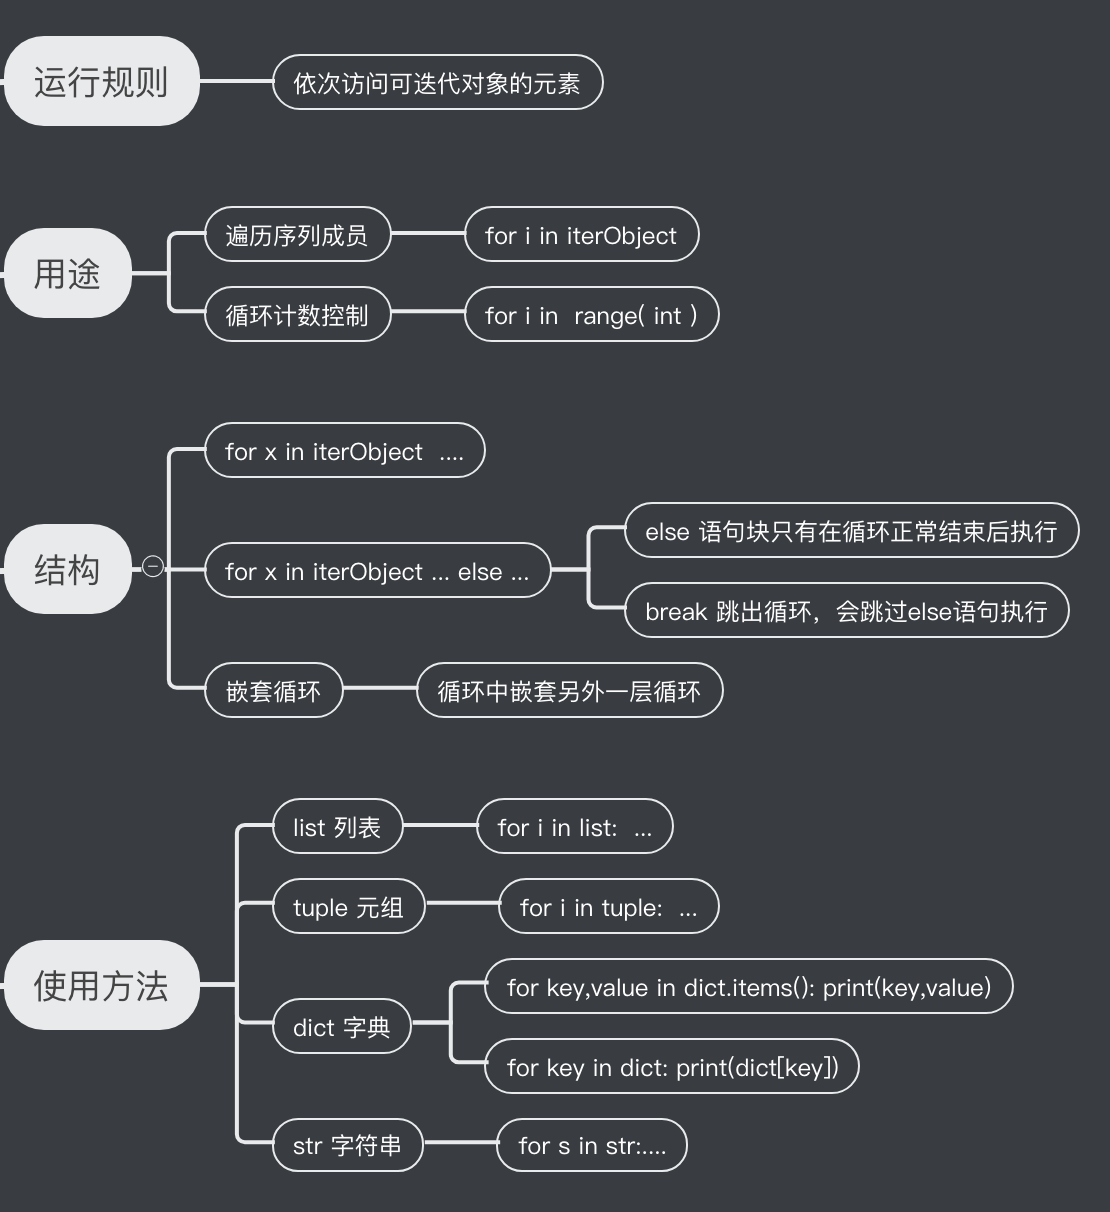
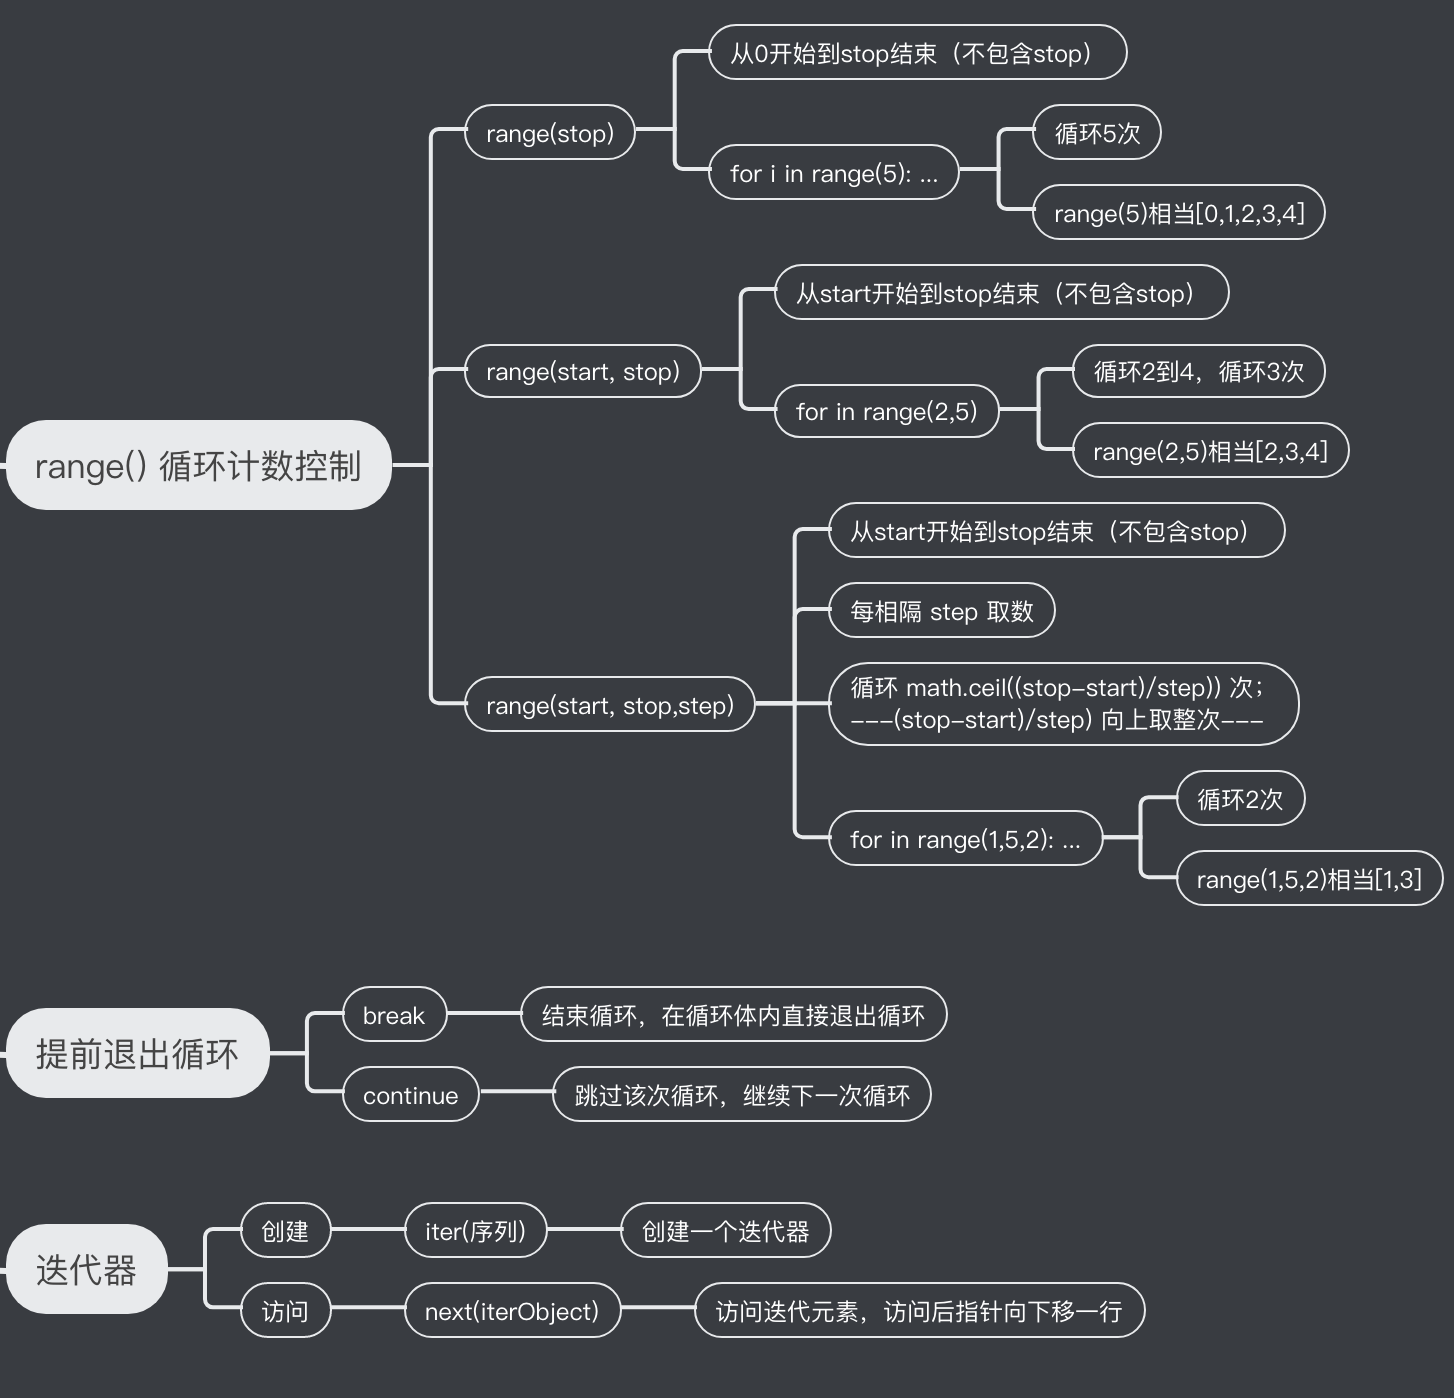
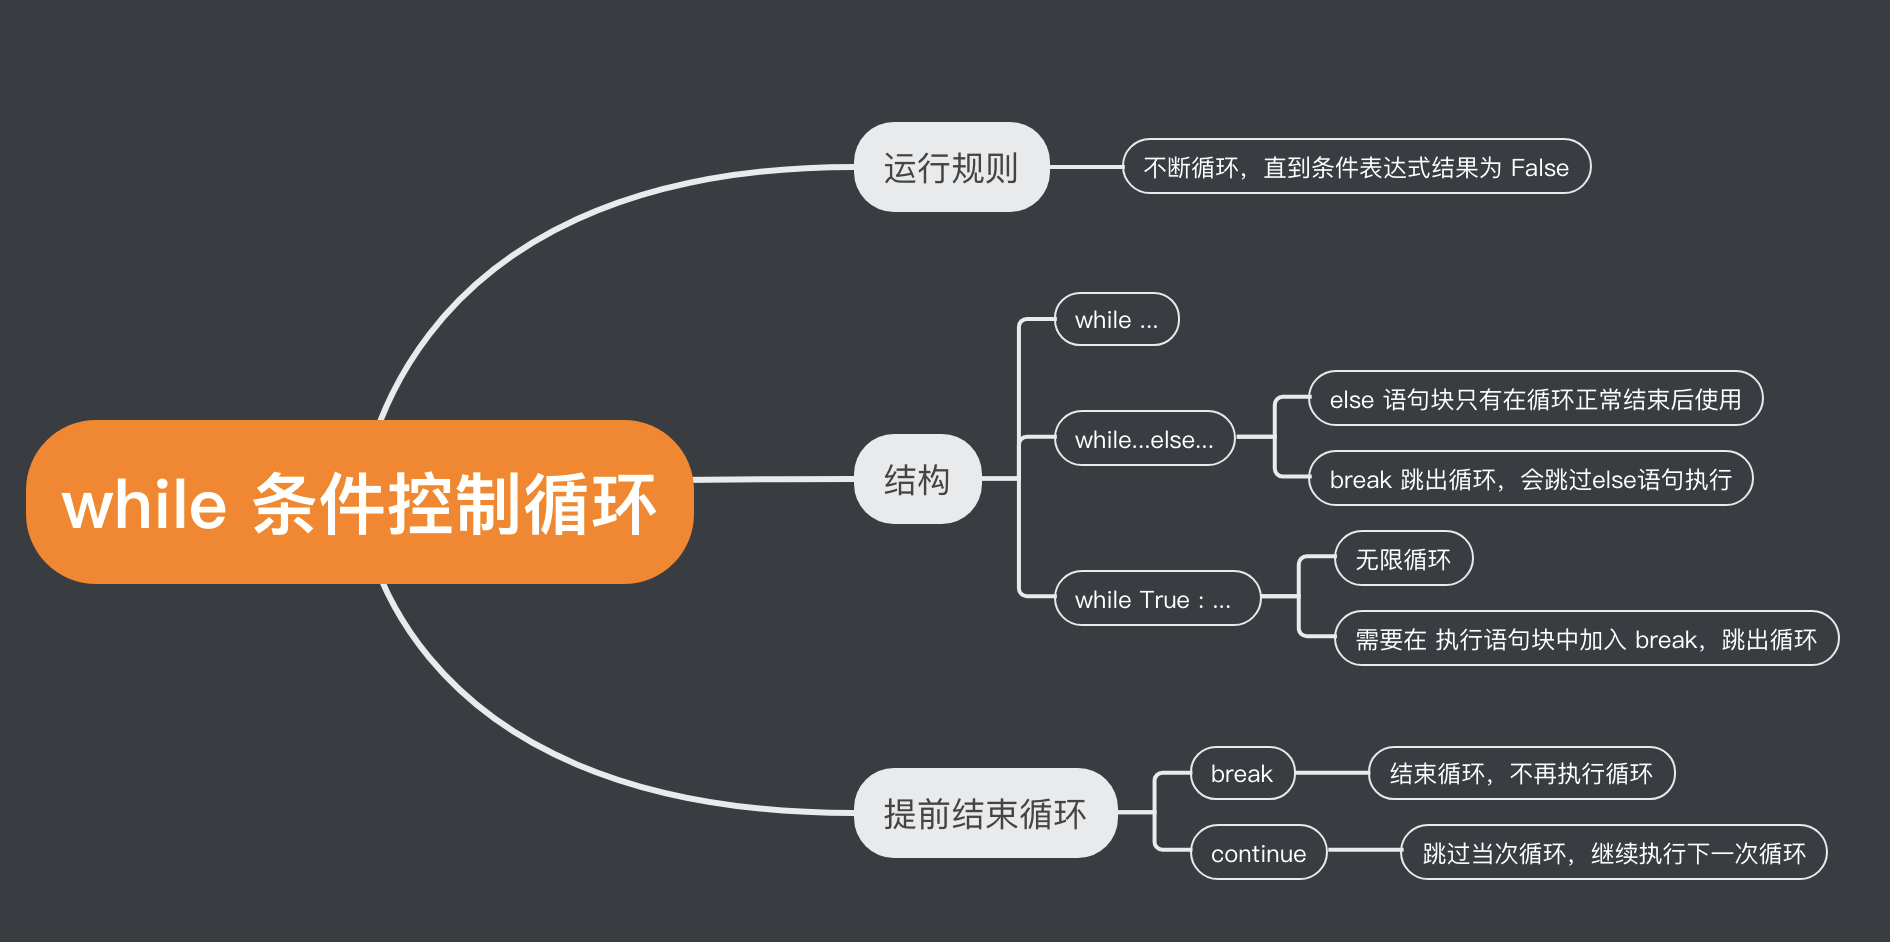
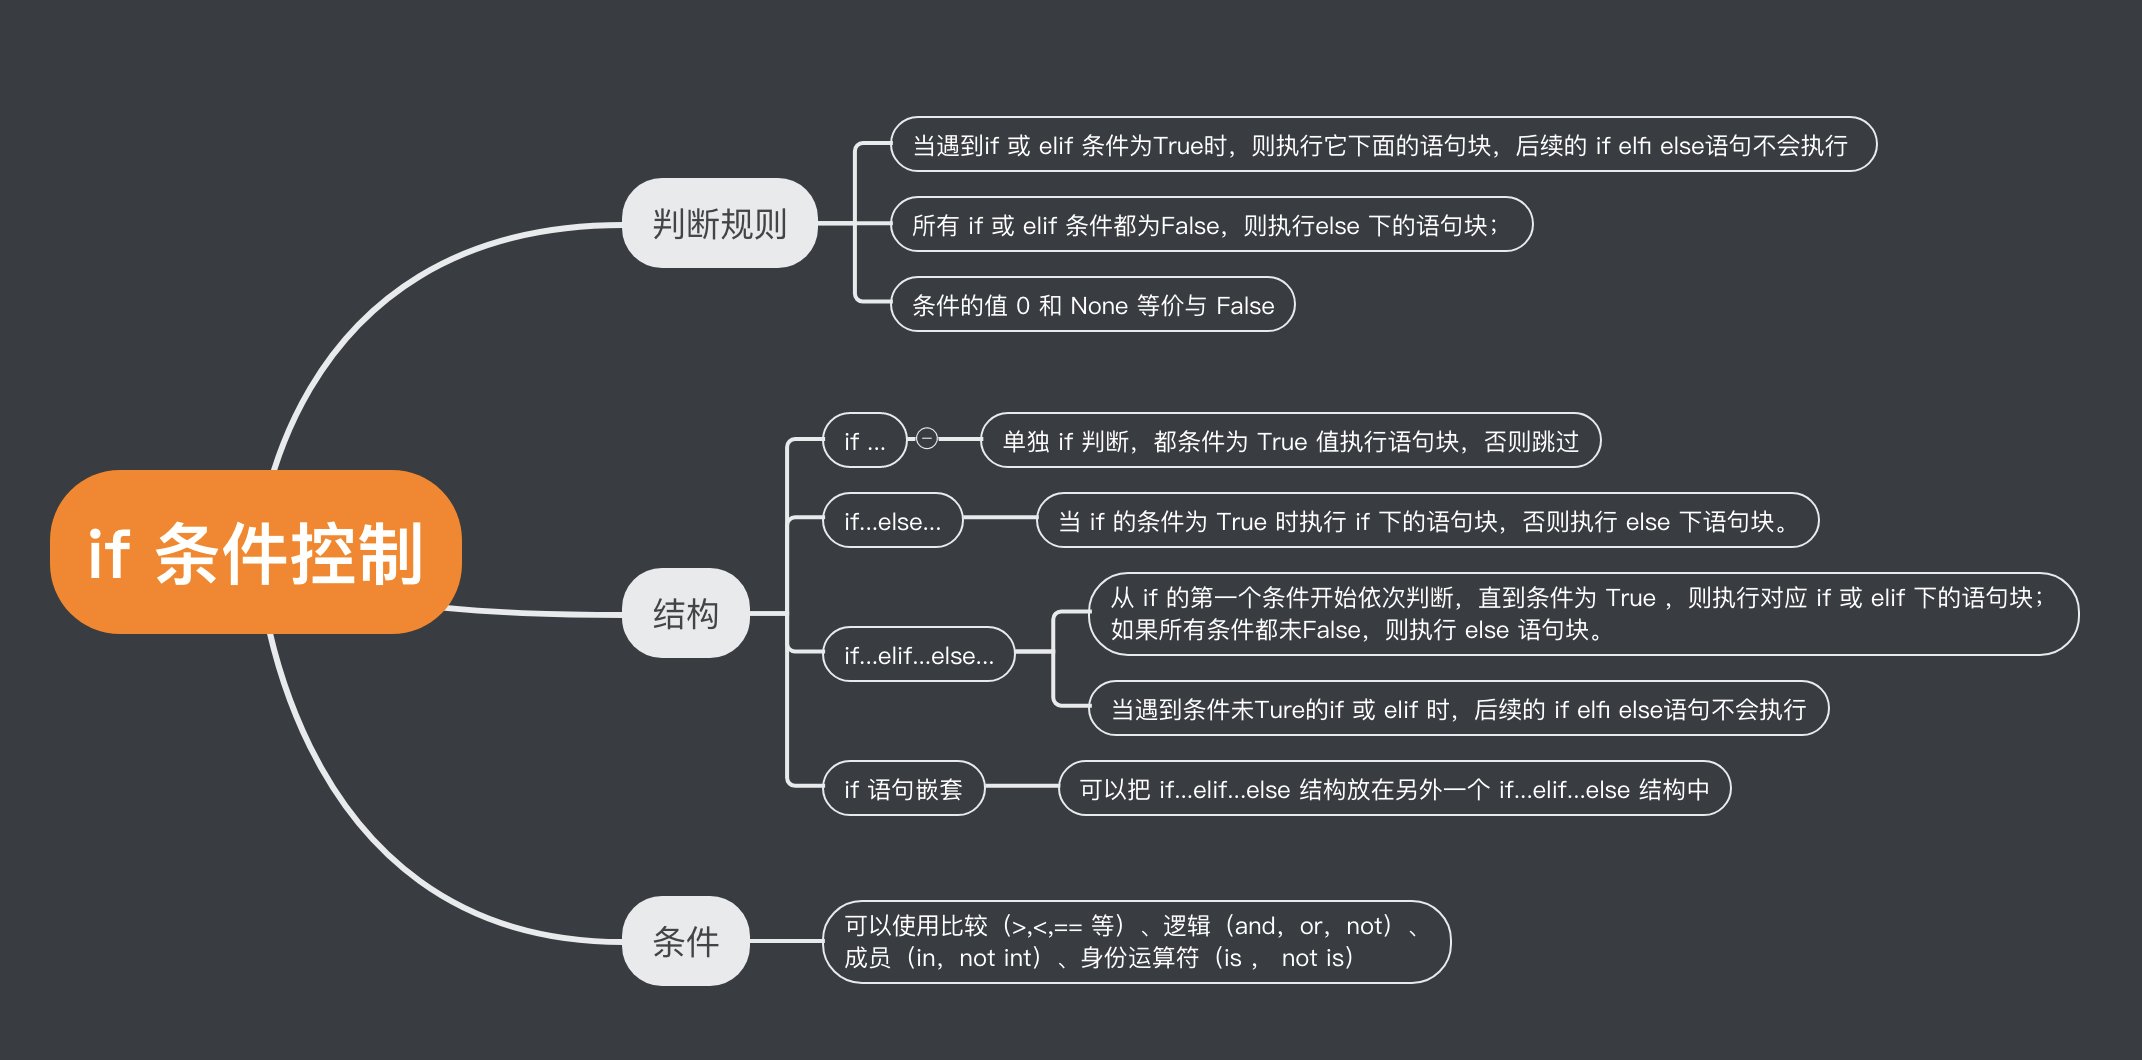
四张图覆盖了分支和循环。几个和别的语言不一样的地方:多分支用 elif 而不是 else if;Python 没有 switch 语句,历史上都用字典映射或者一串 elif 代替(3.10 之后有了 match 语句,但和 C 系的 switch 不是一回事,它是结构化模式匹配)。
for 循环在 Python 里是「遍历可迭代对象」,不是 C 那种计数循环,要按下标走得配 range(),要同时拿到下标和值就用 enumerate()。
还有一个别的语言基本没有的语法,for 和 while 都可以带 else 分支,循环正常跑完才执行,被 break 中断就跳过。用在「找不到就报错」这种场景挺顺手,但可读性一般,团队里不熟悉的人多就别用。
# 三、类
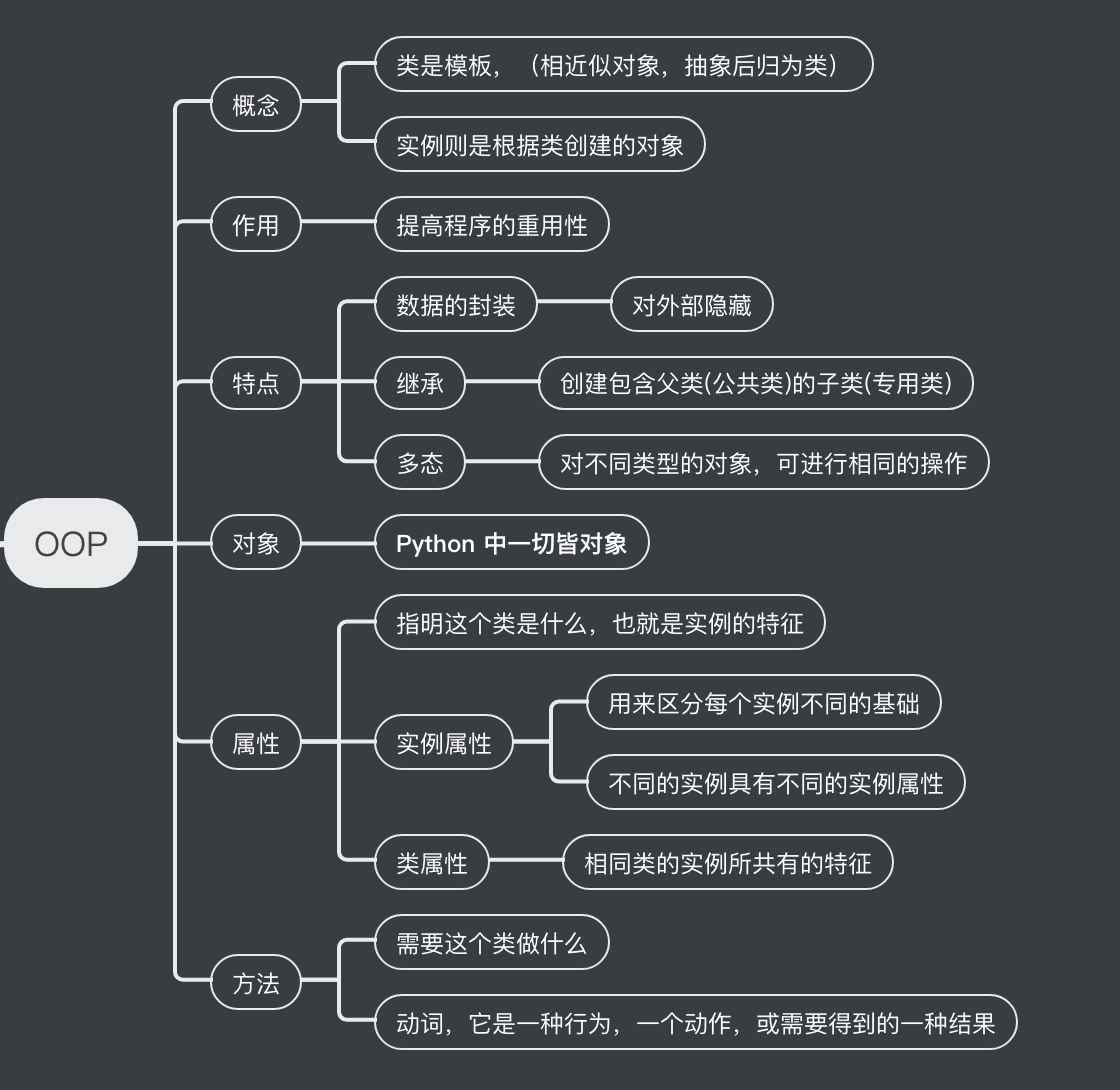
面向对象这块 Python 的语法比 Java 松得多,但概念是齐的。
# 3.1 创建类
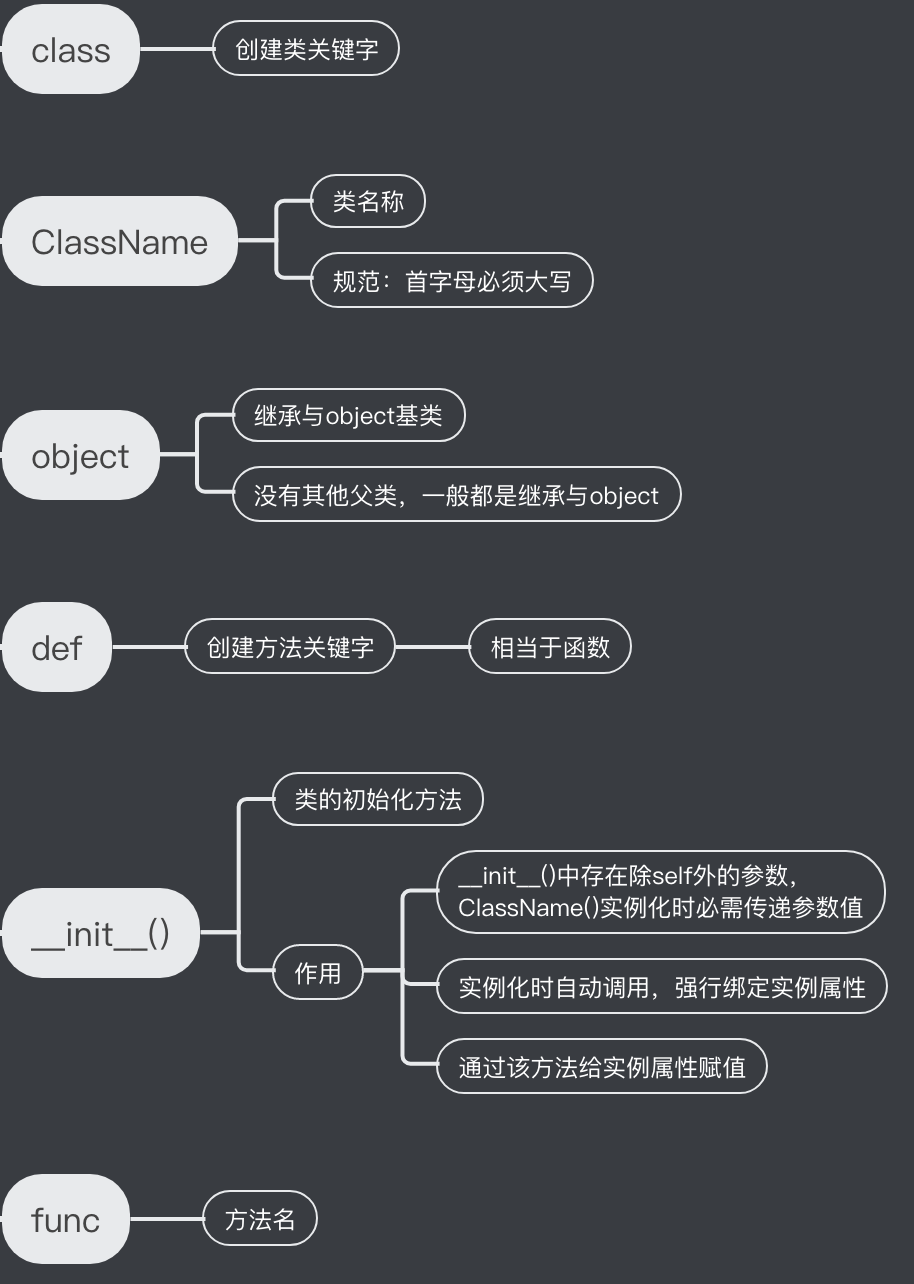
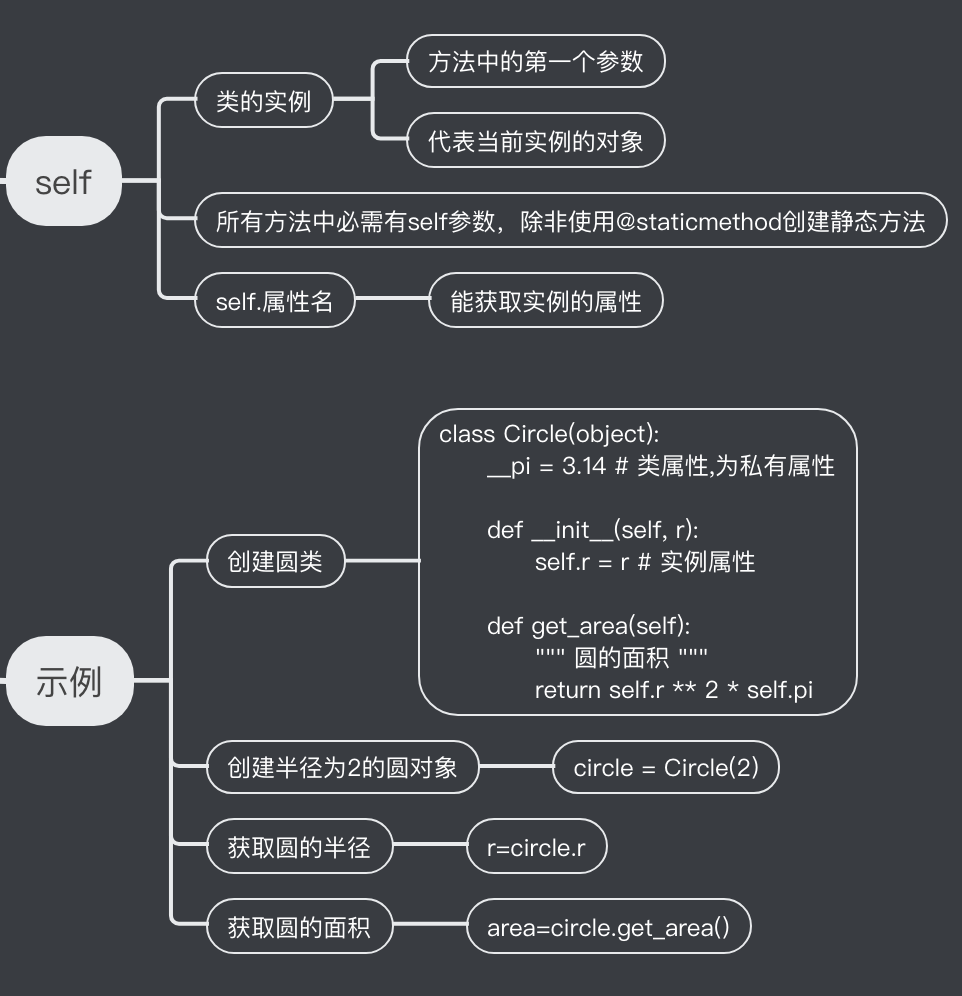
__init__ 是初始化方法,实例创建之后被调用,用来给对象挂属性。它的第一个参数 self 必须显式写出来,这一点常被吐槽啰嗦,但好处是「实例方法就是第一个参数为实例的普通函数」这件事变得非常直白。
继承写在类名后面的括号里,调用父类构造建议用 super().__init__(...),比直接写 父类名.__init__(self, ...) 更好维护,多重继承时也只有 super() 能走对方法解析顺序。
# 3.2 属性
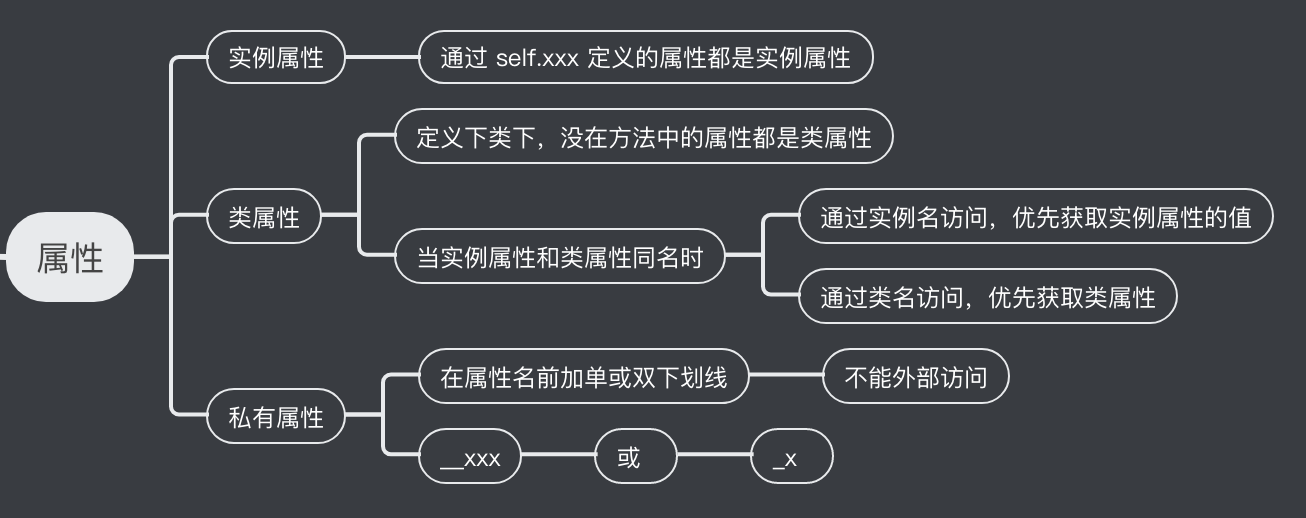
类属性和实例属性的区别是这一节的重点。类属性写在 class 下面、方法外面,所有实例共享;实例属性挂在 self 上,各归各的。
要小心的是,如果类属性是列表这类可变对象,某个实例把它改了,所有实例都会看到变化,因为大家指向的是同一个对象。但如果直接给实例的同名属性赋值,Python 会在实例上新建一个属性把类属性遮住,不影响别人。这两种行为长得像,结果完全不同。
# 3.3 方法
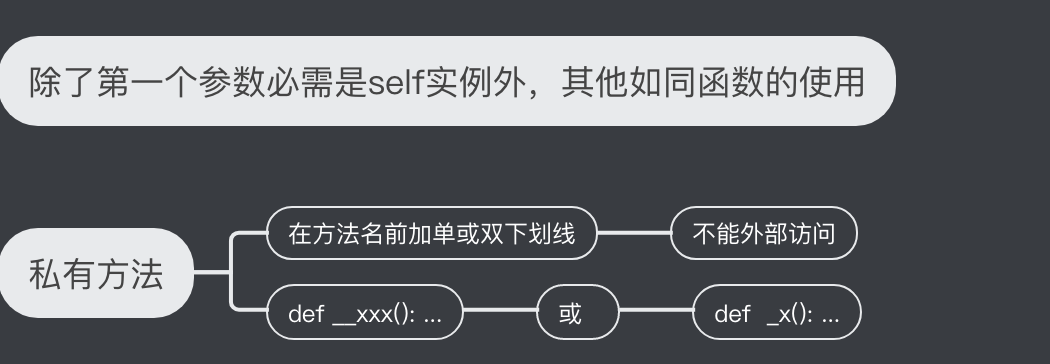
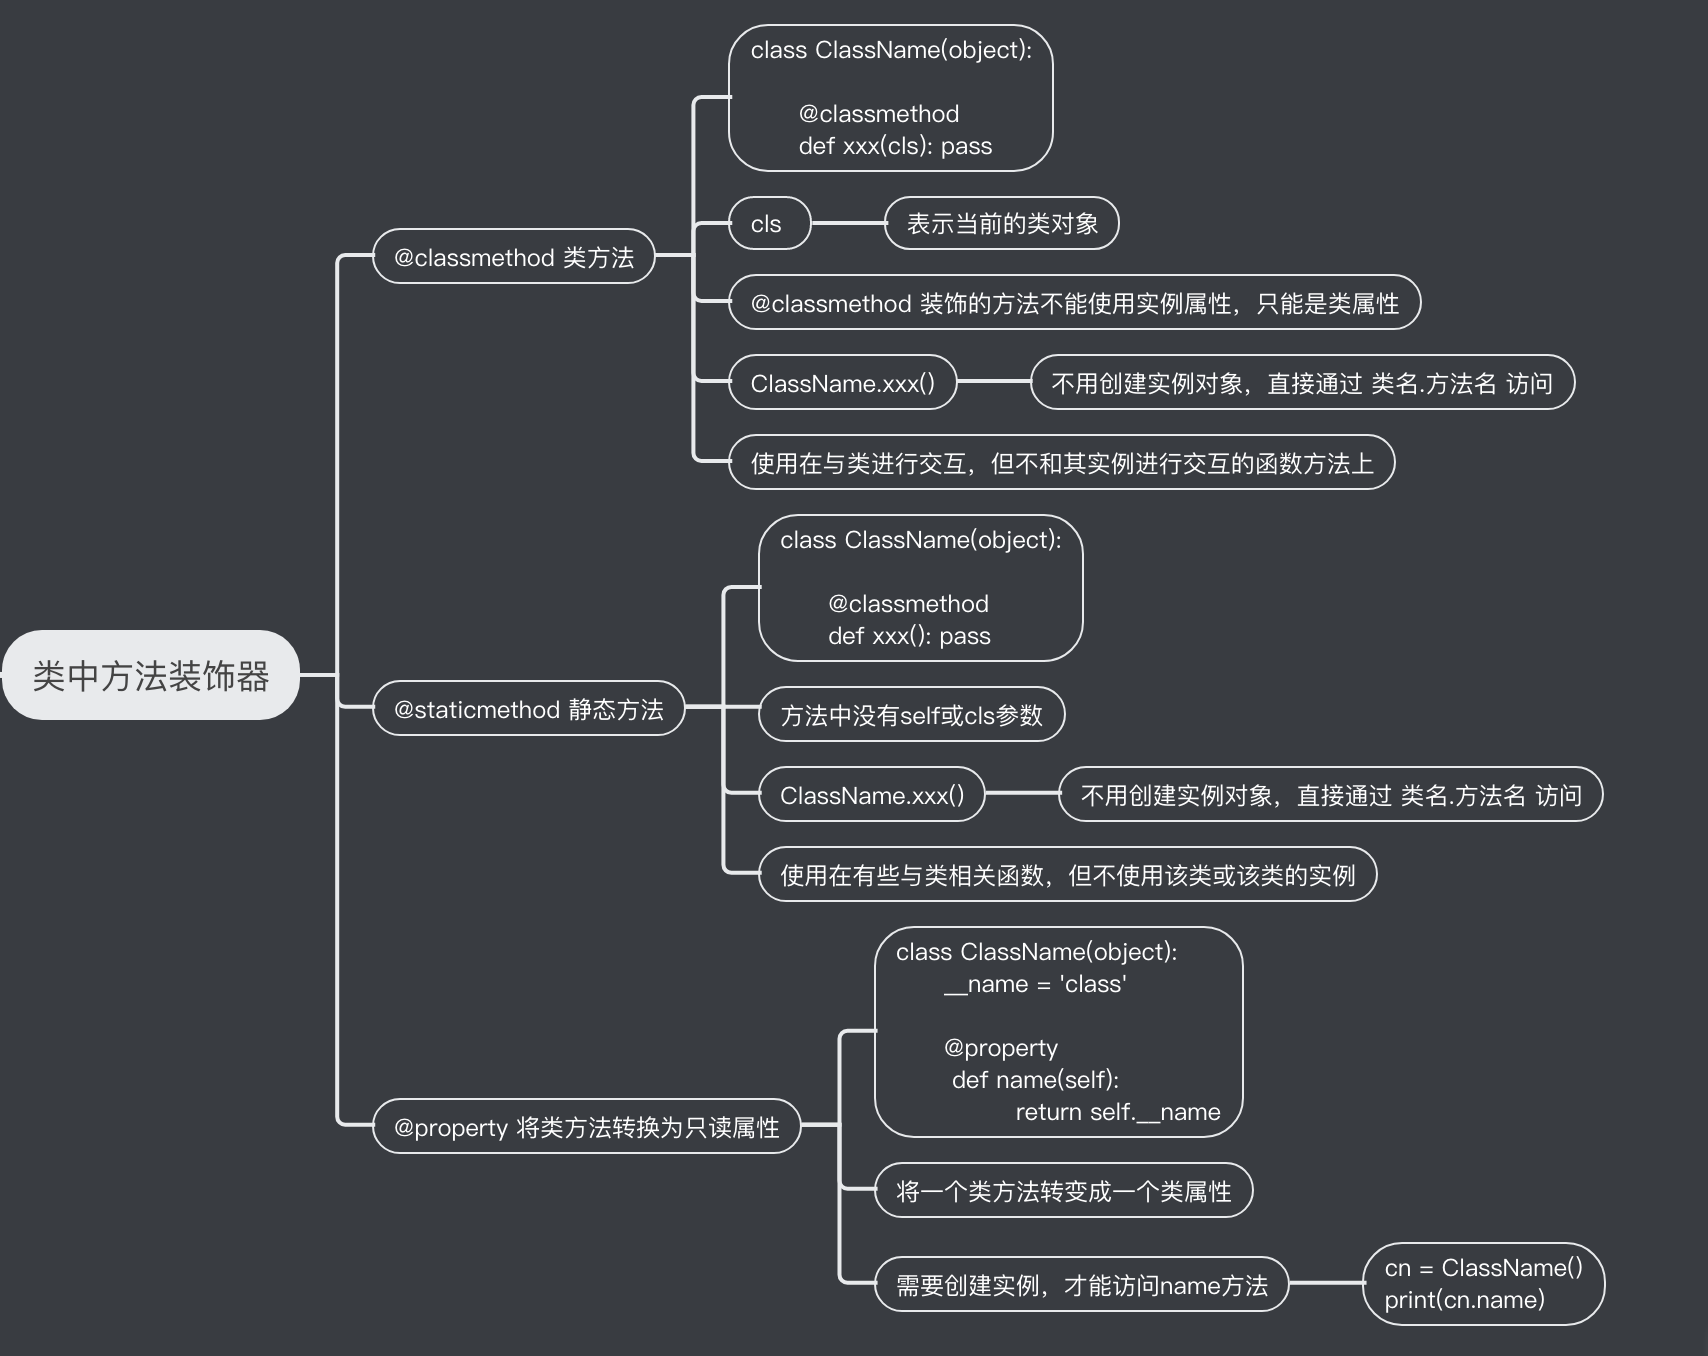
方法分三类。实例方法第一个参数是 self,类方法用 @classmethod 装饰、第一个参数是 cls,静态方法用 @staticmethod 装饰、什么都不接。需要访问类本身(比如做工厂方法)就用类方法,纯工具函数只是逻辑上归属这个类就用静态方法。
私有成员这块要说清楚。Python 里以双下划线开头的名字(比如 __name)并不是真的私有,解释器只是做了名字改写,把它变成 _类名__name。外部照样能访问,只是得绕一下。所以它更像是一个「别碰我」的约定,而不是编译期强制。单下划线开头就更弱了,纯粹靠自觉。
# 四、高级特性
这一节是 Python 相对好用的地方,也是面试爱问的地方。
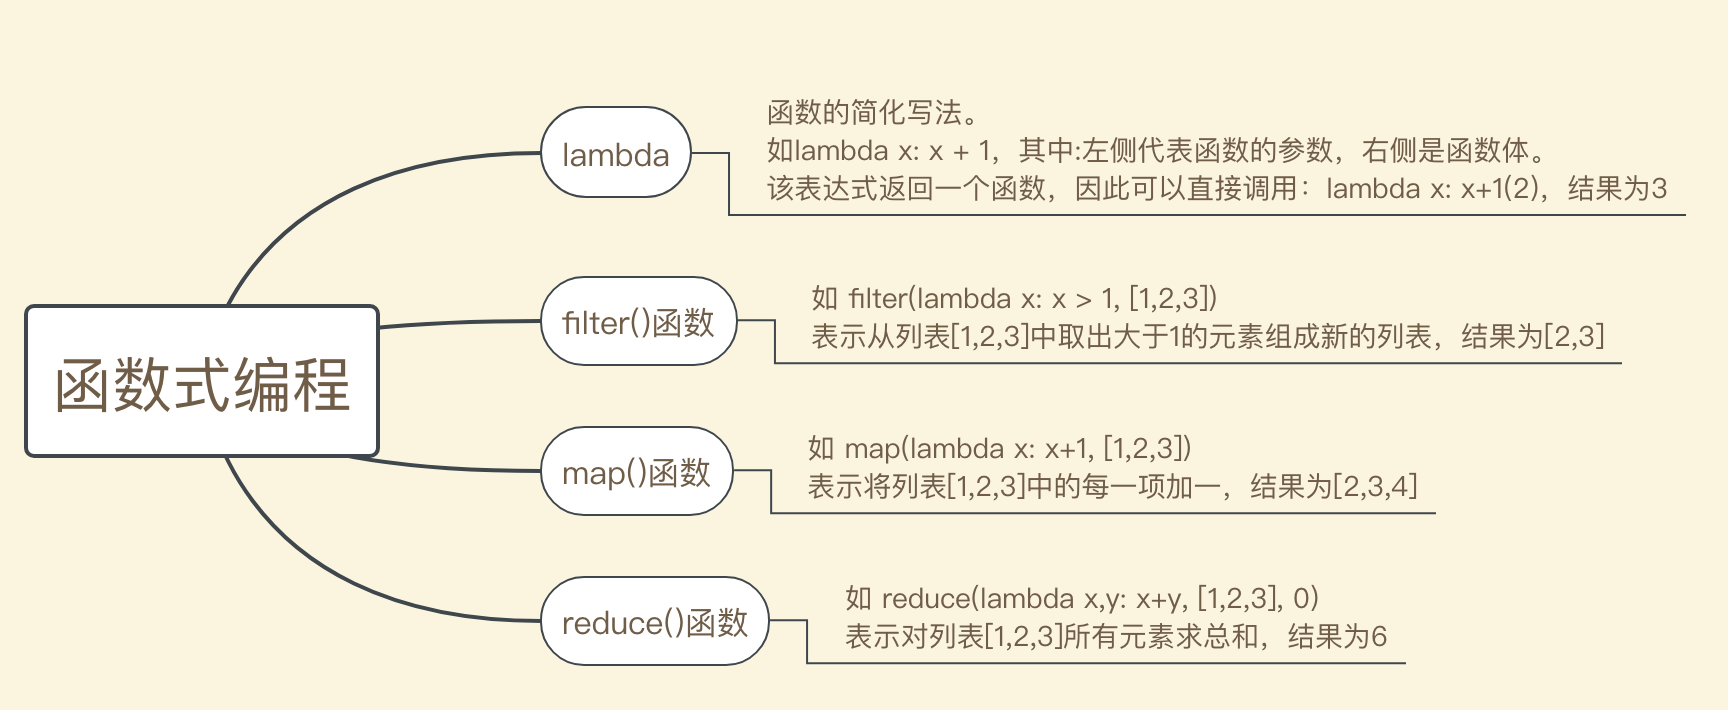
map、filter、reduce 加上 lambda 构成了 Python 的函数式那一小块。在 Python 3 里 map 和 filter 返回的是迭代器不是列表,要看到内容得套一层 list()。日常写代码其实列表推导式更常见,可读性更好,map/filter 主要用在配合已有函数的场景。
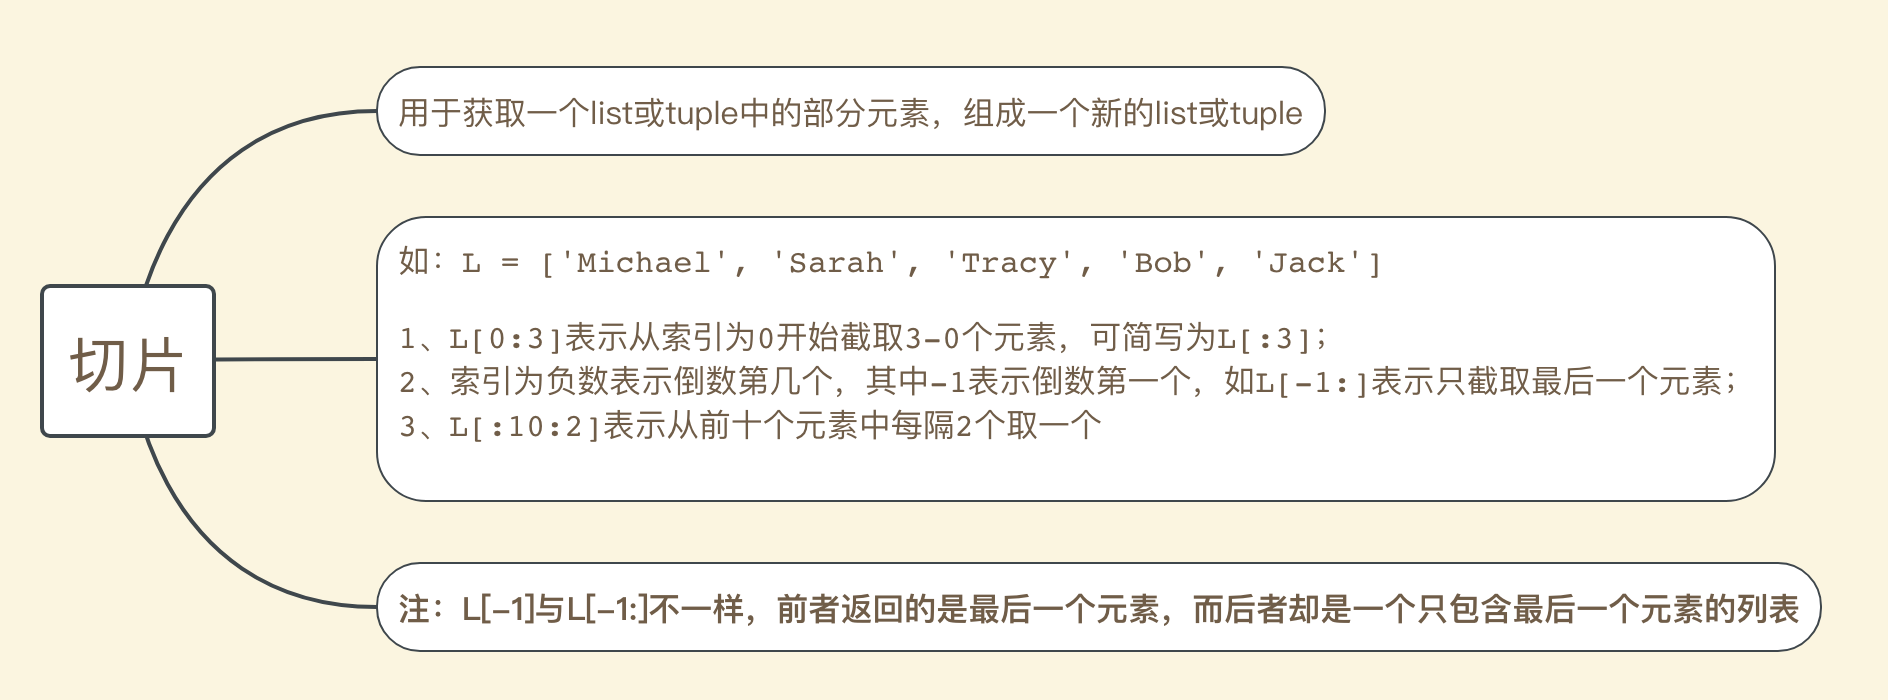
切片这里再强调一次,a[:] 是浅拷贝一份列表,改副本不影响原来的;但如果列表里装的是嵌套列表,改内层还是会串,那时候得用 copy.deepcopy。
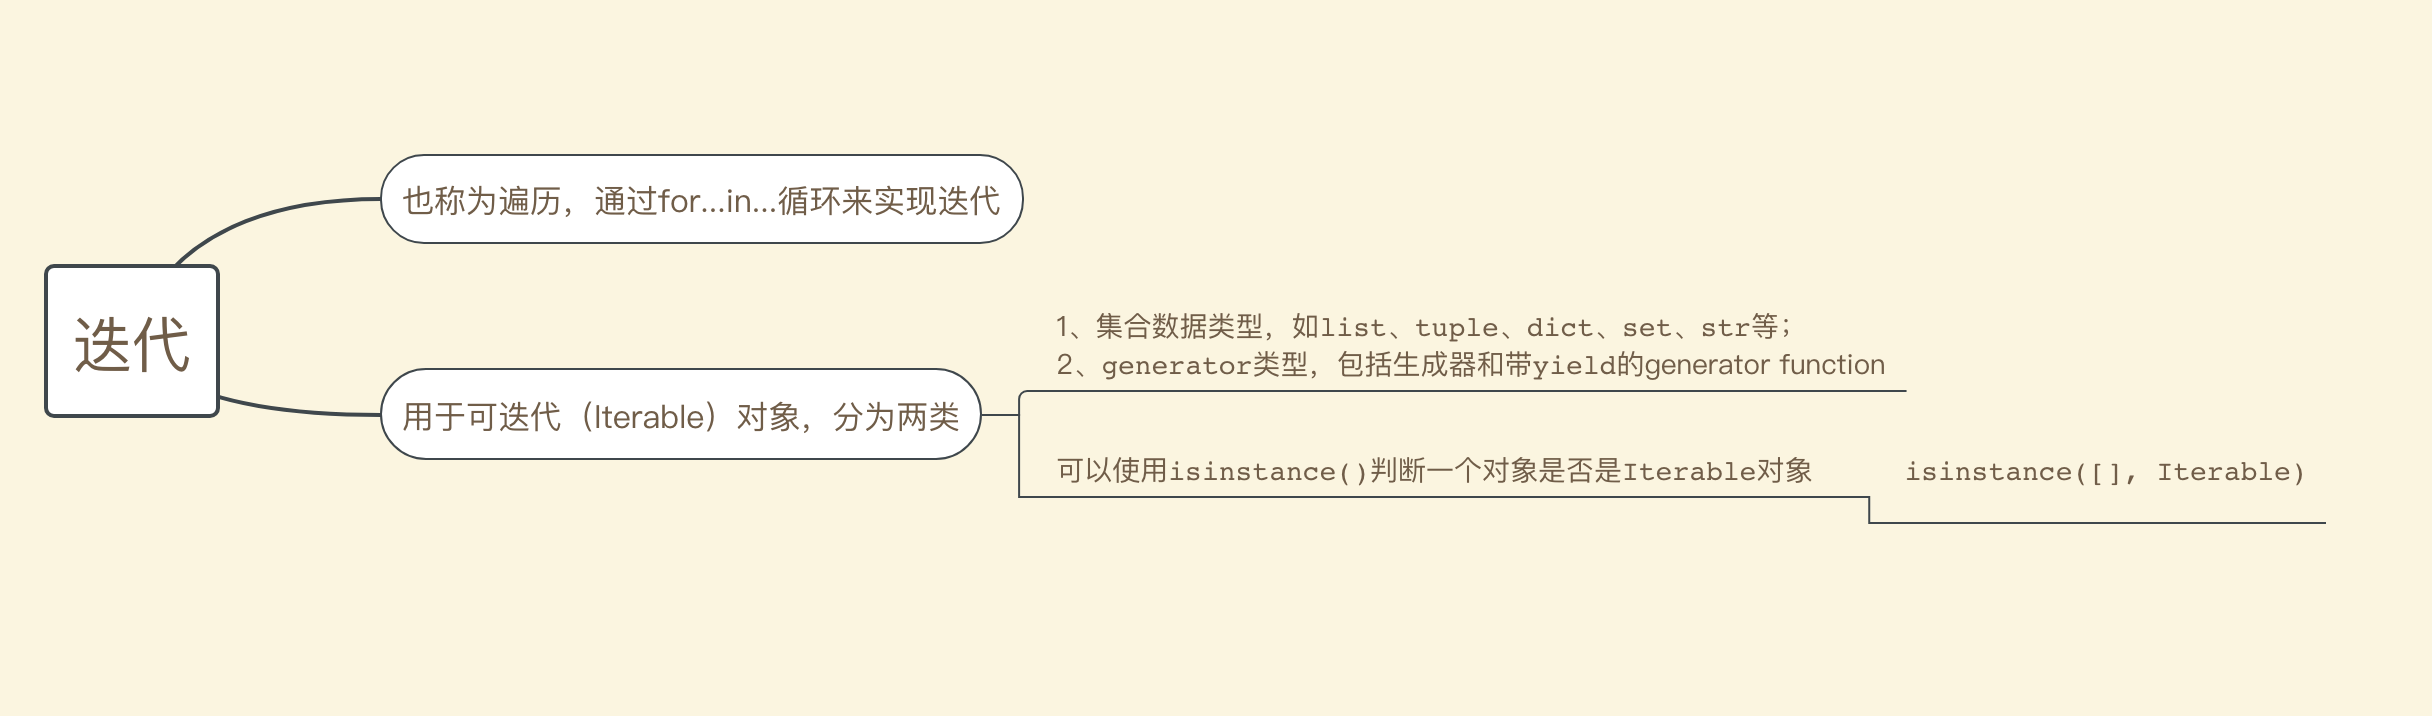
只要实现了 __iter__ 就是可迭代对象,for 就能遍历。列表、字符串、字典、文件对象都在这个范围里,所以「按行读文件」可以直接 for line in f,不用先 readlines() 把整个文件读进内存。
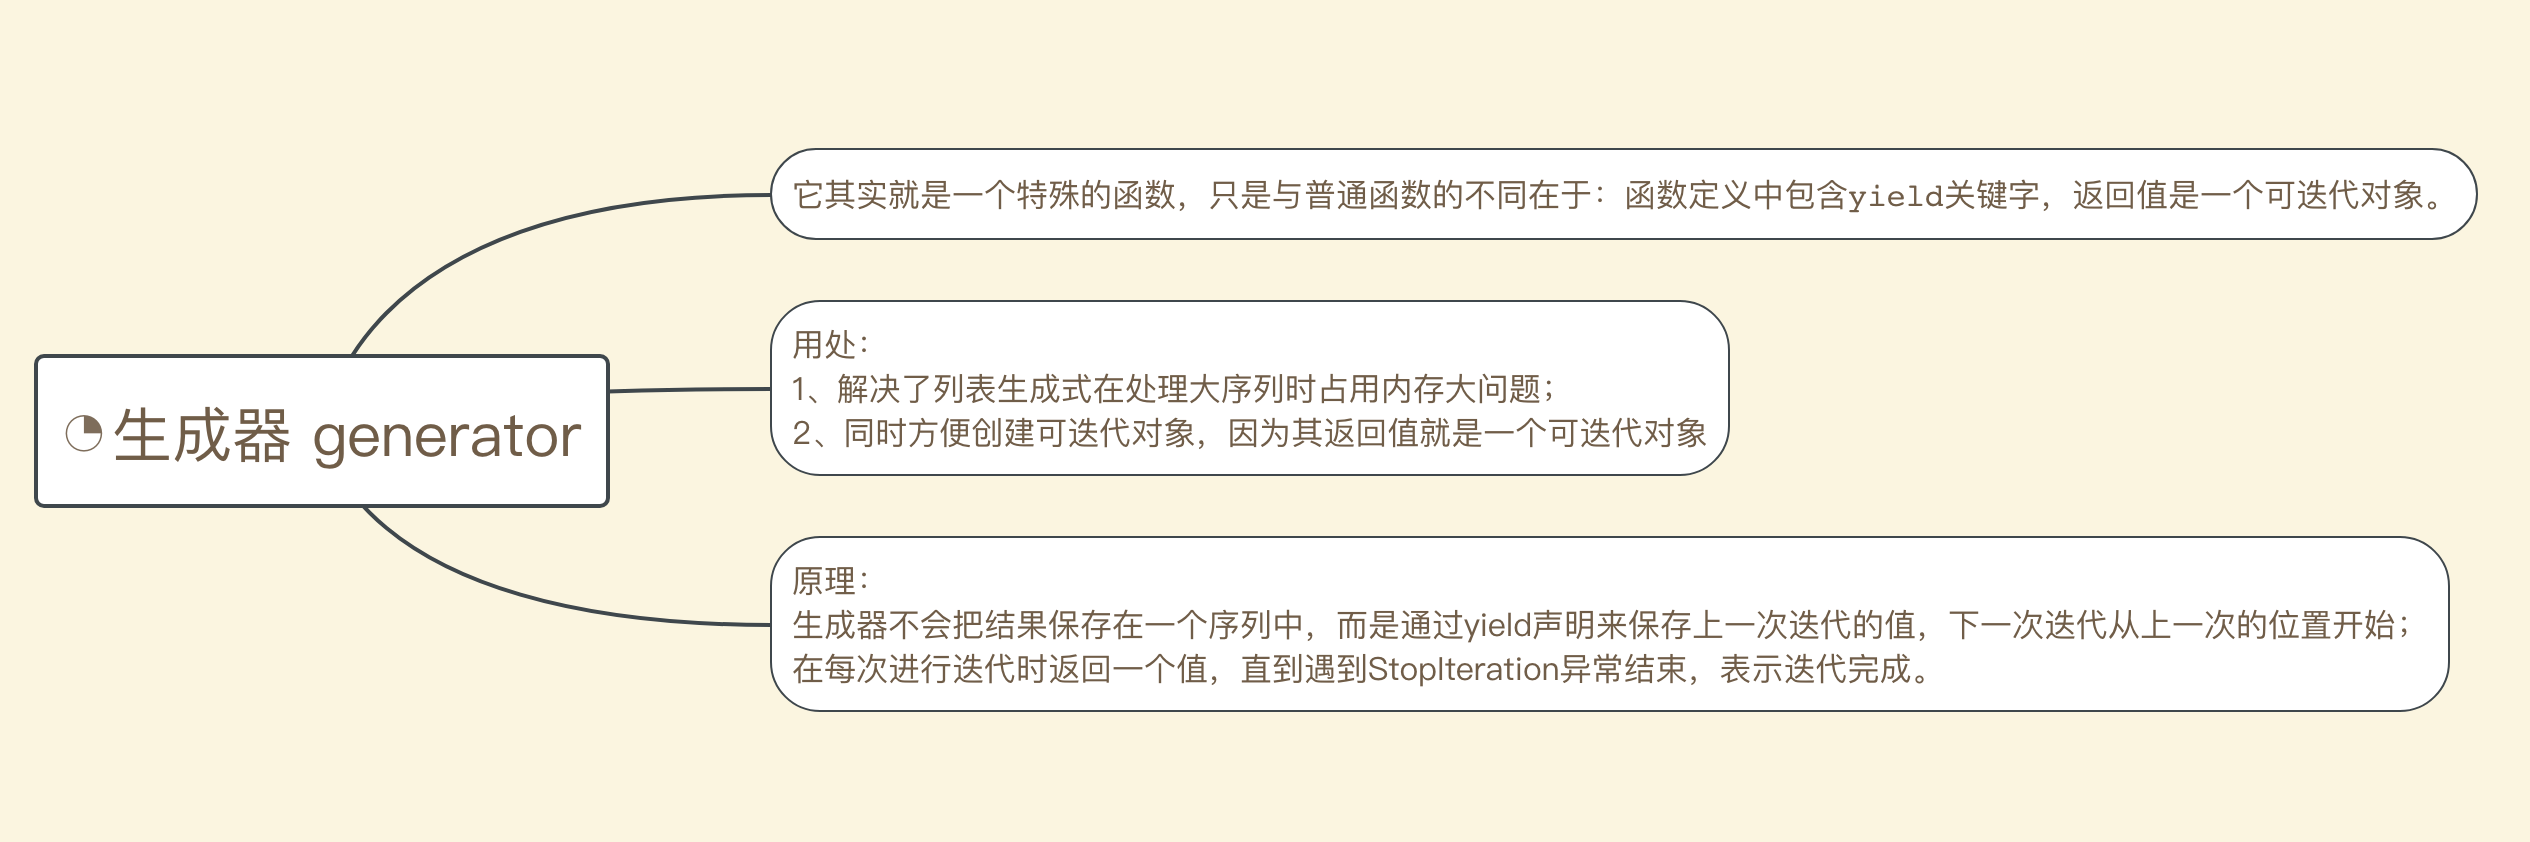
生成器是我觉得 Python 最值钱的特性之一。它按需产出值,不把结果一次性堆在内存里。处理几个 G 的日志文件时,列表推导式会直接把内存打满,换成生成器表达式(把方括号换成圆括号)就稳稳跑完。
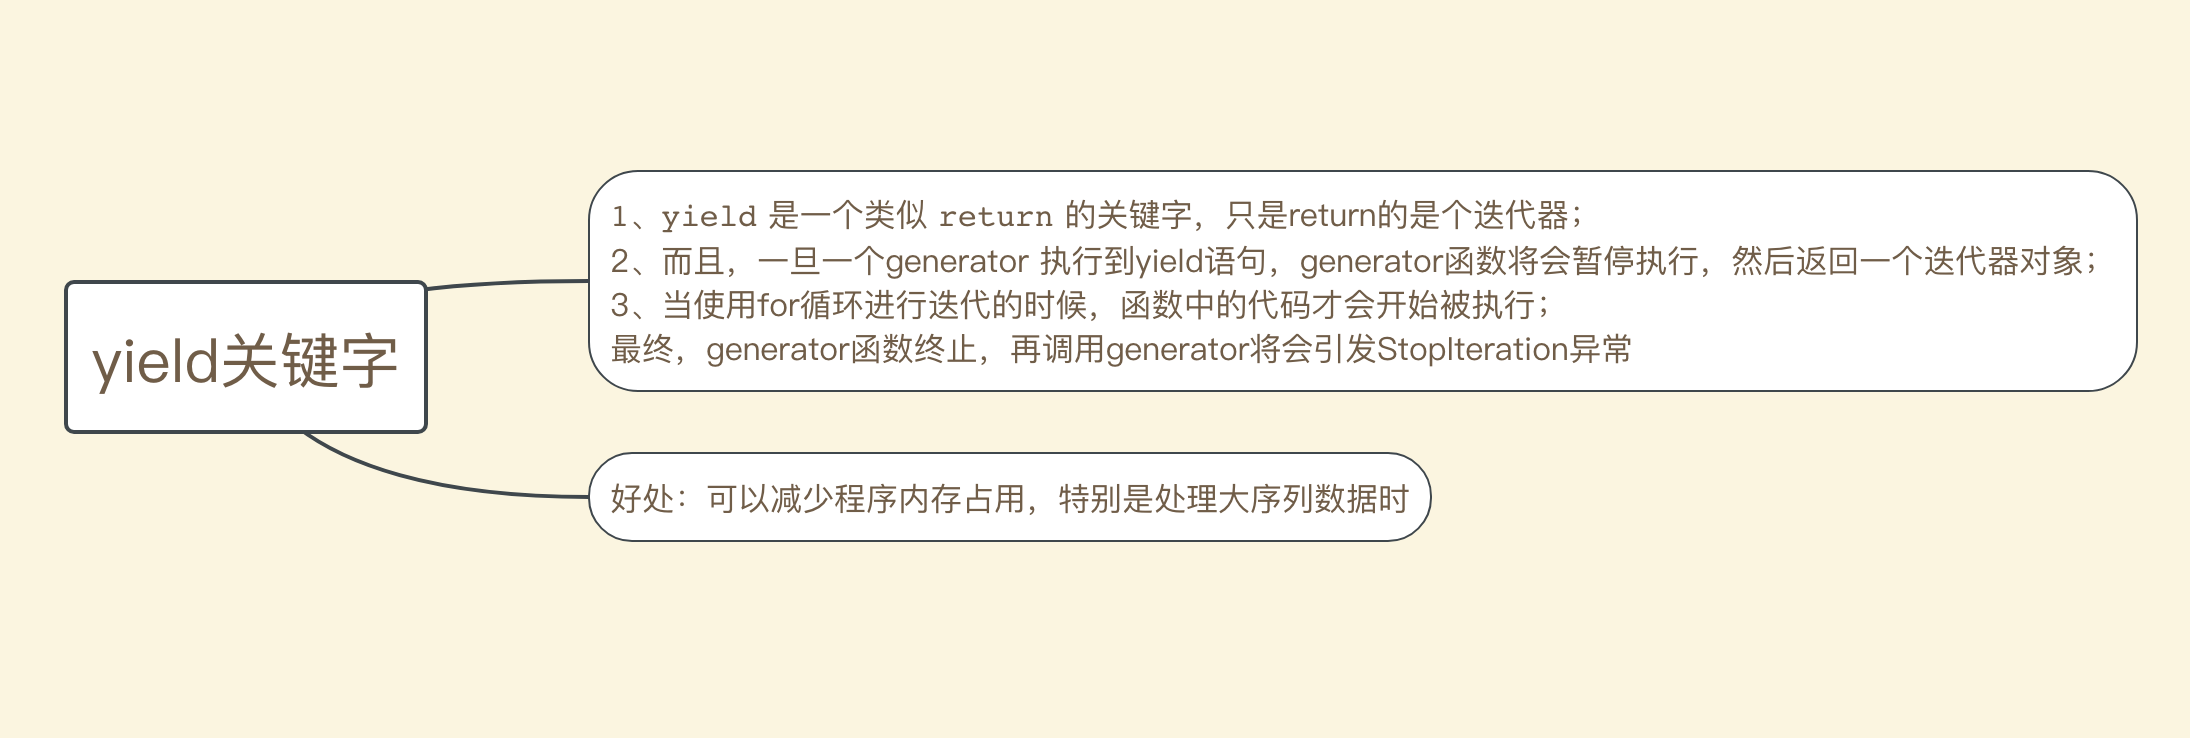
函数里只要出现 yield,它就不再是普通函数,调用后返回的是生成器对象,函数体一行都没执行。每次 next() 才往下跑到下一个 yield 处暂停,把当前状态原地冻结。这个「能暂停能恢复」的能力,后来直接长成了 Python 的协程和 async/await。
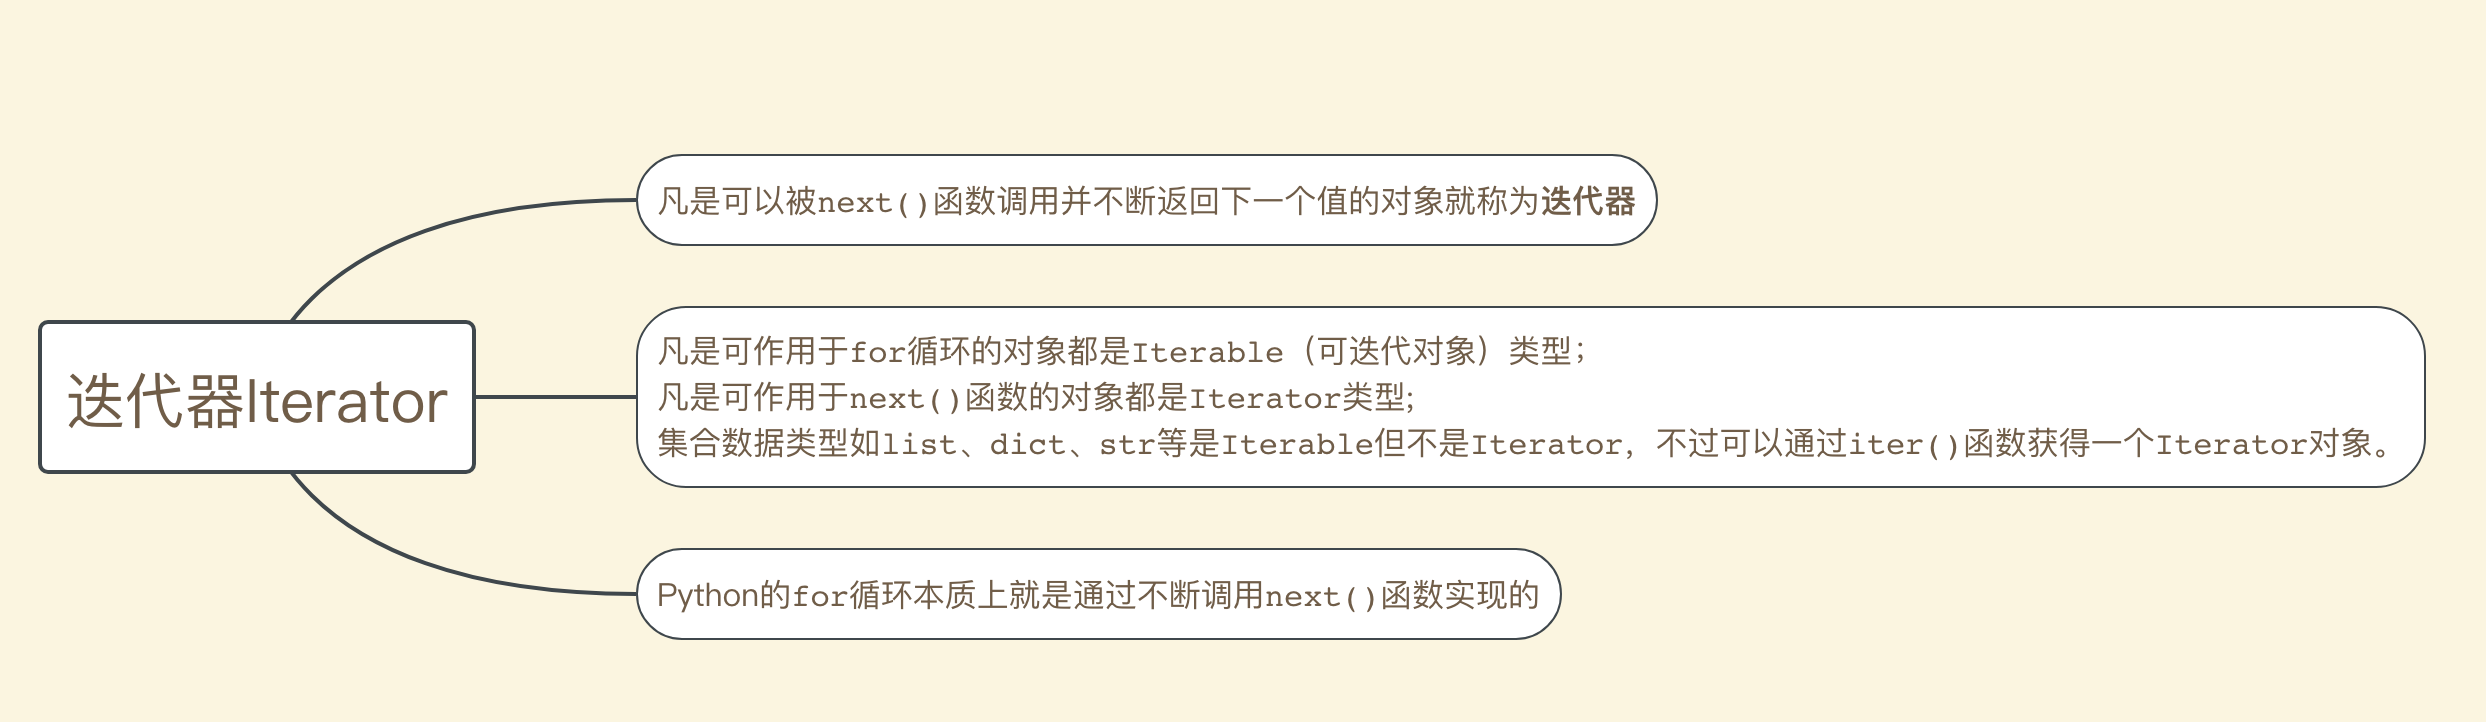
迭代器和可迭代对象要分清。可迭代对象能生成迭代器,迭代器自己带 __next__,能被 next() 推着走。列表是可迭代对象但不是迭代器,iter(列表) 之后才是。生成器则天生就是迭代器。
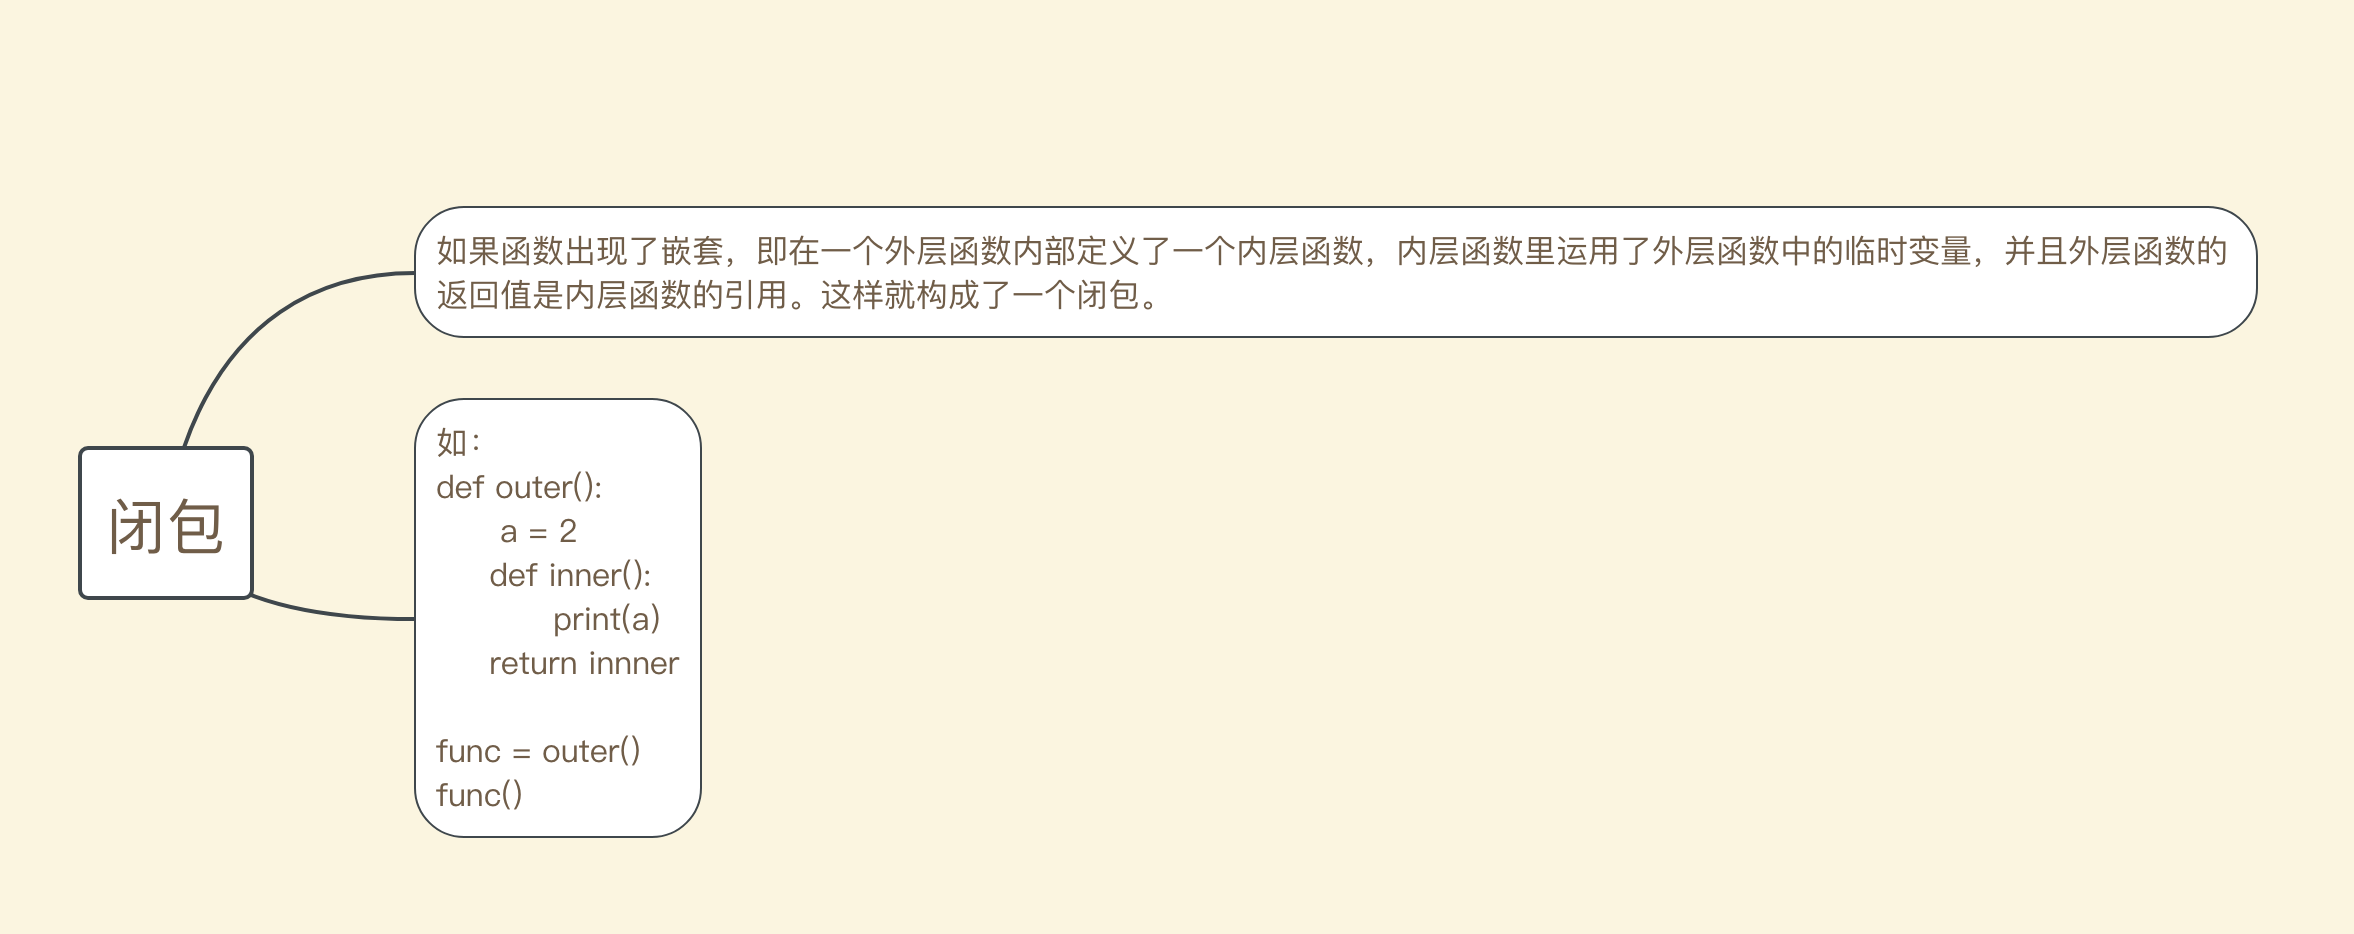
闭包是「函数加上它捕获的外层变量」。内层函数引用了外层函数的局部变量,外层返回内层之后,那个变量不会随着外层退出而销毁。要在闭包里修改外层变量得加 nonlocal,要改模块级变量得加 global,不加的话赋值会被当成新建局部变量。
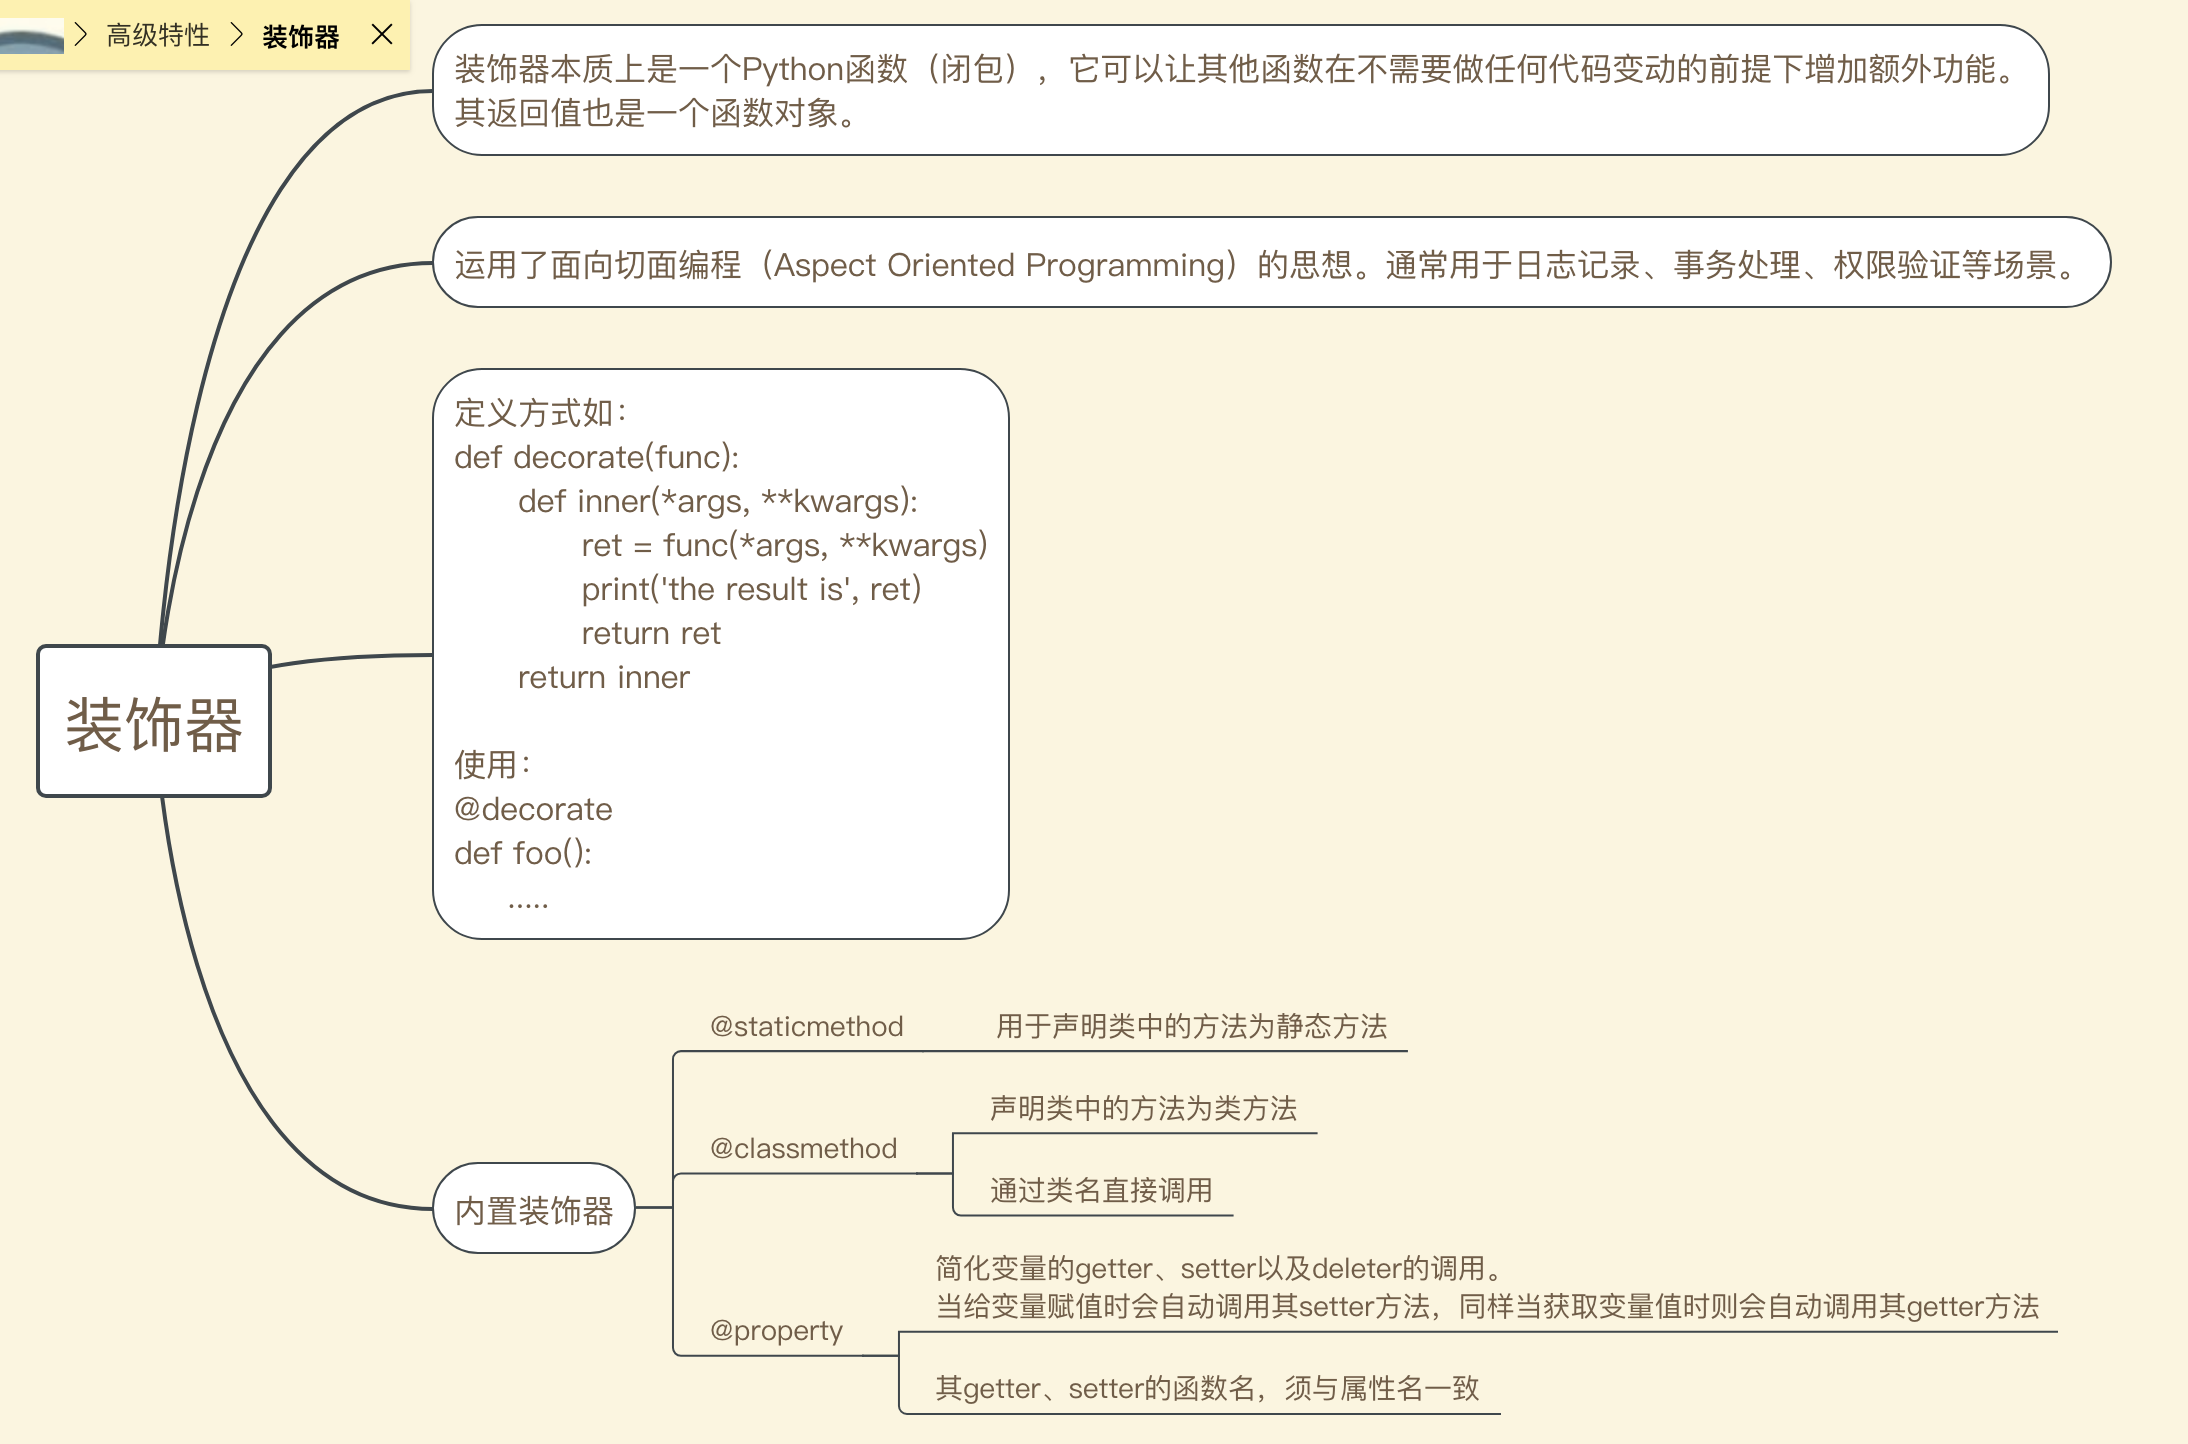
装饰器就是闭包的一个应用。它接收一个函数、返回一个新函数,@decorator 只是 f = decorator(f) 的语法糖。日志、计时、权限校验、缓存这些横切逻辑都适合往这放。
写装饰器时记得加 functools.wraps,否则被装饰函数的 __name__ 和文档字符串会被替换成内层 wrapper 的,调试和自动生成文档时会很难受。这块我一开始也没在意,直到用 Flask 注册路由时撞上重名报错才明白它的必要性。
# 五、自带模块
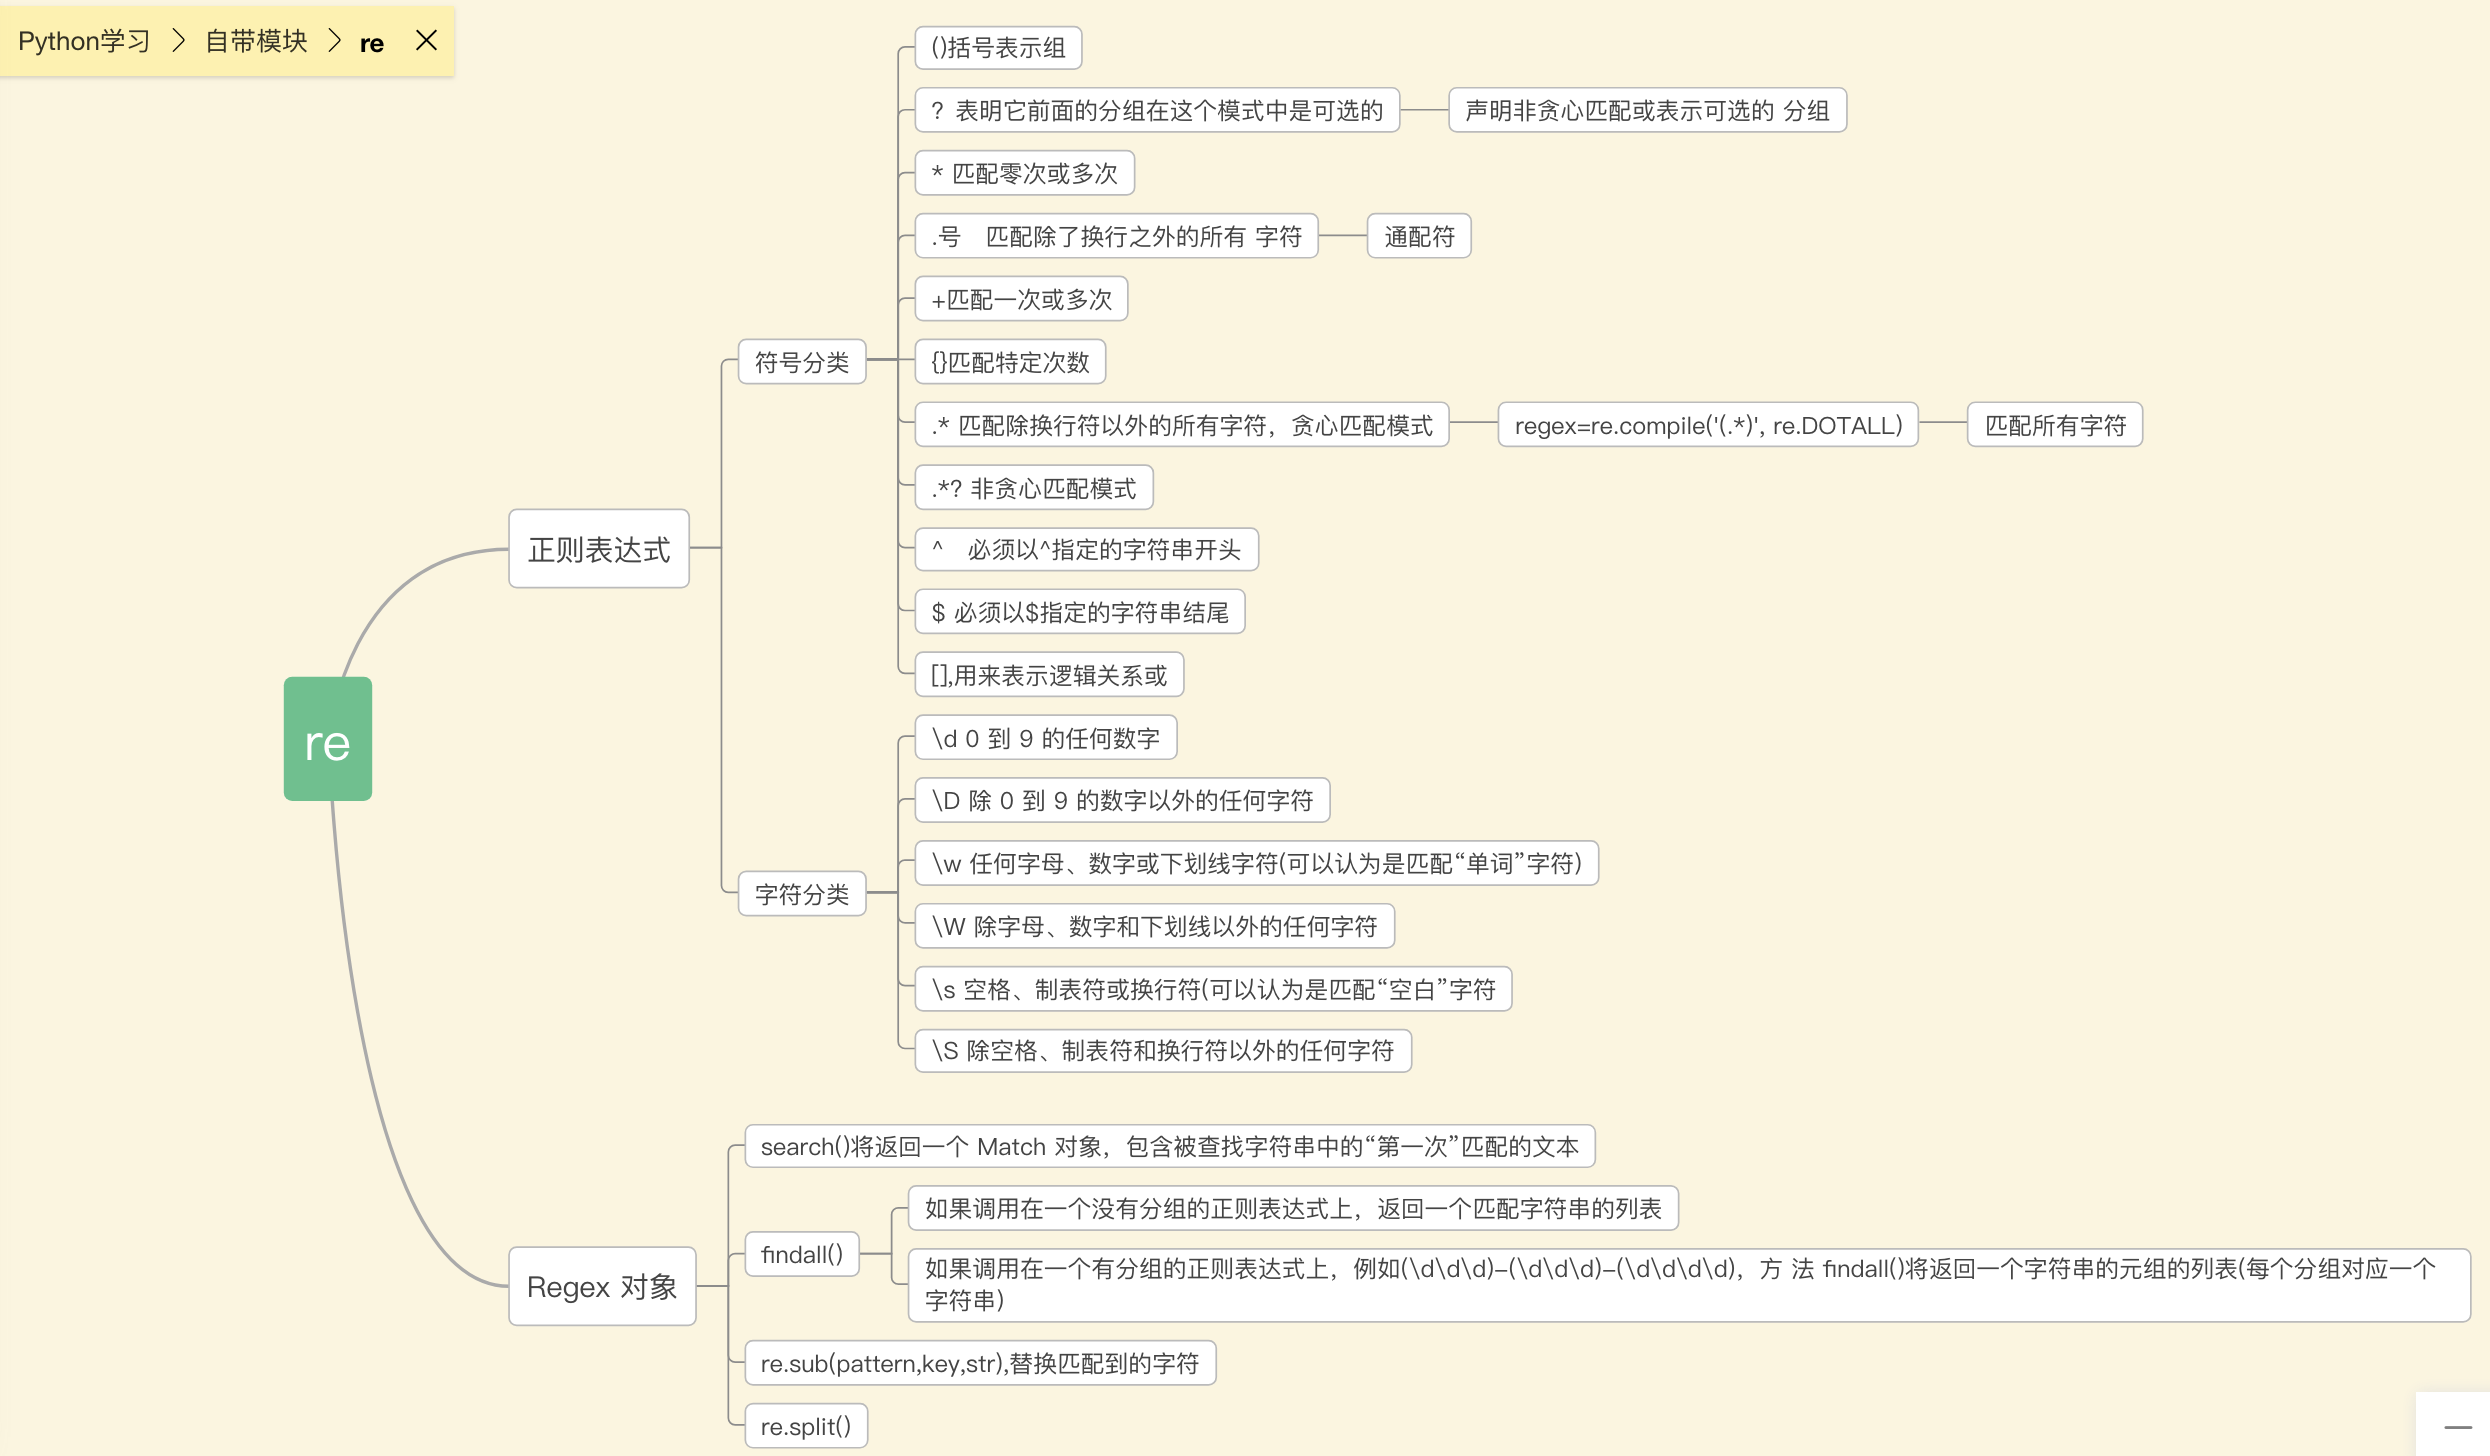
Python 常被说「自带电池」,指的就是标准库的覆盖面。
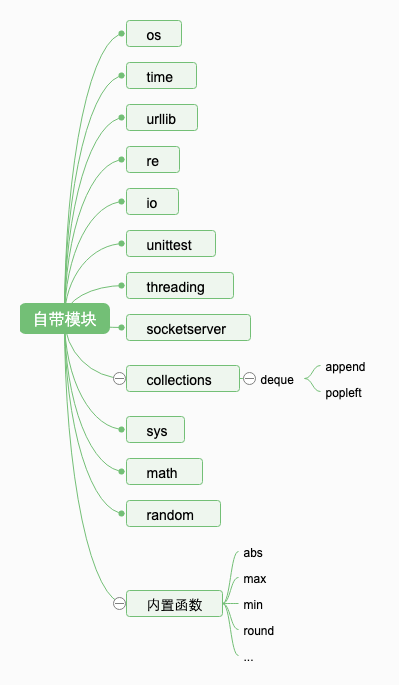
这张图是个目录,重点看下面几个高频的。
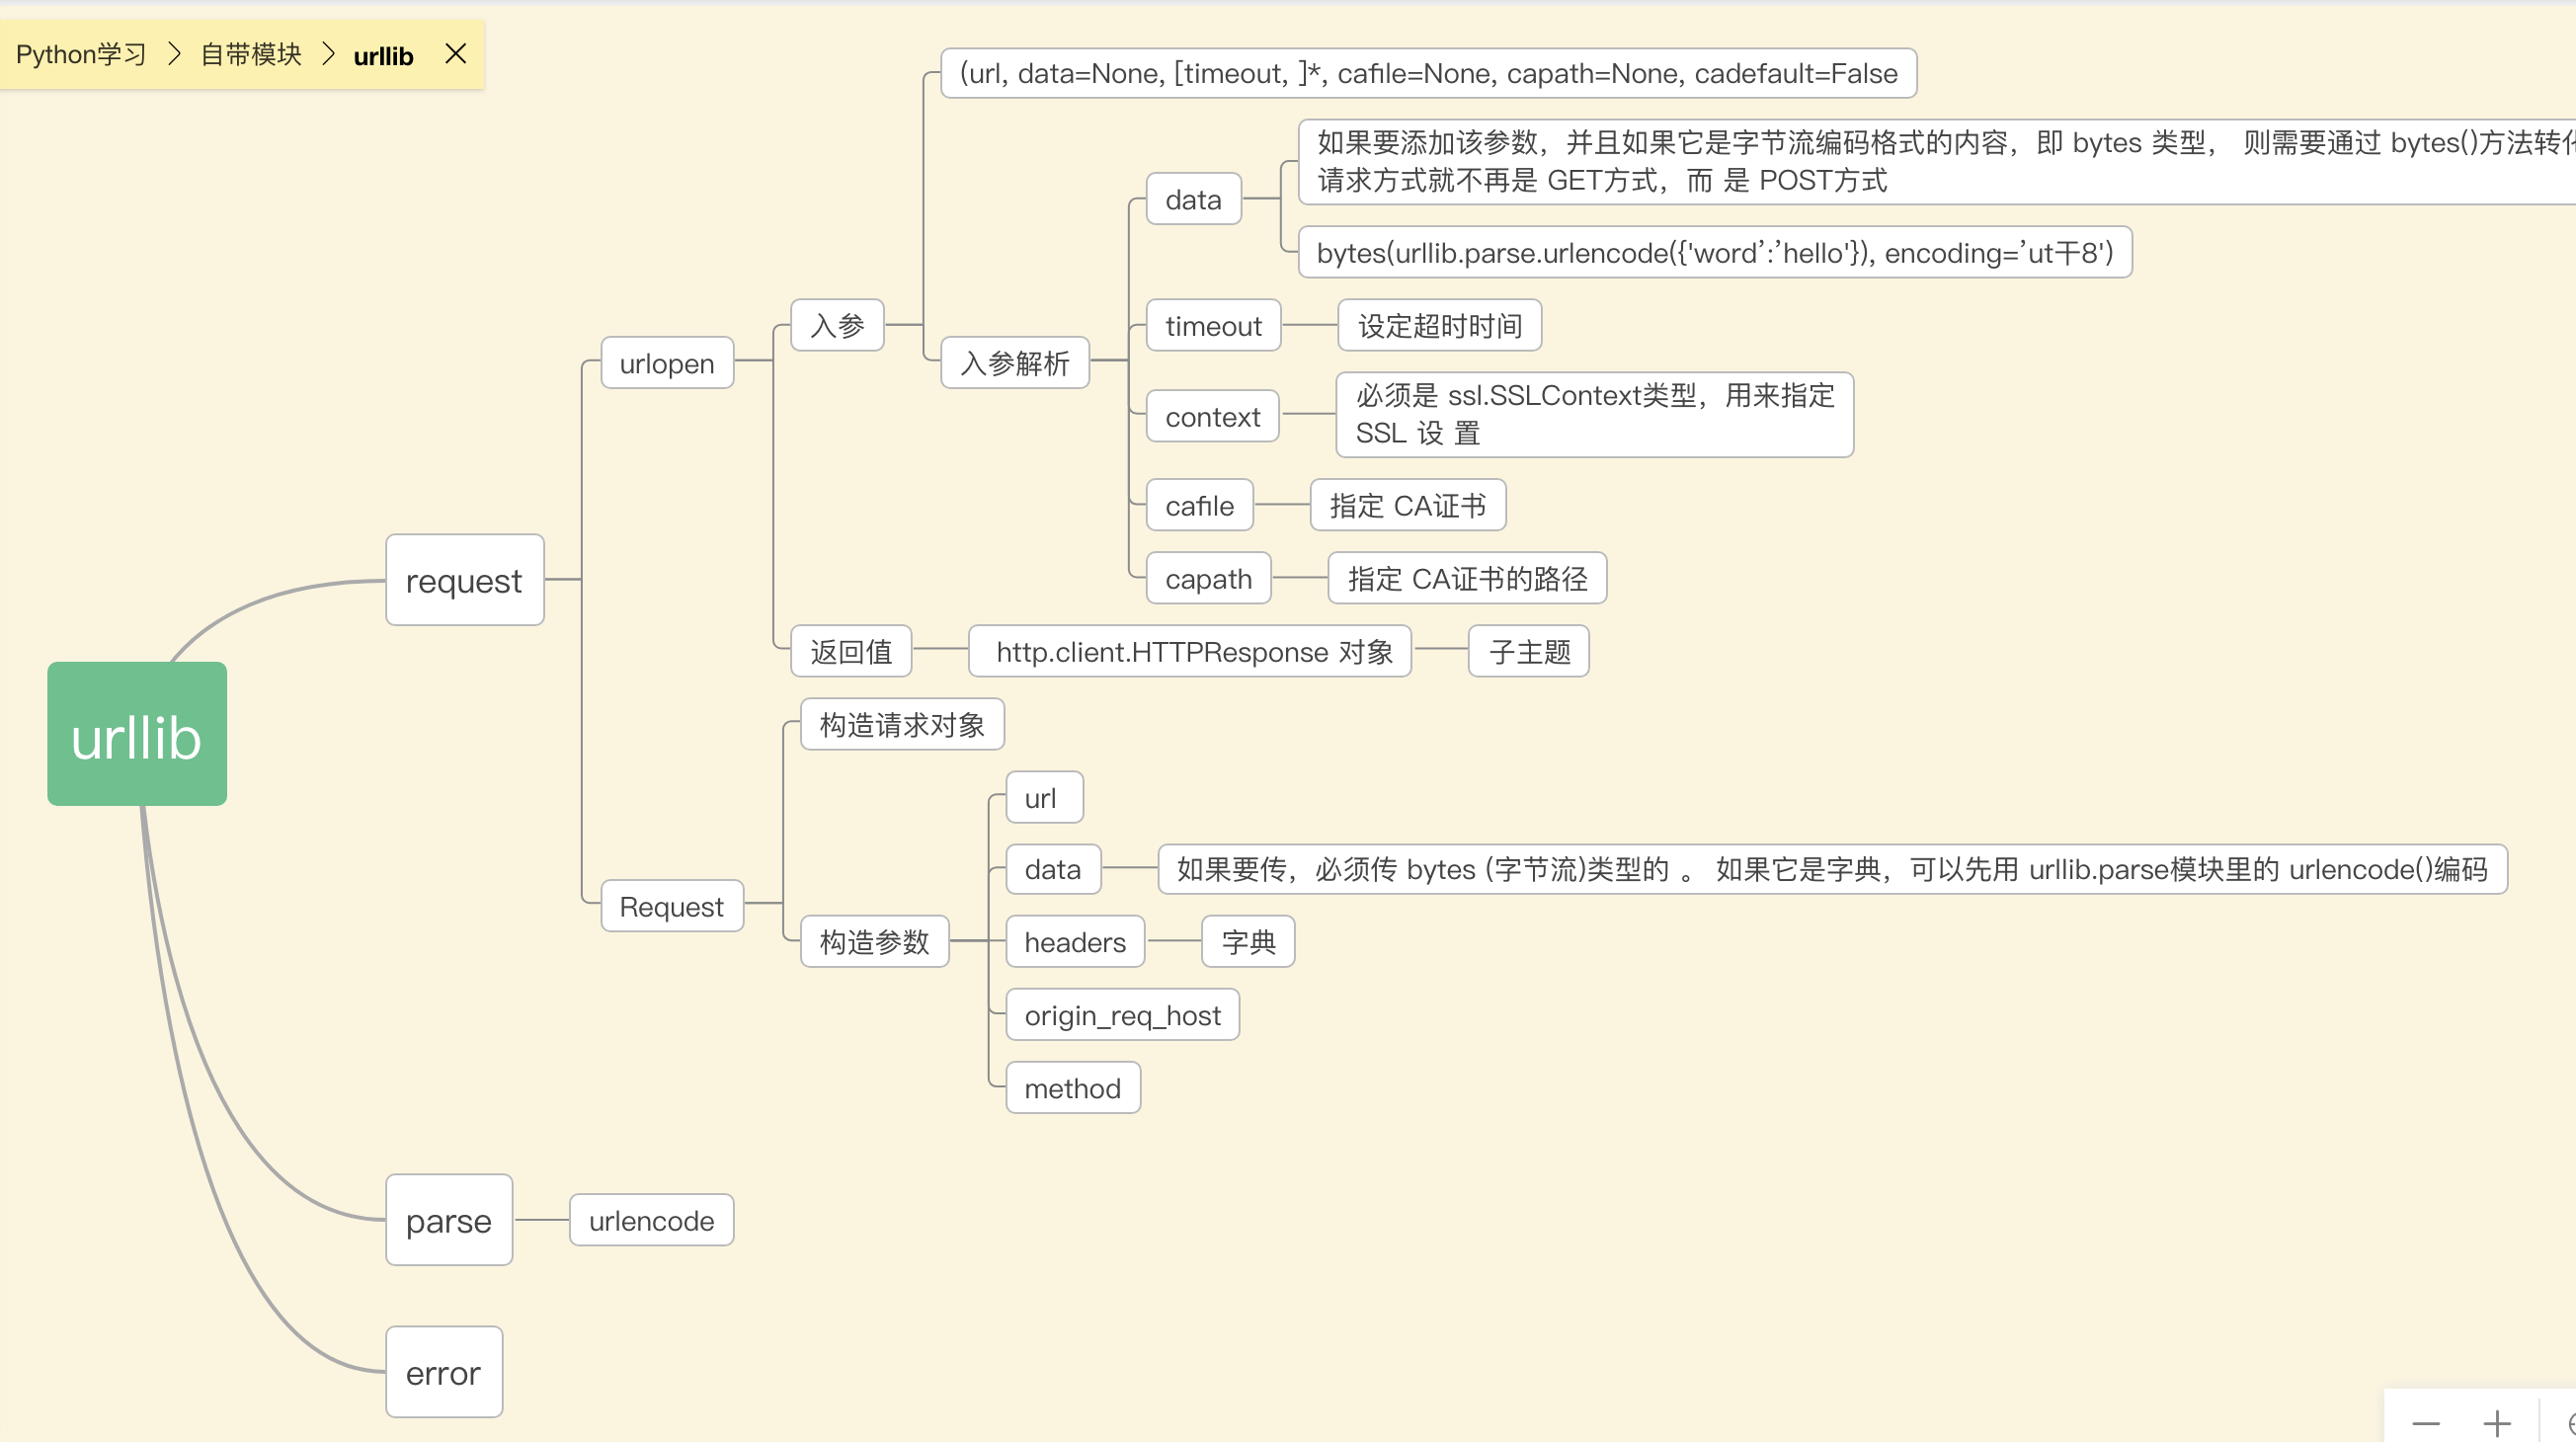
urllib 是标准库里的 HTTP 客户端,不用装第三方包。它够用但接口偏底层,写 POST、带 header、处理 cookie 都比较啰嗦,所以实际项目里大家基本都换成 requests。想零依赖跑个脚本,urllib 还是首选。